Хотите собирать данные из Instagram для анализа конкурентов, поиска блогеров или отслеживания трендов? Вместо ручного копирования каждого поста можно автоматизировать этот процесс с помощью веб-скрапинга и сразу выгружать структурированные данные в форматы JSON, CSV или Excel.
В этой статье подробно рассмотрены все способы сбора данных из Instagram — от ручной выборки, открытых библиотек и специализированных API-сервисов до разработки собственного парсера на Python, а также правила безопасной работы с несколькими аккаунтами без риска получить ограничения платформы.
1. Что такое парсинг Instagram и какие данные можно собирать?
Если вам требуется узнать периодичность публикаций конкурентов, выявить набирающие популярность хэштеги или оценить вовлеченность аудитории инфлюенсера, скрапинг Instagram автоматизирует получение этих сведений. Программа обращается к публичным страницам социальной сети, извлекает необходимые поля и формирует структурированные файлы JSON, CSV или Excel для последующего анализа.
Важно понимать разницу между веб-скрапингом и официальным Instagram Graph API. Graph API представляет собой официальный инструмент Meta и открывает доступ к метрикам только тех бизнес- и авторских аккаунтов, которые напрямую выдали соответствующие разрешения. Скрапинг же ориентирован на извлечение открытой информации из профилей, лент хэштегов и Reels для внешнего анализа рынка и бенчмаркинга.
Какие данные доступны для сбора?
Доступный перечень полей зависит от выбранных инструментов и уровня доступа, но в стандартный набор входят:
| Категория данных | Доступные для сбора параметры |
|---|---|
| Профиль и описание | Имя пользователя, ссылка на аватар, био, внешние ссылки, общее количество публикаций |
| Посты и Reels | Текст подписи, ссылки на фото/видео, дата и время публикации, количество лайков и просмотров |
| Комментарии | Текст комментариев, авторы, отметки «нравится» к комментариям, базовые показатели вовлеченности |
| Хэштеги и рекомендации | Публикации по заданным хэштегам, трендовые посты, выдача вкладки «Интересное» (Explore) |
| Подписчики | Публично отображаемое число фолловеров (выгрузка полных списков строго лимитирована) |
Собранный массив данных выгружается в форматы JSON, CSV или Excel, после чего его удобно загружать в Google Таблицы, Power BI или внутренние корпоративные хранилища.
Подробнее по теме: Руководство по сбору данных со страницы «Интересное» в Instagram: инструменты и советы
2. Ручной сбор данных из Instagram
Ручной ввод — простейший способ зафиксировать базовые метрики, когда нужно оценить всего несколько профилей, публикаций или хэштегов. Этот подход не подходит для масштабных задач, но полезен на стадии начального исследования, так как не требует установки сторонних утилит или написания программного кода.
Перед тем как прибегать к ручному сбору, оцените его плюсы и минусы:
Преимущества
- Полностью бесплатно, не требует установки и настройки программ.
- Доступно для выполнения как с компьютера, так и со смартфона.
- Риск санкций со стороны Instagram практически отсутствует, так как автоматические боты не используются.
Недостатки
- Огромные временные затраты при увеличении числа публикаций.
- Сложность поддержания регулярного и актуального обновления данных.
- Высокая вероятность ошибок и опечаток при ручной фиксации цифр.
Порядок действий
Зафиксировать ключевые показатели вручную можно по следующему алгоритму:
- Откройте целевой профиль, страницу хэштега или Reel.
- Перенесите в черновик текст публикации, число отметок «нравится», комментариев и точную дату выхода.
- Структурируйте записи по столбцам в Google Таблицах или файле Excel.
- Проверьте массив на наличие дубликатов перед построением аналитических отчетов.
Если задача сводится к мониторингу нескольких десятков постов в рамках разового среза, ручной метод остается самым быстрым и экономичным решением.
3. Библиотеки с открытым исходным кодом для парсинга Instagram
Если вы владеете базовыми навыками работы с Python и хотите выстроить собственный пайплайн сбора данных, открытые библиотеки станут оптимальным компромиссом между бюджетом и гибкостью. Вы получаете полный контроль над структурой выгрузки и можете легко интегрировать ее с внутренними аналитическими инструментами.
3.1. Instaloader
Instaloader ориентирован на извлечение открытых данных (профили, посты, ленты хэштегов) без необходимости оформлять платные коммерческие подписки.
Возможности Instaloader:
- Выгрузка открытых профилей
- Сбор медиафайлов постов и Reels
- Парсинг публикаций по хэштегам
- Сохранение сырых ответов в формате JSON
Особенности инструмента:
Плюсы
- Бесплатный инструмент с регулярными обновлениями сообщества.
- Быстрая интеграция в любые Python-проекты.
- Подходит для исследовательских, академических и небольших задач.
Минусы
- Ограниченные возможности при работе с контентом, требующим обязательной авторизации.
- Риск столкнуться с жесткими лимитами запросов (rate limit) при массовом сборе.
Для выгрузки общедоступных данных Instaloader — одна из самых удобных библиотек для быстрого старта благодаря подробной документации и развитому комьюнити.
Порядок работы с Instaloader
Типовой сценарий состоит из нескольких шагов:
- Установите пакет через pip в виртуальном окружении Python.
- Передайте в скрипт целевое имя пользователя или список хэштегов.
- Запустите скрипт для скачивания медиафайлов и сопутствующих данных.
- Преобразуйте полученные данные в единый файл JSON или CSV.
После выгрузки датасет можно нормализовать и перенести в Excel или Power BI для визуализации.
3.2. instagrapi / aiograpi
Когда требуется извлекать расширенные параметры — списки подписчиков, подписок или ветки комментариев, — библиотеки instagrapi и ее асинхронный аналог aiograpi предлагают более широкий функционал за счет обращения к приватным эндпоинтам мобильного приложения.
Инструмент позволяет собирать:
- Детальные данные профилей
- Списки подписчиков и подписок
- Вложенные ветки комментариев
- Активные и сохраненные Stories
- Подробные метаданные публикаций
Поскольку библиотека работает через внутренние мобильные протоколы, важно сопоставлять ее преимущества с рисками безопасности.
Плюсы
- Доступ к глубоким срезам данных, недоступным через веб-интерфейс.
- Высокая скорость обработки и поддержка асинхронности.
- Удобство масштабирования в автоматизированные цепочки.
Минусы
- Обязательная авторизация под реальным аккаунтом Instagram.
- Высокая вероятность проверок (checkpoints) при нетипичных паттернах запросов.
- Необходимость регулярно обновлять библиотеку вслед за изменениями внутренних API Instagram.
В целом instagrapi подходит для проектов с повышенными требованиями к деталям данных, но требует аккуратного обращения с авторизационными сессиями и расходными аккаунтами.
Порядок работы с instagrapi
Надежная схема работы выстраивается следующим образом:
- Выполните вход с использованием выделенного тестового аккаунта.
- Отправьте запрос к нужному эндпоинту (подписчики, комментарии и т. д.).
- Сохраните полученный массив в файл JSON.
- Очистите и стандартизируйте структуру перед отправкой в рабочую базу данных.
Такой подход обеспечивает глубокий охват данных, однако жесткий контроль стабильности сессии критически важен во избежание блокировок аккаунтов.
4. Готовые сервисы Scraper API для сбора данных из Instagram
Для тех, кто не планирует самостоятельно настраивать и поддерживать парсеры с нуля, практичным выбором станут коммерческие API-сервисы. Их ключевой плюс — решение всех фоновых проблем с ротацией прокси, обходом антибот-защиты и расшифровкой капчи, в результате чего клиент получает готовую структурированную информацию через вызовы API.
4.1. Bright Data
Bright Data — одна из крупнейших платформ, предоставляющая Instagram Scraper API для задач корпоративного уровня. Сервис берет на себя извлечение профилей, постов, Reels, комментариев и хэштегов без необходимости администрировать собственные серверы и фермы прокси.
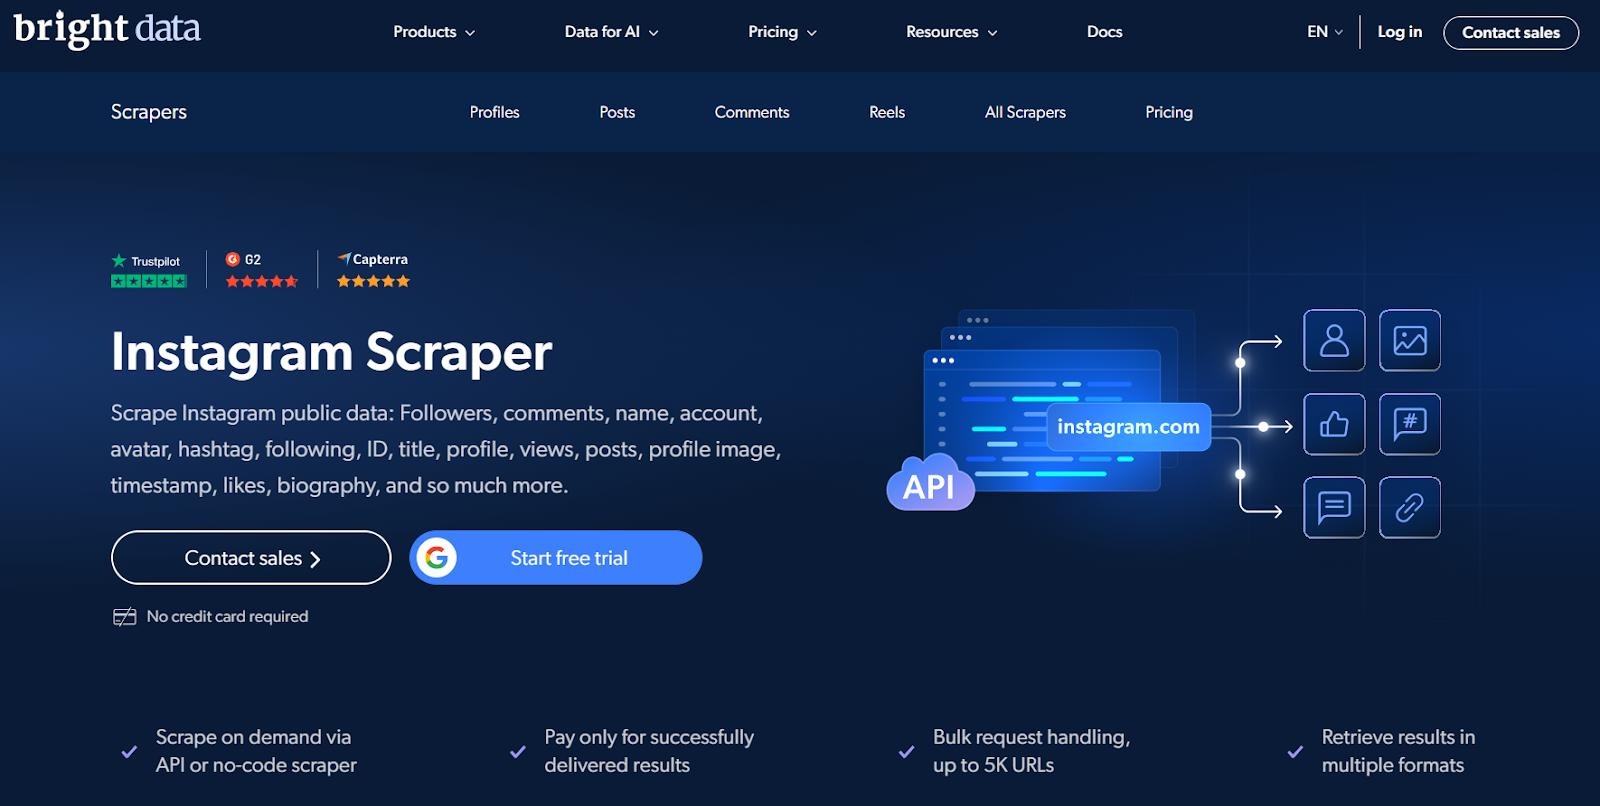
Главные особенности платформы:
- Полноценный охват публичных разделов Instagram.
- Выдача структурированных ответов в формате JSON через REST API или вебхуки.
- Встроенная сеть резидентских прокси для высокой бесперебойности запросов.
- Готовность к обработке масштабных объемов данных с параллельным выполнением потоков.
На что обратить внимание
- Корпоративная стоимость с оплатой за фактически израсходованные ресурсы.
- Разветвленная линейка тарифов, требующая точного прогноза объемов сбора.
Для масштабного мониторинга брендов или регулярного парсинга тысяч страниц инфраструктура Bright Data оказывается значительно надежнее самописных скриптов.
4.2. Oxylabs
Oxylabs предоставляет специализированный API для парсинга Instagram, ориентированный на прямую интеграцию в корпоративные аналитические базы данных и маркетинговые платформы. В отличие от простых визуальных чекеров, сервис сфокусирован на высокой отказоустойчивости и пропускной способности при высоких нагрузках.
Функционал платформы:
- Сбор данных открытых профилей
- Извлечение публикаций и подборок хэштегов
- Потоковая отдача информации по API
- Опора на глобальный пул резидентских прокси
Плюсы
- Высокий процент успешных запросов с гарантиями корпоративного SLA.
- Простота встраивания в имеющиеся базы данных и хранилища (Data Warehouses).
- Надежная работа при непрерывном круглосуточном сборе информации.
Минусы
- Тарифные планы рассчитаны на крупные бюджеты.
- Избыточный функционал для небольших периодических задач.
Если вы проектируете постоянный автоматизированный контур отслеживания конкурентов, Oxylabs снимает необходимость содержать штат инженеров парсинга.
4.3. Apify
Apify предлагает концепцию готовых облачных решений, избавляя от ручного кодинга архитектуры парсера. Пользователи выбирают готовые шаблоны (называемые Actors) для сбора профилей, хэштегов, постов или комментариев, получая готовые выгрузки для работы.
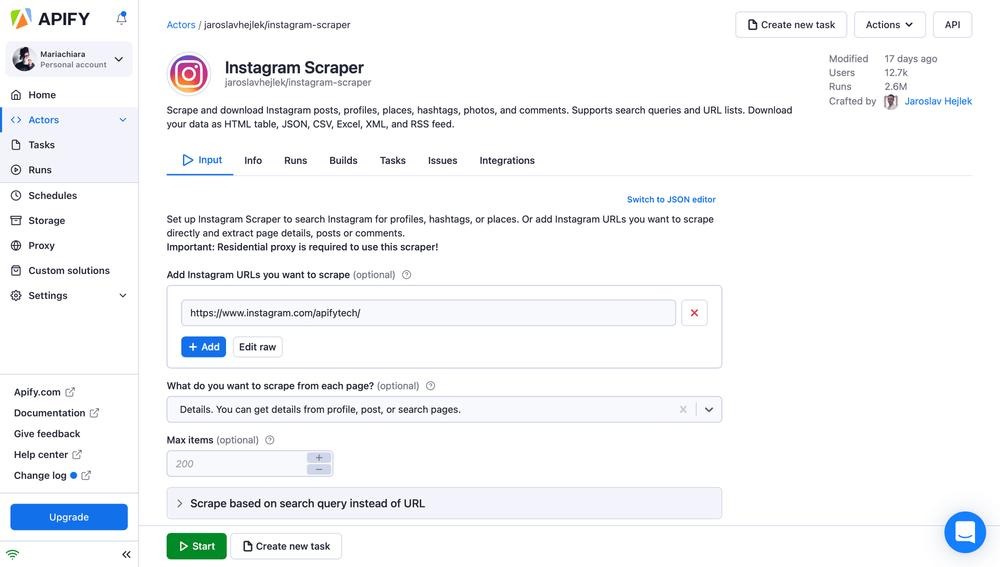
Возможности сбора:
- Публичные профили пользователей
- Посты и статистика видео Reels
- Контент по хэштегам
- Открытые комментарии
- Экспорт результатов в JSON, CSV или Excel
Плюсы
- Не требует навыков программирования.
- Быстрый запуск пайплайнов через понятный веб-интерфейс.
- Большой выбор выходных форматов для аналитики и CRM.
- Встроенный планировщик регулярных автоматических задач.
Минусы
- Разное качество и стабильность акторов от независимых авторов.
- Для крупных объемов требуется подключать собственные надежные прокси.
- Меньше гибкости в кастомизации по сравнению с собственным скриптом.
Рекомендации по работе
В магазине Apify собрано множество модулей от комьюнити. Всегда обращайте внимание на количество запусков, отзывы и дату последнего релиза выбранного Actor. При массовом сборе привязка качественных резидентских прокси снижает вероятность сбоев.
Для маркетологов и аналитиков без опыта разработки Apify — наиболее доступная точка входа в сферу no-code скрапинга.
4.4. PhantomBuster
PhantomBuster делает акцент на автоматизации процессов лидогенерации в социальных сетях, а не на техническом создании парсеров. Он отлично подходит для регулярного сбора данных с автоматической пересылкой результатов в Google Таблицы или CRM-системы.
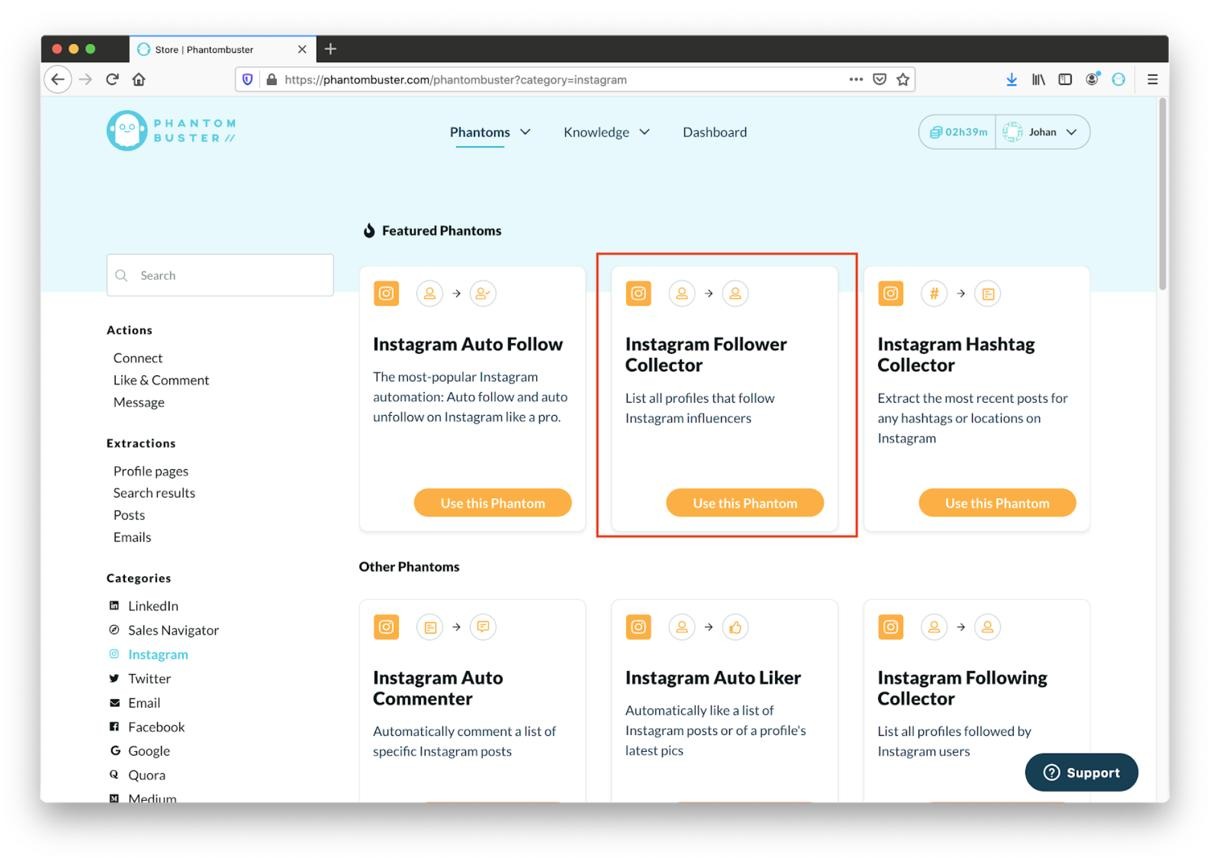
Инструмент позволяет:
- Собирать публичную информацию профилей
- Выгружать комментарии к записям
- Напрямую отправлять таблицы в Google Sheets
- Настраивать автоматический запуск по расписанию
Плюсы
- Полное отсутствие необходимости писать код.
- Быстрая настройка задач через пошаговый мастер.
- Нативная интеграция с популярными маркетинговыми платформами.
Минусы
- Лимиты на общее время работы скриптов в зависимости от тарифа.
- Не подходит для масштабных массивов Big Data.
- Ограниченные возможности глубокой настройки нестандартных полей.
Обратите внимание: Тарификация PhantomBuster привязана к ежедневному времени работы, поэтому задачи лучше дробить на небольшие порции, а не выгружать тысячи профилей за раз. Это экономит лимиты и защищает рабочие профили от санкций платформы.
Для регулярных прикладных задач (мониторинг конкурентов или пополнение базы контактов) PhantomBuster практичнее написания самописного скрипта.
5. Как написать собственный парсер Instagram на Python, Selenium или Playwright
Если готовые платформы не закрывают специфические требования, разработка собственного парсера дает полный контроль над логикой процесса. Этот подход незаменим при нестандартной обработке полей, интеграции с внутренними базами данных или одновременном управлении пулом аккаунтов.
Наиболее популярными библиотеками для этой цели являются Selenium, Playwright и Puppeteer. Они способны эмулировать реальный браузер, переходить по страницам Instagram и точно считывать нужные элементы из DOM-дерева.
Шаг 1. Подготовка рабочей среды
Перед написанием логики настройте стабильное окружение: правильная установка зависимостей избавит от большинства непредвиденных ошибок при исполнении.
Что потребуется:
- Среда выполнения Python или Node.js
- Установленные библиотеки Selenium, Playwright или Puppeteer
- Рабочие прокси (обязательны для многопоточной работы)
- Выделенная папка для сохранения итоговых файлов JSON или CSV
После установки компонентов можно переходить к программному взаимодействию с платформой.
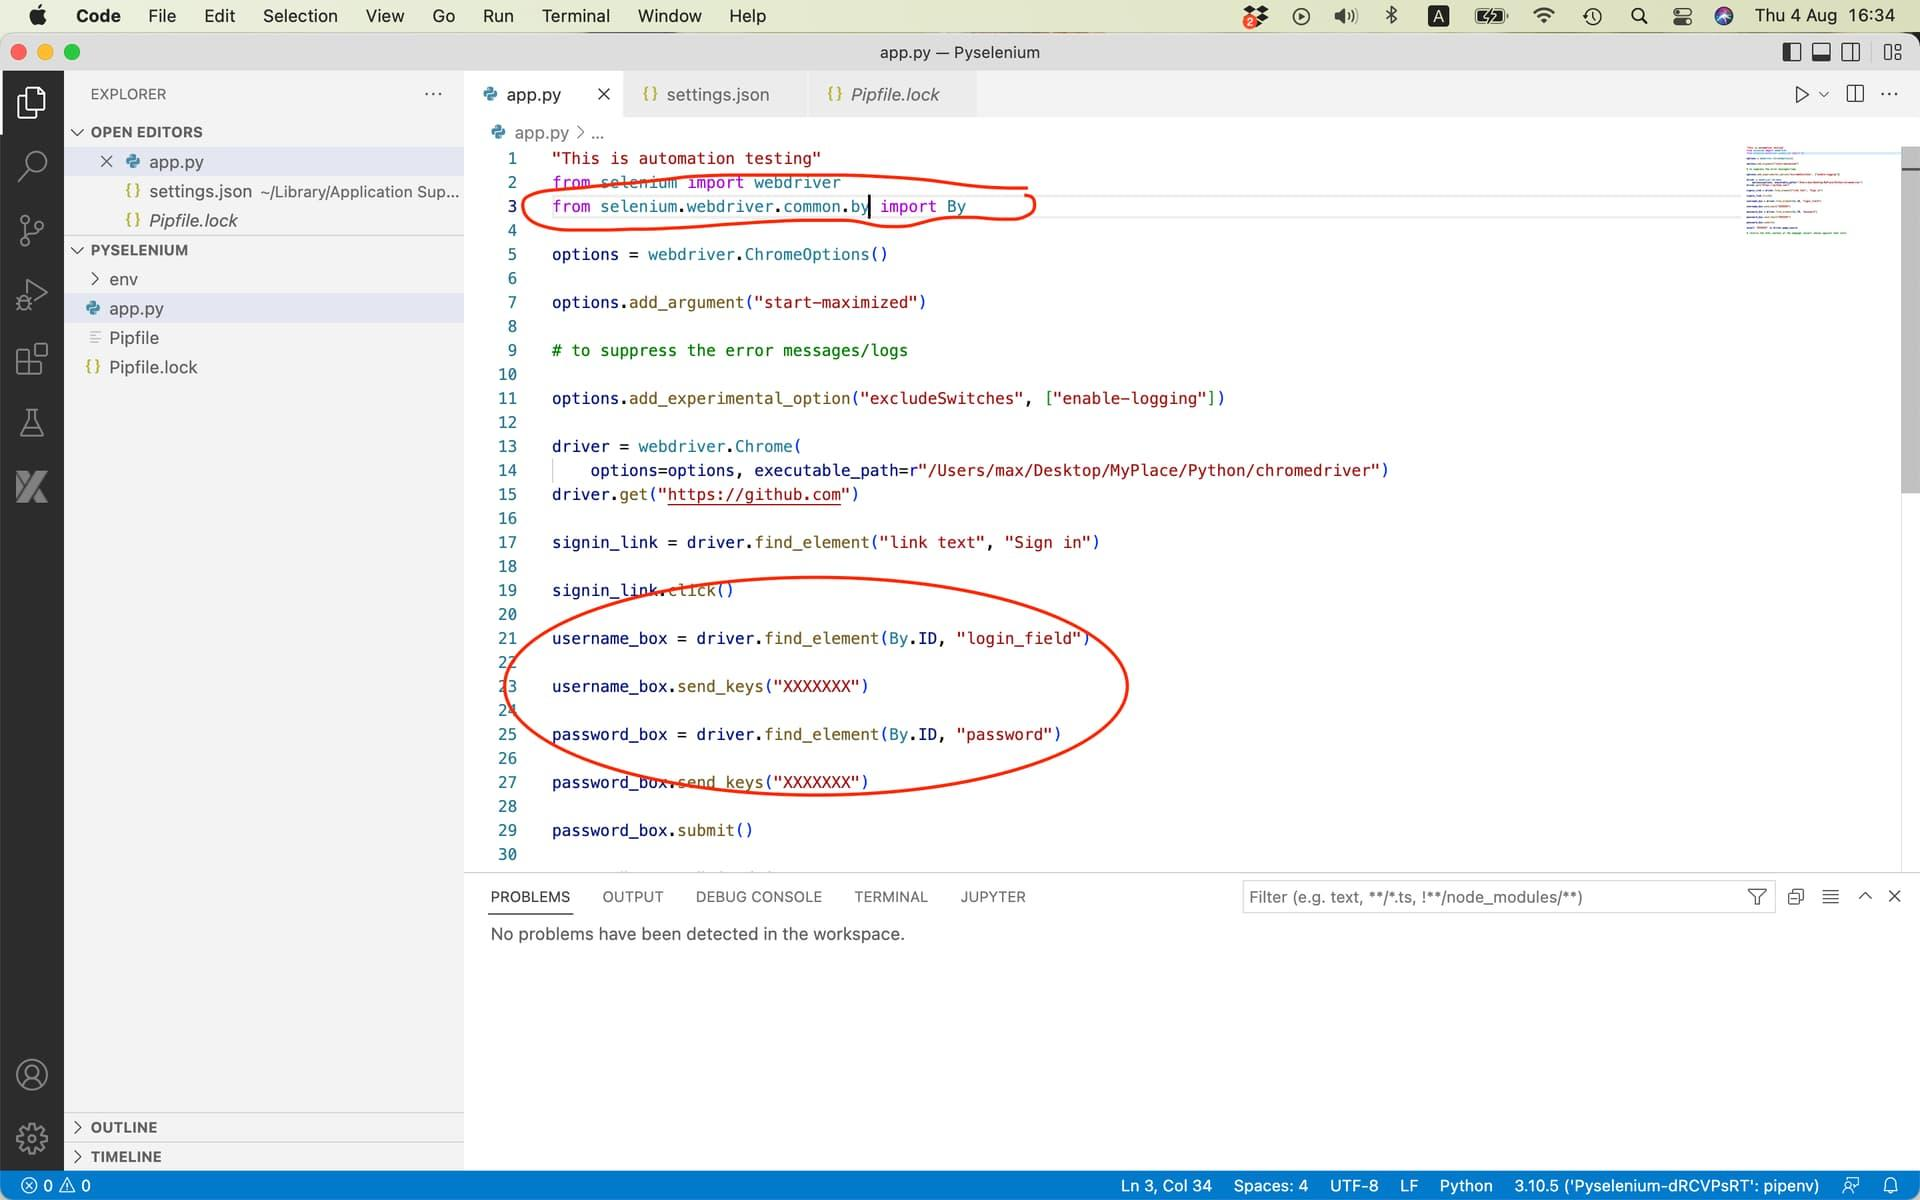
Среда разработки на Python или Node.js с библиотеками автоматизации Selenium, Playwright или Puppeteer.
Шаг 2. Подключение к Instagram
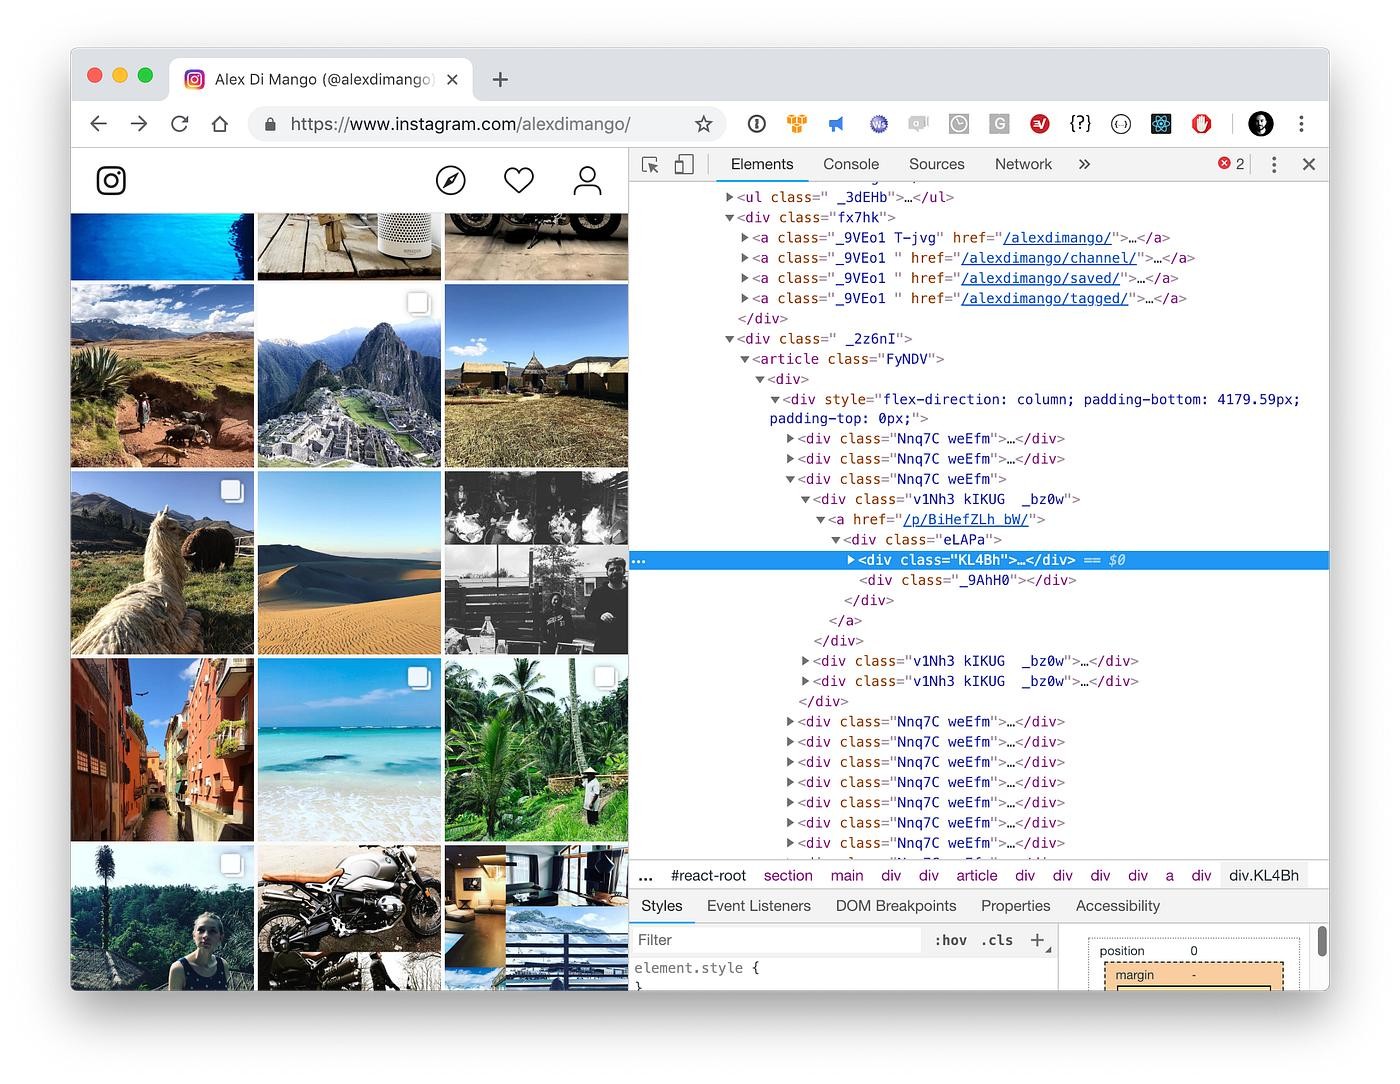
Парсер инициализирует окно браузера и переходит по адресу целевого профиля или хэштега. В зависимости от задачи можно анализировать открытые публикации анонимно либо предварительно авторизоваться для удержания активной сессии.
Базовый порядок действий:
- Запуск экземпляра браузера с настроенным разрешением и User-Agent.
- Переход по URL нужного профиля или хэштега.
- Прохождение авторизации при необходимости доступа к закрытым разделам.
- Использование явных ожиданий (explicit waits) для полной подгрузки динамических элементов DOM.
Ожидание отрисовки предотвращает появление пустых данных, что часто случается с Reels и динамически подгружаемым контентом.
Шаг 3. Извлечение необходимых параметров
После полной загрузки веб-страницы скрипт находит нужные селекторы и формирует из них структурированный объект данных. Набор полей определяется целями анализа.
Стандартные поля для сбора:
- Имя пользователя и никнейм
- Текст подписи к посту
- Количество лайков
- Число комментариев
- Использованные хэштеги
- Время и дата публикации
- Прямая ссылка на пост
Рекомендуется сразу приводить наименования столбцов к единому формату для удобной выгрузки в Excel, Power BI или базы данных.
Шаг 4. Очистка и сохранение в JSON или CSV
Полученный массив перед сохранением необходимо валидировать. Этот шаг определяет корректность всей будущей аналитики.
Этапы обработки данных:
- Удаление дублирующихся записей по идентификаторам постов или URL.
- Приведение дат и часовых поясов к единому формату ISO.
- Фильтрация спецсимволов и проверка корректности кодировки UTF-8.
- Экспорт очищенного массива в файл JSON или CSV.
Итоговые файлы готовы для импорта в Google Таблицы, BI-системы или локальные хранилища.
Шаг 5. Подключение парсера к профилю Hidemyacc
При одновременной работе с несколькими аккаунтами на одном компьютере не следует открывать множество стандартных чистых окон Chrome через Selenium или Puppeteer. Вместо этого парсер подключается напрямую к запущенному профилю в Hidemyacc по протоколу CDP (Chrome DevTools Protocol).
Схема подключения в 3 шага:
- Отправка запроса к Profile API Hidemyacc для запуска профиля по его ID.
- Получение удаленного отладочного адреса CDP (WebSocket Debug URL).
- Подключение Puppeteer к открытому порту для исполнения скрипта.
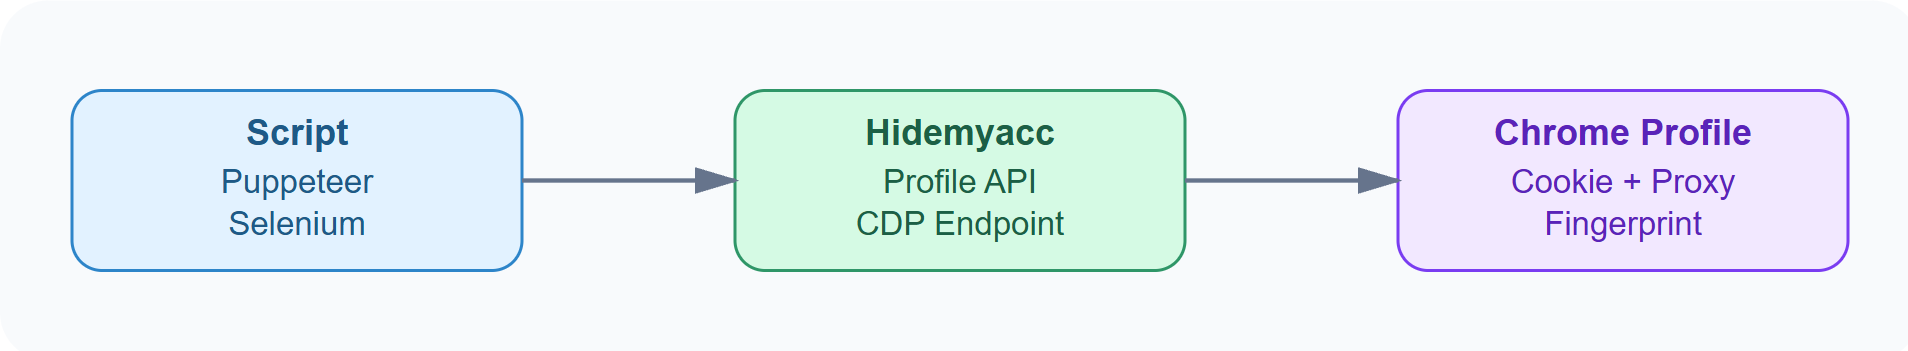
Подключение внешнего скрипта к настроенному профилю Hidemyacc
Вместо создания нового пустого окна Puppeteer перехватывает управление профилем, в котором уже прописаны индивидуальные cookie, выделенный прокси и естественный цифровой отпечаток. Благодаря этому каждый аккаунт изолирован от других, что защищает от перекрестной блокировки сетки.
Пример реализации (Node.js + puppeteer-core):
const axios = require("axios");
const puppeteer = require("puppeteer-core");

async function scrapeWithHidemyaccProfile(profileId) {
  const { data } = await axios.post(
    "http://127.0.0.1:PORT_LOCAL_API/api/v3/profile/start",
    { profile_id: profileId }
  );

  const browser = await puppeteer.connect({
    browserWSEndpoint: data.ws_endpoint,
  });

  const page = await browser.newPage();

  await page.goto("https://www.instagram.com/target_profile/", {
    waitUntil: "networkidle2",
  });

  // Логика извлечения данных

  await browser.disconnect();
}
Приведенный код иллюстрирует подключение скрипта к уже функционирующей среде без создания чистого окна. При параллельном парсинге в несколько потоков каждому профилю выделяется свой порт CDP для предотвращения аппаратных конфликтов.
6. Сравнение способов сбора данных из Instagram
Анализ подходов показывает, что универсального метода под любые масштабы не существует. Для точечных выборок проще использовать ручной способ или no-code сервисы; для регулярного промышленного сбора требуются API-провайдеры либо кастомные парсеры.
| Метод | Затраты | Сложность | Кому подходит |
|---|---|---|---|
| Ручной сбор | Бесплатно | Очень низкая | Небольшие разовые срезы |
| Открытые библиотеки | Бесплатно | Средняя | Python-разработчики, исследователи |
| Коммерческие API | По подписке / за объем | Низкая | Бизнес, отделы маркетинга |
| Собственный парсер | Расходы на разработку | Высокая | Специфические нестандартные проекты |
Правильно выбранный инструмент на старте экономит часы разработки и снижает расходы на серверные мощности по мере роста объемов сбора.
7. Разрешает ли Instagram веб-скрапинг?
Один из самых частых вопросов при организации сбора информации. Если кратко: Instagram не предлагает открытого официального API для произвольного парсинга и активно внедряет системы защиты для пресечения автоматизированного сбора.
Перед развертыванием скриптов важно понимать различие между публичной и конфиденциальной информацией, а также механизмы выявления неестественной активности алгоритмами площадки.
7.1. Условия обслуживания Meta
Компания Meta рекомендует разработчикам задействовать Instagram Graph API для официальных интеграций и работы со страницами Creator и Business. Веб-скрапинг считывает данные непосредственно из визуальной разметки страницы, находясь за пределами регламентированных интерфейсов платформы.
Хотя сбор открытых общедоступных данных подтвержден судебной практикой во многих странах, автоматизация нарушает пользовательское соглашение Meta. Ограничение целей только открытыми данными и контроль частоты обращений снижают юридические и технические риски.
7.2. Открытые и приватные данные
Далеко не любые сведения в Instagram подлежат сбору. Разделяйте поля на две группы:
| Открытые данные (Public) | Приватные данные (Private) |
|---|---|
| Открытые профили и био | Личные переписки (Direct Messages) |
| Тексты публичных постов | Контент закрытых профилей |
| Публикации по хэштегам | Списки подписчиков закрытых аккаунтов |
| Открытые комментарии | Истории «только для близких друзей» |
| Общее число подписчиков | Личные настройки и скрытые адреса почты |
Скрапинг должен фокусироваться исключительно на общедоступных сведениях, не требующих авторизации, тогда как персональные данные защищены системами разграничения доступа.
Почему Graph API недостаточен для исследований рынка?
Официальный Instagram Graph API задуман для управления своими собственными страницами, а не для мониторинга чужих профилей. Из-за этого компании вынуждены совмещать API со скрапингом.
Основные ограничения Graph API:
- Доступ открыт только к данным аккаунтов, лично выдавших авторизацию.
- Невозможно детально анализировать активность конкурентов и сторонних блогеров.
- Жесткие ограничения на поиск по чужим профилям и хэштегам в широких масштабах.
Если цель — отслеживать тенденции рынка и сравнивать показатели конкурентов, парсинг открытых страниц дает намного больше свободы действий.
7.3. Как Instagram вычисляет парсеры?
Заблуждением является мнение, будто одной смены IP-адреса достаточно для сокрытия автоматизации. Алгоритмы платформы оценивают целый комплекс параметров для проверки естественности сессии.
Факторы выявления ботов:
- Ограничение частоты запросов (Rate Limit): Порог на число обращений за промежуток времени. Попытка отправить серию запросов за доли секунды ведет к временной блокировке IP или сбросу сессии.
- Капчи и контрольные проверки (Checkpoints): Активируются при неестественных скачках активности или входе с подозрительного устройства.
- Поведенческий анализ: Отслеживание плавности скроллинга, интервалов между нажатиями и реакций на элементы страницы для отсева скриптов.
- Репутация IP-адреса: IP дата-центров вызывают подозрения сразу, в то время как чистые мобильные и домашние провайдеры обладают максимальным кредитом доверия.
- Цифровой отпечаток браузера (Browser Fingerprint): Сверка User-Agent, Canvas, WebGL, установленных шрифтов, языка и параметров экрана на предмет логических противоречий.
Вместо погони за скоростью сбора важнее распределять нагрузку, рандомизировать паузы и держать параметры профиля стабильными, защищая аккаунты от Action Block и чекпоинтов.
8. Как собирать данные из Instagram с минимальным риском блокировок
Качественный пайплайн сбора отличается долговечностью работы. Большинство блокировок вызвано не ошибками кода, а смешиванием сессий нескольких аккаунтов на одном IP, частыми запросами и постоянной сменой параметров окружения. Соблюдайте следующие пять правил для снижения риска санкций.
8.1. Выделенный прокси под каждую рабочую сессию
IP-адрес — базовый маркер для систем безопасности. Если несколько рабочих аккаунтов обращаются к сайту через один сетевой узел, их профили связываются между собой алгоритмами платформы.
Базовые принципы:
- Один рабочий профиль — один индивидуальный прокси.
- Выбирайте резидентские прокси или мобильные прокси вместо дешевых дата-центр сетей.
- Не допускайте быстрой хаотичной смены IP прямо во время активной сессии.
Сохранение единого географически выверенного IP на протяжении сессии выглядит гораздо более естественно, чем ротация каждые пару минут.
Рекомендуем к прочтению: Топ-6 проверенных провайдеров прокси для Instagram
8.2. Разделение цифровых отпечатков браузера
Даже при чистом IP сайт распознает устройство по его цифровому отпечатку браузера. В него входят десятки значений: User-Agent, Canvas, WebGL, шрифты, язык системы и разрешение экрана.
Гармоничный отпечаток должен сочетать:
- Корректный заголовок User-Agent
- Синхронизированный с прокси часовой пояс
- Языковые заголовки системы
- Характеристики рендеринга Canvas и WebGL
- Правдоподобный набор шрифтов и параметры дисплея
Когда каждый профиль обладает изолированным и правдоподобным набором характеристик, вероятность связать сессии между собой минимальна.
8.3. Распределение задач по изолированным профилям
Попытка вести 5–10 аккаунтов в одном окне Chrome неизбежно ведет к смешиванию файлов cookie, токенов и аппаратных маркеров, что при автоматизации заканчивается банами всей сетки.
Правило изоляции:
- Один аккаунт — один отдельный профиль браузера.
- У каждого профиля свое изолированное хранилище cookie и кэша.
- Индивидуальная привязка прокси к каждому профилю.
- Сохранение неизменных параметров оборудования между входами.
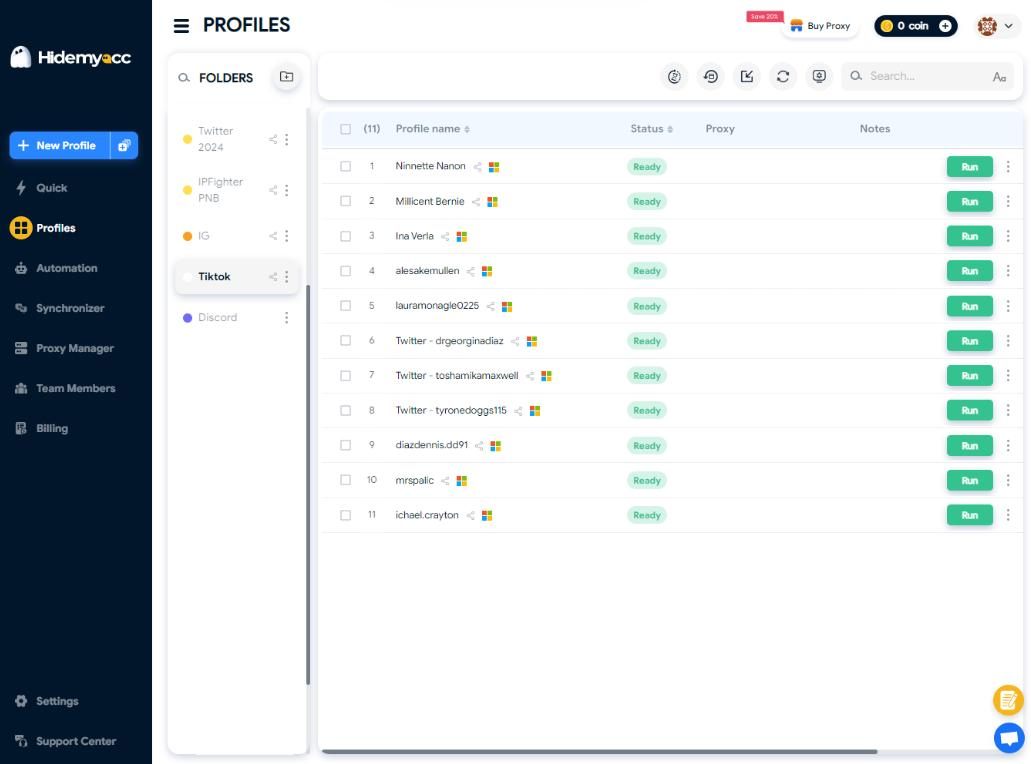
Именно поэтому специалисты используют антидетект-браузер Hidemyacc в связке с Selenium, Playwright или Puppeteer. Вместо запуска скриптом открытых незащищенных окон браузера подключение идет напрямую к профилям Hidemyacc по протоколу CDP, гарантируя автономную изолированную среду для каждого потока.
8.4. Добавление случайных задержек и имитация действий человека
Алгоритмы площадки анализируют не только число обращений, но и ритм действий. Скрипт, мгновенно скроллящий страницы и отправляющий пачки запросов без пауз, ведет себя очевидно для защитных алгоритмов, провоцируя капчи и Action Block.
Очеловечивание сценариев:
- Используйте плавающие случайные задержки вместо жестких фиксированных интервалов.
- Реализуйте порционный скроллинг страницы с паузами для подгрузки элементов.
- Делайте паузы при переходе между разными профилями или вкладками хэштегов.
- Устанавливайте разумный дневной лимит обработанных страниц на сессию.
Снижение скорости сбора увеличивает время работы, но обеспечивает долговечность сессий и минимизирует риски блокировок со стороны Instagram.
Полезный материал: Как исправить ошибку «Мы подозреваем автоматизированные действия на вашем аккаунте» в Instagram
8.5. Отслеживание обновлений разметки DOM и внутренних API
Instagram периодически модифицирует структуру HTML, меняет названия CSS-классов и структуру ответов внутренних интерфейсов. Скрипт, стабильно работавший вчера, после обновления платформы может начать возвращать пустые массивы.
Чек-лист обслуживания:
- Проверка селекторов основных элементов страницы.
- Контроль структуры ответов целевых эндпоинтов.
- Валидация схемы выходного JSON на наличие пропущенных полей.
- Фиксация процента ошибок в логах для своевременного реагирования.
Регулярный аудит кода предотвращает длительные простои контура при обновлениях социальной сети.
9. Типичные ошибки при сборе данных из Instagram
Даже с хорошим софтом процесс сбора может сорваться из-за архитектурных просчетов. Чаще всего к блокировкам приводят следующие ошибки:
- Работа нескольких аккаунтов на одном IP: При одновременной активности с единого сетевого адреса алгоритмы связывают сессии. Каждому профилю нужен свой выделенный прокси.
- Пренебрежение контролем скорости: Отправка десятков запросов за пару секунд кардинально отличается от действий человека. Случайные паузы и порционная обработка данных сохраняют стабильность.
- Игнорирование правил платформы: Ограничивайте сбор открытыми данными для исследовательских задач. Попытки добраться до закрытых профилей многократно повышают технические и юридические риски.
- Контроль работы скрипта без валидации выходных данных: Программа может завершаться без системных ошибок, но записывать неполные тексты или сбитые даты. Обязательно выборочно проверяйте массивы перед отправкой на анализ.
Устранение этих недочетов защитит инфраструктуру и минимизирует вероятность того, что ваши аккаунты Instagram будут заблокированы.
10. Заключение
Парсинг Instagram — эффективный инструмент для извлечения открытой информации под задачи конкурентной разведки, поиска блогеров и оценки трендов. В зависимости от масштабов проекта можно выбрать ручную фиксацию, библиотеки Python, готовые Scraper API или разработать собственный скрипт на базе Selenium, Playwright или Puppeteer.
Однако программный код — лишь часть системы. Для стабильной долгосрочной работы необходимо грамотно администрировать прокси, отпечатки, сессии и следить за частотой запросов. Изоляция рабочих сред в отдельных профилях снижает риск появления Action Block и проверок, гарантируя получение качественных структурированных данных.
При построении сетки сбора данных из Instagram делайте ставку на разделение сред и бережное отношение к лимитам платформы, а не на максимальную скорость выгрузки.
Читайте также:
- Лучшие инструменты для парсинга X (Twitter) для сбора структурированных данных
- Руководство по выбору прокси для парсинга Google: 7 надежных провайдеров в 2026 году
- Инструкция по парсингу LinkedIn для маркетинга и B2B-продаж
- Топ бесплатных AI-инструментов для веб-скрейпинга, на которые стоит обратить внимание
12. FAQ
1. Законно ли собирать данные из Instagram?
Сбор открытых общедоступных данных в сети признан допустимым во многих юрисдикциях, однако автоматизированное извлечение нарушает Условия обслуживания Meta. При сборе открытой информации для маркетинговых или научных исследований важно не выходить за рамки законодательства о защите персональных данных.
2. Можно ли собрать данные закрытого (Private) аккаунта?
Нет. Скрапинг ориентирован исключительно на открытый публичный контент (посты, открытые профили, хэштеги). Закрытые аккаунты защищены авторизацией, и получить к ним доступ без одобрения владельца нельзя.
3. Чем Instagram Graph API отличается от веб-скрапинга?
Graph API — официальный протокол Meta, требующий авторизации через учетную запись и созданный для управления собственными бизнес-активами. Скрапинг считывает данные напрямую из открытой веб-версии, что делает его оптимальным для анализа конкурентов и общего рынка.
4. Приводит ли сбор подписчиков к блокировке аккаунтов?
Да, такой риск есть. Массовый опрос списков подписчиков за короткое время вызывает реакцию антифрод-систем, провоцируя капчи и временные ограничения на действия (Action Block). Для снижения рисков запросы необходимо строго дозировать по времени.
5. Какой инструмент для сбора данных выбрать новичку?
Если у вас нет опыта в программировании, удобнее всего использовать визуальные сервисы Apify или PhantomBuster с готовыми шаблонами и сценариями. Если вы владеете основами Python, библиотека Instaloader станет более гибким и бесплатным решением.