Хотите собирать данные о товарах, ценах, отзывах или продавцах на Amazon, но не знаете, какой метод выбрать? Разработка собственного скрипта дает полный контроль над логикой процесса, тогда как headless-браузеры, официальные API и специализированные сервисы скрапинга закрывают разные эксплуатационные потребности. Ошибка в выборе архитектуры может привести к медленному сбору данных, сложностям с масштабированием или постоянным блокировкам из-за проверок CAPTCHA. В этом руководстве подробно проанализированы основные методы парсинга Amazon, чтобы помочь вам определить оптимальное решение.
1. Что такое парсер Amazon и как он работает?
Парсер Amazon (Amazon scraper) — это скрипт или специализированный инструмент, который автоматически извлекает структурированные данные со страниц маркетплейса, избавляя от необходимости вручную копировать информацию. В зависимости от задач бизнеса вы можете выгружать наименования товаров, коды ASIN, текущие цены, рейтинг, количество отзывов, сведения о продавцах или наличие на складе.
Стандартный цикл сбора начинается с отправки HTTP-запроса на страницу товара для получения HTML-разметки или ответов JSON. Затем парсер находит необходимые элементы с помощью селекторов CSS или выражений XPath, извлекает целевые значения и сохраняет их в структурированные файлы или базы данных для дальнейшего анализа.
К примеру, если требуется ежедневно отслеживать динамику цен по нескольким десяткам позиций, с задачей справится базовый скрипт на Python. Когда же список расширяется до тысяч товаров или возникает потребность в сборе динамического контента, команды переходят на автоматизированные браузеры, официальные интерфейсы или специализированные сервисы Scraper API.
2. Написание собственного парсера с помощью Requests + BeautifulSoup/Scrapy
Если вы владеете Python и хотите полностью контролировать логику выгрузки данных, связка Requests с BeautifulSoup или Scrapy — классическая отправная точка. Вместо запуска полноценного браузера программа отправляет прямые HTTP-запросы по URL-адресам Amazon, получает исходный код страницы и находит в нем нужные блоки информации.
Для стандартной карточки товара базовый скрипт извлечения названия и цены выглядит следующим образом:
import requests
from bs4 import BeautifulSoup

url = "https://www.amazon.com/dp/PRODUCT_ID"

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

# Отправка запроса и получение содержимого страницы
response = requests.get(url, headers=headers, timeout=10)

soup = BeautifulSoup(response.text, "html.parser")

title = soup.select_one("#productTitle")
price = soup.select_one(".a-price .a-offscreen")

print("Товар:", title.get_text(strip=True) if title else "N/A")
print("Цена:", price.get_text(strip=True) if price else "N/A")
Главное достоинство такого решения — абсолютная свобода настройки: разработчик сам определяет правила парсинга, схему предобработки и формат хранения. Стартовые затраты минимальны, поскольку используются общедоступные открытые библиотеки.
Основная сложность кроется в постоянном техническом обслуживании. Amazon регулярно показывает проверочные экраны CAPTCHA, устанавливает ограничения по частоте обращений или обновляет CSS-классы разметки, из-за чего жестко заданные селекторы перестают работать. Кроме того, вам придется самостоятельно настраивать ротацию прокси, подмену User-Agent, обработку сетевых ошибок и логику повторных попыток.
Такой вариант подходит разработчикам, работающим с небольшими или средними объемами данных. Например, специалист по дропшиппингу, которому нужно проверять цены примерно 50 позиций в день, вполне может обойтись собственным скриптом без покупки сторонних подписок.
3. Использование headless-браузеров: Puppeteer, Selenium, Playwright
Далеко не все сведения на Amazon заложены в исходный статичный HTML-код. Определенные блоки требуют выполнения клиентского JavaScript для отрисовки или обновления данных. В подобных случаях автоматизация браузеров с помощью Puppeteer, Selenium или Playwright имеет существенные преимущества перед простыми HTTP-запросами.
Принцип работы повторяет поведение реального пользователя: программа открывает адрес, ожидает завершения асинхронных скриптов и считывает данные из готового интерфейса. На Playwright извлечение рейтинга товара реализуется так:
from playwright.sync_api import sync_playwright

url = "https://www.amazon.com/dp/PRODUCT_ID"

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True)
    page = browser.new_page()

    page.goto(url, wait_until="domcontentloaded")
    page.wait_for_selector("#acrPopover")

    rating = page.locator("#acrPopover").inner_text()

    print("Рейтинг:", rating)

    browser.close()
Преимущество этого метода — способность корректно обрабатывать динамические страницы, прокручивать ленту и взаимодействовать с интерактивными элементами интерфейса (выпадающие списки, модальные окна вариантов). Можно настроить явные ожидания конкретных селекторов, не гадая о тайм-аутах сети.
Взамен браузерная автоматизация расходует значительно больше ресурсов. Одновременный запуск нескольких окон нагружает процессор и оперативную память сервера, а скорость обработки страниц оказывается заметно ниже, чем при прямых сетевых запросах. Кроме того, headless-браузеры передают специфические сигналы автоматизации, которые легко вычисляются системами безопасности Amazon.
Этот способ оправдан, если целевые данные зависят от клиентского JavaScript или сценарий сбора включает сложные пользовательские действия. К примеру, если аналитикам требуется по расписанию собирать отзывы по разным модификациям товаров, Playwright обеспечит стабильный доступ к динамическому контенту.
4. Официальные интерфейсы: Amazon Product Advertising API и Creators API
Если ваш аккаунт соответствует установленным требованиям, получение структурированных каталожных данных через официальный API Amazon станет более надежным решением, чем парсинг верстки. Приложение взаимодействует напрямую с серверной частью площадки и получает проверенные данные.
Этот путь исключает ручной поиск селекторов в коде, решение капчи и переписывание логики при изменениях дизайна маркетплейса. Ответы приходят в формате стандартизированных JSON-схем, что упрощает их обработку во внутренних базах данных.
Тем не менее официальный интерфейс доступен не для каждого проекта. Amazon предъявляет жесткие требования к допуску, показателям конверсий и накладывает ограничения по объему запросов в час. Перед интеграцией необходимо проверить актуальные критерии площадки и доступность требуемых полей.
Стоит также учесть, что Amazon постепенно переводит пользователей с Product Advertising API 5 на обновленный Creators API. Если вы закладываете решение на долгий срок, ориентируйтесь на актуальные технические руководства Amazon, а не на устаревшие инструкции.
Для проектов, имеющих доступ и нуждающихся в стабильном источнике структурированной информации, официальный канал предпочтительнее непрерывного парсинга HTML-страниц.
5. Использование платных сервисов Scraper API
Платные API-сервисы скрапинга созданы для проектов, которым необходим регулярный поток данных из Amazon без затрат на создание и поддержку собственной серверной инфраструктуры. Вместо администрирования прокси, обхода антибот-систем и управления браузерами вы отправляете целевой URL через единый интерфейс и получаете очищенные данные.
У различных поставщиков архитектура различается: одни предоставляют узкоспециализированные готовые эндпоинты под Amazon, другие делают упор на мощные прокси-сети, рендеринг динамических страниц или облачную инфраструктуру. Ниже представлены наиболее востребованные сервисы:
5.1 Bright Data
Bright Data предлагает специализированный Amazon Scraper API, позволяющий выгружать товарные каталоги, поисковую выдачу и отзывы покупателей без необходимости администрировать собственный софт и резидентные прокси. Сервис спроектирован для масштабных корпоративных нагрузок.
Основные возможности:
- Amazon Scraper API: Сбор карточек товаров, цен блока Buy Box, отзывов и поисковой выдачи через стандартные API-запросы.
- Структурированные данные: Выдача информации в виде структурированного JSON, готового к загрузке в аналитические базы.
- Встроенные прокси: Автоматическая маршрутизация трафика через глобальную сеть мобильных и резидентских IP-адресов.
- Web Unlocker: Автоматическое преодоление защитных барьеров, решение CAPTCHA и управление параметрами браузерных отпечатков.
Такой функционал существенно снижает трудозатраты при развертывании крупных проектов по сбору данных.
Преимущества:
- Высокая масштабируемость: Поддержка параллельных потоков и сбор миллионов позиций ежедневно.
- Обширный пул прокси: Надежное глобальное покрытие с геотаргетингом на уровне стран и городов.
- Экономия инженерных ресурсов: Отсутствие необходимости строить собственные системы обхода блокировок.
- Широкий охват параметров: Извлечение данных из карточек, поисковых списков, динамики цен и отзывов.
При этом корпоративный уровень несет за собой определенные компромиссы:
Недостатки:
- Стоимость: Оплата по факту потребления трафика и запросов может оказаться высокой при больших объемах.
- Сложность освоения: Обширная панель управления требует времени на изучение функционала.
- Технические требования: Глубокая интеграция требует навыков работы с API и конвейерами данных.
Bright Data оптимальна для бизнеса, которому нужен регулярный парсинг маркетплейса в промышленных масштабах. Для небольших задач подойдут более простые сервисы.
5.2 Oxylabs
Oxylabs предлагает узкоспециализированный Amazon Scraper API в связке с собственной сетью прокси, закрывая потребности крупного e-commerce бизнеса в регулярном мониторинге данных.
Основные возможности:
- Amazon Scraper API: Сбор товарных позиций, цен, позиций в рекламной выдаче и отзывов по различным региональным доменам.
- Структурированный формат: Выгрузка в готовом формате JSON без необходимости дополнительного разбора разметки.
- Резидентские прокси: Доступ к пулу резидентских IP для отслеживания локальных цен с привязкой к почтовым индексам.
- Адаптивный парсинг: Алгоритмы автоматически подстраиваются под изменения верстки страниц маркетплейса.
Эти характеристики делают сервис востребованным в сфере электронной коммерции:
Преимущества:
- Ориентация на большие нагрузки: Серверная база рассчитана на бесперебойный сбор данных в режиме 24/7.
- Готовое комплексное решение: Прокси и логика сбора объединены в одном продукте.
- Полноценный охват e-commerce: Поддержка органических позиций, спонсорской рекламы и веток комментариев.
- Корпоративные SLA: Высокие стандарты надежности и гарантии успешного выполнения запросов.
Однако существуют факторы, требующие предварительной оценки:
Недостатки:
- Высокий бюджет: Минимальные тарифные планы ориентированы на крупные компании.
- Необходимость интеграции: Для подключения API к внутренним системам требуются навыки разработки.
- Нецелесообразность для микрозадач: Использование платформы для разового сбора нескольких цен экономически неоправданно.
Oxylabs подходит компаниям, которым требуется стабильный сбор данных с гарантией доступности и масштабируемости.
5.3 ScraperAPI
ScraperAPI делает ставку на простоту интеграции, предлагая готовые эндпоинты под нужды сбора данных с Amazon. Сервис возвращает структурированный JSON для поддерживаемых типов страниц, избавляя от ручного разбора HTML.
Основные возможности:
- Product API: Извлечение характеристик товара, спецификаций и данных Buy Box.
- Search API: Парсинг страниц результатов поиска по заданным ключевым словам.
- Offers API: Сбор предложений от сторонних продавцов и условий доставки.
- Reviews API: Выгрузка текста отзывов, рейтинга и профилей покупателей.
- Формат JSON: Готовые ответы для быстрой передачи во внутренние приложения.
Специализированные эндпоинты заметно ускоряют разработку:
Преимущества:
- Быстрое подключение: Интеграция через стандартные запросы REST API за пару часов.
- Отказ от селекторов: Отсутствие необходимости сопровождать собственные селекторы CSS и XPath.
- Хороший охват: Отдельные методы для каталога, поиска, предложений и отзывов.
- Доступность для малого бизнеса: Понятные тарифы, подходящие для стартапов и небольших проектов.
При всей доступности инструмент имеет ряд ограничений:
Недостатки:
- Множители кредитов: Использование структурированных эндпоинтов и JS-рендеринга списывает больше кредитов за запрос.
- Рост расходов: При резком увеличении числа запросов стоимость подписки быстро возрастает.
- Фиксированные схемы: Нестандартные параметры, не вошедшие в базовый JSON, приходится извлекать из сырого HTML вручную.
5.4 Apify Amazon Scraper
Apify предлагает обширную библиотеку готовых скриптов (Actors) под Amazon. Это позволяет собирать информацию без необходимости программировать парсер с нуля, используя как веб-интерфейс, так и доступ по API.
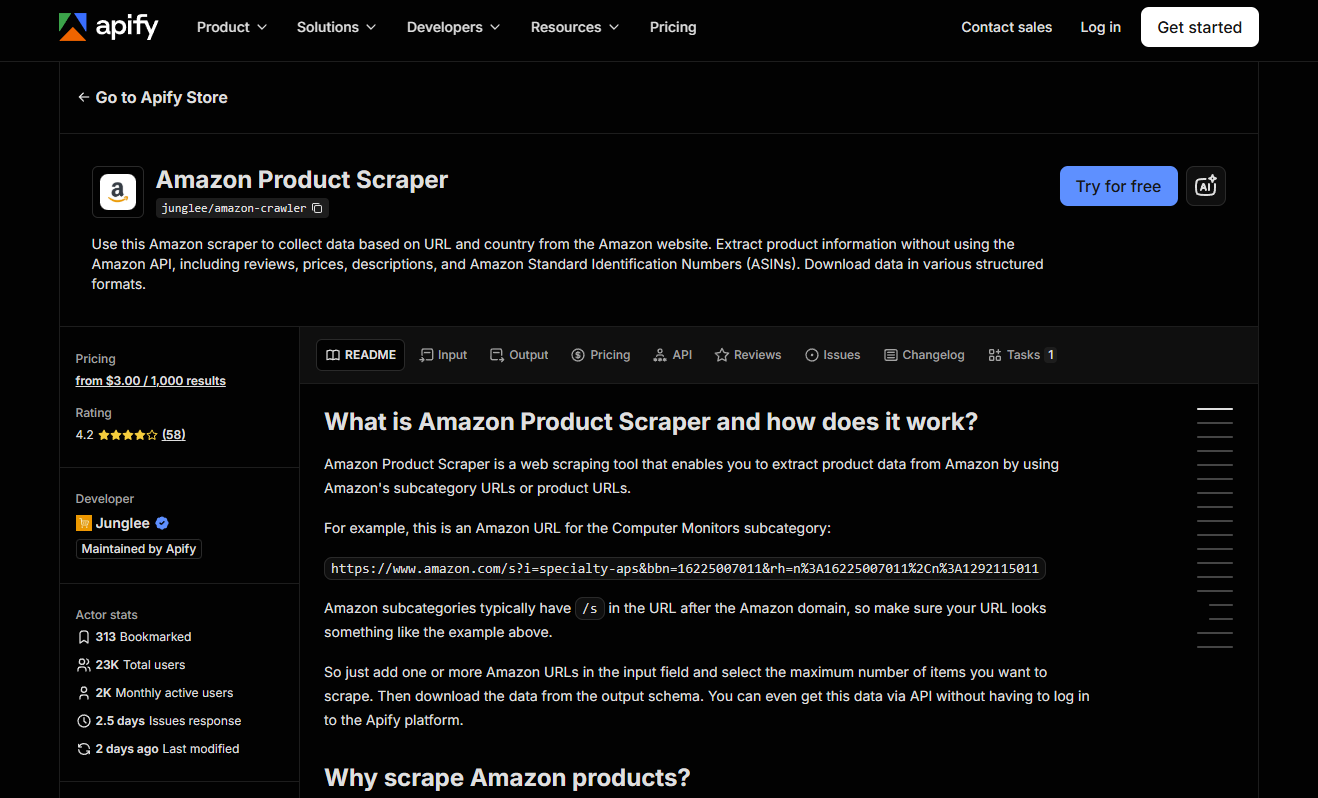
Основные возможности:
- Amazon Product Scraper: Сбор заголовков, вариантов товаров, актуальных цен и описаний по URL.
- Amazon Search Scraper: Парсинг поисковой выдачи по заданным запросам.
- Amazon Reviews Scraper: Выгрузка отзывов реальных покупателей, оценок и прикрепленных медиафайлов.
- API и Webhooks: Программный запуск задач и передача данных во внешние системы.
Гибкость Apify позволяет быстро запустить рабочий процесс на базе готовых шаблонов с последующим переходом к кастомизации:
Преимущества:
- Готовые модули: Существенная экономия времени на старте проекта.
- No-code панель: Возможность запускать парсинг через браузер без написания программного кода.
- Автоматизация по API: Удобная интеграция полученных массивов в облачные пайплайны.
- Разнообразие форматов: Экспорт данных в CSV, JSON, Excel или XML.
Зависимость от шаблонов комьюнити влечет определенные риски:
Недостатки:
- Разное качество модулей: Стабильность работы зависит от регулярности обновлений конкретного автора.
- Чувствительность к обновлениям верстки: Редизайн маркетплейса может нарушить сбор до выхода патча от автора Actor.
- Оплата за вычислительные мощности: Итоговая цена складывается из времени работы серверов и используемых прокси.
Apify удобен для маркетологов, аналитиков и небольших команд, которым нужно оперативно собрать базу без долгой разработки.
5.5 Zyte
Zyte объединяет возможности Zyte API и платформы Scrapy Cloud, ориентируясь на команды, которым требуются индивидуальные схемы сбора. Вместо жестких шаблонов сервис предоставляет разработчикам полную свободу управления логикой парсинга на базе фреймворка Scrapy.
Основные возможности:
- Zyte API: Интеллектуальный шлюз, берущий на себя обход блокировок, ротацию прокси и управление заголовками.
- Scrapy Cloud: Облачная среда для деплоя, планирования и мониторинга краулеров на Scrapy.
- Поддержка динамического рендеринга: Корректная обработка страниц со сложным клиентским JavaScript.
- Индивидуальная логика сбора: Возможность создавать любые собственные правила фильтрации и извлечения полей.
Сервис раскрывает свои сильные стороны в сложных заказных разработках:
Преимущества:
- Глубокая кастомизация: Подходит для сложных нестандартных алгоритмов извлечения.
- Естественная интеграция со Scrapy: Прямая совместимость для команд, уже использующих этот стек.
- Снижение затрат на DevOps: Облачный хостинг избавляет от необходимости поддерживать собственные серверы.
- Перспективы развития: Возможность масштабировать инфраструктуру от точечных пауков до распределенных систем.
Для простых задач платформа может оказаться избыточной:
Недостатки:
- Высокий порог входа: Необходимы уверенные знания Python, Scrapy и архитектуры краулеров.
- Длительный запуск: Разработка собственной логики занимает больше времени, чем обращение к готовому API.
- Нецелесообразность для простых задач: Для разовой выгрузки небольшого каталога такая архитектура не требуется.
Zyte — выбор профессиональных команд веб-разработки, создающих масштабные контуры парсинга для корпоративных баз данных.
5.6 ScrapingBee
ScrapingBee — универсальный API веб-скрапинга, подходящий для широкого круга площадок, включая Amazon. Сервис берет на себя управление headless-браузерами, ротацию прокси и решение капчи через единый прозрачный эндпоинт.
Основные возможности:
- Рендеринг JavaScript: Полное выполнение скриптов на странице перед передачей данных парсеру.
- Ротация IP: Использование пулов резидентских и дата-центр прокси при отправке запросов.
- Простой формат вызовов: Передача целевого URL с базовыми параметрами и получение сырого HTML или JSON.
- Универсальность: Один и тот же API подходит для работы с Amazon и другими торговыми площадками.
Платформа привлекает простотой интеграции и многоцелевым использованием:
Преимущества:
- Минимум настроек: Отсутствие необходимости поддерживать свои браузерные фермы и пулы IP.
- Надежная обработка динамики: Корректный сбор асинхронно подгружаемых цен и отзывов.
- Гибкость применения: Подходит для кросс-платформенного мониторинга цен в разных магазинах.
- Понятная модель оплаты: Прозрачные пакетные тарифы на основе потраченных кредитов API.
При этом ориентация на универсальность порождает специфические ограничения:
Недостатки:
- Отсутствие готовых схем Amazon: Нет выделенных эндпоинтов, возвращающих предобработанный JSON с каталогом маркетплейса.
- Необходимость самостоятельного разбора: Полученный HTML-код приходится разбирать собственными селекторами.
- Коэффициенты списания кредитов: Сложный JS-рендеринг и премиум-прокси расходуют по несколько кредитов за одно обращение.
ScrapingBee подходит для небольших и средних проектов, которым нужен надежный инструмент обхода блокировок, особенно если Amazon — лишь один из нескольких источников данных.
5.7 Сравнительная таблица инструментов парсинга Amazon
Ниже приведено наглядное сопоставление коммерческих платформ по ключевым параметрам:
| Сервис | Готовые парсеры Amazon | API | Прокси | Сложность внедрения | Оптимально для |
|---|---|---|---|---|---|
| Bright Data | ✓ | ✓ | ✓ | Средняя | Крупных корпораций |
| Oxylabs | ✓ | ✓ | ✓ | Средняя | E-commerce разведки |
| ScraperAPI | ✓ (Структурированные методы) | ✓ | ✓ | Низкая | Разработчиков и стартапов |
| Apify | ✓ (Через библиотеку Actors) | ✓ | Есть | Низкая | No-code + вызовы по API |
| Zyte | Зависит от проекта (API + Scrapy Cloud) | ✓ | ✓ | Средняя | Команд с опытом в Scrapy |
| ScrapingBee | Универсальный (не специализирован) | ✓ | ✓ | Низкая | Сбора данных с разных сайтов |
Для промышленных масштабов Bright Data и Oxylabs обеспечивают непревзойденный уровень инфраструктурной надежности. ScraperAPI дает максимальную скорость интеграции благодаря готовым схемам JSON. Apify удобен для быстрых экспериментов на базе готовых модулей, а Zyte — лучший выбор для пользователей фреймворка Scrapy. Если же Amazon выступает лишь одной из нескольких площадок мониторинга, ScrapingBee станет гибким решением.
6. Сравнение 4 основных подходов к парсингу Amazon
Четыре базовых метода существенно различаются по финансовым затратам, сложности запуска, устойчивости к блокировкам и потенциалу масштабирования:
| Подход | Затраты | Сложность внедрения | Устойчивость к антиботам | Стабильность на дистанции | Подходящий масштаб |
|---|---|---|---|---|---|
| Самописный скрипт (Requests) | Минимальные | Высокая | Низкая / Средняя | Низкая (сбои при смене верстки) | Индивидуальный, малый объем |
| Headless-браузер | Низкие / Средние | Высокая | Средняя | Средняя | Страницы со сложным JS |
| Официальный канал (Creators API) | Средние (требует квалификации) | Низкая | Не требуется (официальный доступ) | Высокая (при соблюдении правил) | Партнерские сети, белые сервисы |
| Коммерческий Scraper API | Средние / Высокие | Низкая | Высокая | Высокая | Крупный бизнес, постоянный сбор |
Собственный скрипт дает гибкость и не требует подписок, но возлагает на вас решение всех проблем с прокси и адаптацией под меняющуюся разметку. Headless-браузеры решают проблему динамического рендеринга ценой повышенных требований к «железу».
Creators API выступает эталоном надежности при наличии одобренной учетной записи. Для компаний, которым нужен постоянный масштабный сбор данных без найма DevOps-инженеров для обслуживания прокси-ферм, коммерческие Scraper API остаются самым практичным выбором.
7. Почему собирать данные с Amazon сложнее, чем с других площадок?
Каталог Amazon содержит миллионы товаров, однако платформа защищена одной из самых продвинутых антифрод-систем в мире. В отличие от статичных веб-ресурсов, отправка частых запросов к Amazon быстро приводит к блокировке, если алгоритмы безопасности фиксируют отклонения от человеческого поведения.
Типичные препятствия при парсинге маркетплейса:
- Лимиты частоты запросов (Rate Limiting): Серия быстрых запросов с одного IP ведет к мгновенному троттлингу или временному бану сетевого адреса.
- Проверки CAPTCHA: При выявлении подозрительных паттернов сервис возвращает страницу с CAPTCHA, останавливая автоматический сбор.
- Динамические модификации DOM: Amazon периодически обновляет названия классов и структуру HTML, ломая жестко заданные селекторы в коде.
- Зависимость от JavaScript: Ключевые параметры (цены Buy Box, условия доставки, отзывы) подгружаются асинхронно после первичного открытия страницы.
- Контроль сессий и геопривязка: Для отображения локальных цен требуется поддерживать файлы cookie, сессии и определенные почтовые индексы, управляя отпечатками браузера.
- Проблемы масштабирования: Собрать 50 позиций не составляет труда, но обработка сотен тысяч страниц требует администрирования прокси, очередей повторов и распределенных баз данных.
Эти барьеры объясняют компромиссы каждого пути: легкие скрипты требуют постоянной ручной доработки, headless-браузеры упираются в производительность процессоров, а официальные API и коммерческие шлюзы снижают операционную нагрузку за счет оплаты подписок или жестких рамок правил.
8. Практические советы по безопасному парсингу Amazon
Надежность контура сбора определяется архитектурной дисциплиной. Способы отправки запросов, разграничение сессий и обработка сетевых сбоев напрямую влияют на непрерывность процесса. Рекомендуем придерживаться следующих правил:
- Контролируйте частоту запросов: Избегайте всплесков активности в короткие интервалы времени. Добавляйте случайные задержки между переходами, имитируя поведение реального покупателя.
- Используйте качественные прокси: Подбирайте тип сети под задачу. Для объемных выгрузок и отслеживания региональных цен резидентские прокси обеспечивают лучшую защиту от блокировок.
- Изолируйте сессии и cookie: Не смешивайте авторизационные токены и региональные настройки между задачами. В многопоточном сборе автономность сессий исключает взаимную компрометацию потоков.
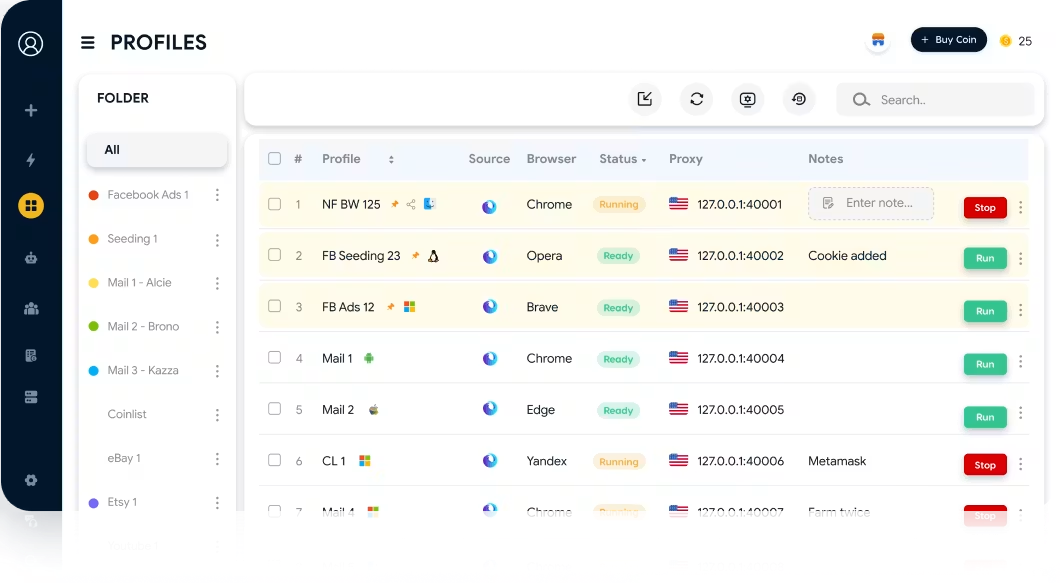
- Разделяйте браузерные профили: Для браузерной автоматизации используйте антидетект-браузер Hidemyacc. Это позволит развернуть независимые виртуальные среды, изолировав цифровые отпечатки, сессионные данные и привязанные прокси для каждого рабочего потока.
- Внедряйте адаптивные повторы (Retry Logic): Предусмотрите обработку сетевых ошибок, таймаутов и пустых ответов с экспоненциальной задержкой, чтобы локальный сбой не прерывал общую задачу.
- Учитывайте политику платформы: Перед развертыванием скриптов ознакомьтесь с Условиями использования Amazon, регламентами API и законами о защите данных, применимыми в вашей юрисдикции.
Соблюдение этих инструкций делает поток сбора управляемым, особенно при масштабной параллельной обработке объемных каталогов ASIN.
Материалы по теме прокси-инфраструктуры:
- Лучшие прокси-провайдеры для Amazon: масштабируйте продажи безопасно
- Мобильные прокси: особенности, преимущества и руководство по применению
- Резидентские прокси: принципы работы и сценарии использования
- Что такое серверные прокси? Полный обзор характеристик
- Резидентские или серверные прокси: сравнение и выбор правильного решения
9. Типичные ошибки при запуске скрапинга Amazon
Сбои в работе парсеров чаще возникают из-за архитектурных просчетов на старте, а не из-за синтаксических ошибок в скриптах. Обратите внимание на следующие распространенные ошибки:
- Выбор решения только по легкости запуска: Простой скрипт годится для разового теста, но оказывается нежизнеспособным при масштабировании. Планируйте архитектуру с оглядкой на планируемый объем страниц и периодичность сбора.
- Попытка использовать один шаблон под все страницы: Карточки товаров, поисковая выдача и блоки отзывов имеют принципиально разную структуру и поведение скриптов, требуя индивидуальных парсеров.
- Привязка к нестабильным селекторам CSS: Использование автогенерируемых классов приводит к падению скрипта при плановом обновлении дизайна площадки. Надежнее использовать селекторы XPath или считывать встроенные блоки JSON-LD.
- Игнорирование ограничений железа: Процесс, стабильно обрабатывающий 50 ссылок, может зависнуть из-за переполнения памяти при пакетной выгрузке десятков тысяч страниц.
- Занижение затрат на поддержку: Парсинг требует постоянного внимания инженеров. Изменения верстки сайта, усиление защиты и новые требования к данным требуют регулярного рефакторинга.
- Оценка API исключительно по цене за запрос: Заявленная стоимость клика не отражает всей картины. Учитывайте реальный процент успешных ответов, задержку серверов и повышающие коэффициенты за рендеринг динамических страниц.
Взвешенная подготовка на начальном этапе избавит команду от необходимости переписывать систему заново при первом же серьезном увеличении объема задач.
10. Заключение
Единого универсального рецепта для парсинга Amazon не существует. Для скромных задач при наличии навыков программирования создание собственного скрипта на Python обеспечит гибкость и независимость от внешних сервисов. Headless-браузеры незаменимы для страниц с динамической отрисовкой на JavaScript. В свою очередь, официальный Creators API и специализированные коммерческие сервисы Scraper API гарантируют надежность при регулярных промышленных объемах сбора.
В сценариях автоматизации браузерных сессий подключение антидетект-инструментов помогает структурировать рабочее пространство. Антидетект-браузер Hidemyacc позволяет создавать изолированные профили, связывать их с проверенными прокси и библиотеками вроде Puppeteer, обеспечивая долговечность процессов сбора.
Перед развертыванием инфраструктуры определите целевые параметры данных, рассчитайте рабочую нагрузку и выстройте этапы валидации. Обязательно сопоставляйте свои процессы с правилами платформы Amazon и требованиями регуляторов, чтобы собирать данные безопасно и эффективно.
Дополнительные материалы:
- Как безопасно масштабировать сетку аккаунтов продавца на Amazon?
- Почему заблокирован аккаунт Amazon? 3 практических совета по восстановлению
- Где безопасно купить трастовые возрастные аккаунты Amazon?
11. FAQ
1. Законно ли парсить данные с Amazon?
Законность сбора общедоступных данных зависит от юрисдикции, применяемых технических методов и целей использования информации. Ознакомьтесь с Пользовательским соглашением Amazon, правилами используемых API и нормами законодательства о защите информации перед стартом проекта.
2. Сложно ли написать парсер Amazon на Python?
Для сбора базовых сведений с нескольких карточек товаров достаточно небольшого скрипта на Requests и BeautifulSoup. Однако с ростом масштабов необходимость решать CAPTCHA, обходить ограничения по частоте и адаптироваться к изменениям верстки существенно усложняет проект.
3. Как понять, что Amazon заблокировал доступ парсеру?
К характерным признакам относятся появление страниц с проверочным кодом CAPTCHA, статусы ответа HTTP 403 Forbidden или 503 Service Unavailable, таймауты соединений или возвращение пустых страниц. Если браузер открывает страницу без проблем, а скрипт возвращает ошибку, ваш сетевой узел, скорее всего, попал под фильтр.
4. Стоит ли использовать бесплатные прокси для парсинга Amazon?
Использовать публичные бесплатные прокси категорически не рекомендуется. Они отличаются низкой скоростью, нестабильностью и почти всегда находятся в черных списках систем безопасности Amazon, что приводит к гарантированным ошибкам доступа.
5. Обязательно ли использовать антидетект-браузер при сборе данных с Amazon?
Не всегда. Для простых скриптов или сценариев на базе коммерческих API достаточно обычных прокси и сетевых запросов. Антидетект-браузер необходим при организации параллельных браузерных сессий, когда требуется изолировать файлы cookie, среду исполнения и цифровые отпечатки оборудования для предотвращения связывания аккаунтов.