¿Desea recopilar datos de Instagram para analizar a la competencia, encontrar influencers o investigar tendencias de contenido? En lugar de copiar manualmente cada publicación, puede utilizar técnicas de Instagram scraping para recopilar información con rapidez y exportarla en formatos estructurados como JSON, CSV o Excel.
En este artículo aprenderá paso a paso los distintos métodos para recopilar datos de Instagram: desde procedimientos manuales, herramientas de código abierto y servicios de API listos para usar, hasta el desarrollo de scripts propios en Python, junto con las pautas necesarias para mitigar bloqueos al gestionar múltiples cuentas.
1. ¿Qué es el scraping de Instagram y qué datos se pueden recopilar?
Si alguna vez ha querido saber qué publica la competencia, qué hashtags marcan tendencia o qué tasa de interacción alcanza un creador de contenido, el scraping de Instagram automatiza la recolección de esas métricas. En vez de transcribir los datos de forma manual, un scraper extrae la información pública de la plataforma y la organiza en archivos como JSON, CSV o Excel para su posterior análisis.
Conviene señalar que el web scraping difiere sustancialmente de la Instagram Graph API. La Graph API es la solución oficial de Meta y solo permite consultar información de cuentas que hayan concedido autorizaciones directas. Por su parte, el scraping recopila datos de acceso público procedentes de perfiles, hashtags o Reels con fines de prospección comercial y benchmarking competitivo.
¿Qué tipo de datos se pueden extraer?
Los campos accesibles dependen de las herramientas empleadas y del nivel de acceso, incluyendo habitualmente:
| Tipo de dato | Ejemplos de campos extraíbles |
|---|---|
| Perfiles y biografías | Nombre de usuario, foto de perfil, biografía, enlaces externos, número total de publicaciones |
| Publicaciones y Reels | Texto del pie de foto, enlaces de fotos/vídeos, fecha de publicación, número de «me gusta», reproducciones |
| Comentarios | Texto de los comentarios, usuarios que comentan, «me gusta» en comentarios, métricas de interacción |
| Hashtags y Explorar | Publicaciones agrupadas por hashtag, contenidos populares, publicaciones de la pestaña Explorar |
| Seguidores | Cifra global de seguidores visibles públicamente (la descarga de listas completas está limitada) |
Tras la extracción, los datos suelen exportarse en JSON, CSV o Excel, lo que facilita su carga directa en Google Sheets, Power BI u otras plataformas analíticas.
Descubra más en: Guía para extraer datos de la página Explorar de Instagram: herramientas y consejos imprescindibles
2. Recopilación manual de datos de Instagram
El registro manual es la opción más elemental cuando solo se precisa evaluar un número reducido de perfiles, publicaciones o etiquetas. Aunque no resulta viable a gran escala, resulta de gran utilidad durante exploraciones preliminares al no requerir instalaciones de software ni líneas de código.
Antes de aplicar este procedimiento, conviene valorar sus aspectos positivos y sus limitaciones:
Ventajas
- Completamente gratuito y sin necesidad de instalar programas.
- Fácil de llevar a cabo desde ordenadores o teléfonos móviles.
- Riesgo prácticamente nulo de sanciones en Instagram al prescindir de bots.
Desventajas
- Exige mucho tiempo cuando el volumen de publicaciones aumenta.
- Dificultad para mantener datos actualizados de forma periódica.
- Mayor probabilidad de cometer errores humanos durante la transcripción.
Procedimiento de ejecución
Puede registrar las métricas esenciales siguiendo este flujo de trabajo básico:
- Acceda al perfil, hashtag o Reel que desea examinar.
- Tome nota del texto del pie de foto, los «me gusta», los comentarios y la fecha de publicación.
- Organice y traslade los datos de forma estructurada a columnas en Google Sheets o Excel.
- Revise los registros para eliminar posibles duplicados antes de iniciar el análisis.
Si solo necesita monitorizar unas pocas decenas de publicaciones para un estudio puntual, el método manual es la alternativa más directa y económica antes de dar el salto a sistemas automáticos.
3. Herramientas de código abierto para extraer datos de Instagram
Si cuenta con nociones básicas de Python y busca diseñar su propio flujo de trabajo, las librerías de código abierto ofrecen un equilibrio idóneo entre coste económico y flexibilidad técnica. Con ellas mantendrá el control de los datos salientes y podrá integrarlos fácilmente con sus sistemas analíticos internos.
3.1. Instaloader
Instaloader es una alternativa muy práctica cuando el objetivo principal radica en capturar datos públicos —como perfiles, publicaciones o hashtags— sin depender de plataformas de pago por suscripción.
Instaloader permite obtener:
- Perfiles públicos
- Publicaciones convencionales y Reels
- Contenidos etiquetados con hashtags
- Archivos multimedia y respuestas en formato JSON
Aspectos clave a considerar antes de su implementación:
Ventajas
- Software gratuito con mantenimiento frecuente por parte de la comunidad.
- Integración nativa y sencilla en proyectos de Python.
- Muy adecuado para proyectos académicos, pruebas de concepto e investigaciones breves.
Desventajas
- Capacidades reducidas frente a contenidos que exigen autenticación previa.
- Sensible a los límites de peticiones (rate limits) en consultas de gran volumen.
Para la recolección de información pública, Instaloader es una de las soluciones más accesibles gracias a su facilidad de configuración y a su extensa comunidad de desarrolladores.
Pasos para utilizar Instaloader
El proceso de despliegue requiere solo unos pasos básicos:
- Instale la librería Instaloader mediante pip en su entorno de Python.
- Indique los nombres de usuario o los hashtags que desea consultar.
- Ejecute el script para procesar y descargar los contenidos.
- Guarde los resultados estructurados en formato JSON o CSV.
Una vez exportada la información, podrá limpiarla y procesarla en herramientas como Excel o Power BI.
3.2. instagrapi / aiograpi
Cuando el proyecto exige parámetros más profundos —como listados de seguidores, seguidos o comentarios anidados—, instagrapi y su versión asíncrona aiograpi resultan más versátiles que Instaloader al comunicarse directamente con los endpoints privados de la aplicación móvil.
Estas librerías permiten recopilar:
- Detalles exhaustivos del perfil
- Listas de seguidores y seguidos
- Hilos de comentarios
- Historias activas y destacadas
- Metadatos avanzados de las publicaciones
Al funcionar sobre endpoints privados de la aplicación, es importante sopesar tanto sus puntos fuertes como los riesgos asociados a la seguridad de las cuentas.
Ventajas
- Acceso a información más amplia y detallada.
- Gran velocidad de procesamiento y soporte para llamadas asíncronas.
- Alta capacidad de integración en cadenas de automatización complejas.
Desventajas
- Requiere iniciar sesión de forma obligatoria con credenciales de Instagram.
- Mayor probabilidad de enfrentar verificaciones de seguridad (checkpoints) ante patrones irregulares.
- Obligación de actualizar el código cuando Instagram modifique sus endpoints internos.
En resumen, instagrapi se adapta a proyectos que requieren datos avanzados, aunque exige un cuidado riguroso en la gestión de sesiones y cuentas.
Pasos para utilizar instagrapi
Para implementar esta solución de forma controlada, siga estos pasos:
- Inicie sesión mediante una cuenta secundaria de Instagram destinada a pruebas.
- Realice la llamada al endpoint correspondiente según los datos que necesite.
- Almacene los datos obtenidos en archivos JSON.
- Depure y estandarice los campos antes de trasladarlos a su base de datos.
Este sistema proporciona un acceso más profundo que los scrapers públicos básicos, pero requiere una supervisión constante de las sesiones para minimizar bloqueos.
4. Servicios de API administrados para el scraping de Instagram
Si prefiere no construir ni mantener un scraper desde cero, recurrir a servicios de API comerciales es una alternativa muy eficaz. La ventaja de estas plataformas radica en que gestionan internamente la rotación de proxies, las defensas antibot y la resolución de captchas, entregando directamente información estructurada lista para su consumo.
4.1. Bright Data
Bright Data es una de las soluciones empresariales más consolidadas para extraer datos de Instagram a escala masiva. Permite obtener perfiles, publicaciones, Reels, comentarios y hashtags mediante llamadas a su API sin necesidad de desplegar infraestructura propia.
Características sobresalientes:
- Amplia cobertura sobre los datos públicos de Instagram.
- Entrega de resultados en formato JSON perfectamente estructurado.
- Red integrada de proxies residenciales para garantizar alta disponibilidad.
- Infraestructura preparada para procesar grandes volúmenes de consultas simultáneas.
Aspectos a considerar
- Costes significativamente más elevados que las herramientas básicas de automatización.
- Diversidad de planes que exige calcular con precisión el volumen de consumo necesario.
Si su actividad comprende monitorización de marca a gran escala o la supervisión de miles de perfiles, Bright Data ofrece mayor estabilidad que los scripts domésticos.
4.2. Oxylabs
Oxylabs proporciona una API especializada en la extracción de datos de Instagram, diseñada para conectarse directamente a sistemas de análisis empresarial o plataformas de inteligencia comercial. Frente a herramientas de usuario final, prioriza la resiliencia y el procesamiento concurrente masivo.
Capacidades que ofrece:
- Extracción de perfiles públicos
- Captura de publicaciones y etiquetas
- Envío de datos mediante endpoints de API
- Respaldo sobre una extensa infraestructura de proxies residenciales
Ventajas
- Conexión fiable con elevados porcentajes de éxito respaldados por acuerdos de nivel de servicio (SLA).
- Integración sencilla con almacenes de datos y sistemas corporativos.
- Arquitectura orientada a operaciones estables de larga duración.
Desventajas
- Precios adaptados a presupuestos empresariales.
- Conjunto de funciones que puede resultar excesivo para tareas pequeñas y puntuales.
Para construir sistemas estables de seguimiento de competidores a largo plazo, Oxylabs resulta más conveniente que mantener navegadores locales propios.
4.3. Apify
Apify permite extraer datos sin tener que programar un scraper completo desde cero. En lugar de desarrollar toda la arquitectura en Python, se pueden utilizar plantillas prediseñadas (denominadas Actors) para recopilar perfiles, hashtags, publicaciones o comentarios, exportándolos de forma inmediata.
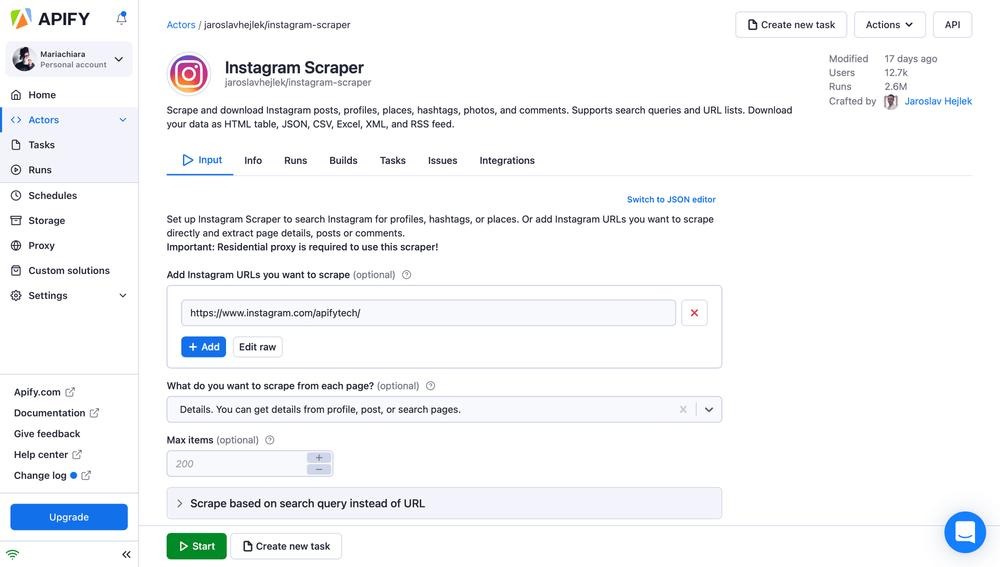
Datos accesibles con Apify:
- Perfiles de usuario
- Publicaciones convencionales y Reels
- Hashtags
- Comentarios públicos
- Descarga de resultados en JSON, CSV o Excel
Ventajas
- No se precisan habilidades técnicas de programación.
- Configuración y ejecución rápidas desde su interfaz web.
- Variedad de formatos listos para exportar hacia otras herramientas de trabajo.
- Programación de extracciones automáticas mediante calendario.
Desventajas
- La calidad y el mantenimiento varían según el creador de cada Actor.
- Las tareas con volúmenes altos requieren incorporar proxies dedicados para evitar bloqueos.
- Menor capacidad de adaptación frente a scripts programados a medida.
Recomendaciones de uso
La tienda de Apify cuenta con múltiples Actors publicados por su comunidad; conviene revisar el número de usuarios activos, las valoraciones y la fecha de la última actualización antes de elegir uno. Al procesar grandes volúmenes de datos, asociar proxies residenciales mejora notablemente la tasa de éxito.
Para profesionales de marketing que necesitan resultados ágiles sin programar, Apify se sitúa como una de las opciones sin código más accesibles.
4.4. PhantomBuster
PhantomBuster está orientado a la prospección y a la automatización de acciones comerciales en Instagram más que a la creación de scrapers personalizados. Es una herramienta adecuada para obtener datos de forma recurrente y sincronizarlos con Google Sheets o plataformas CRM.
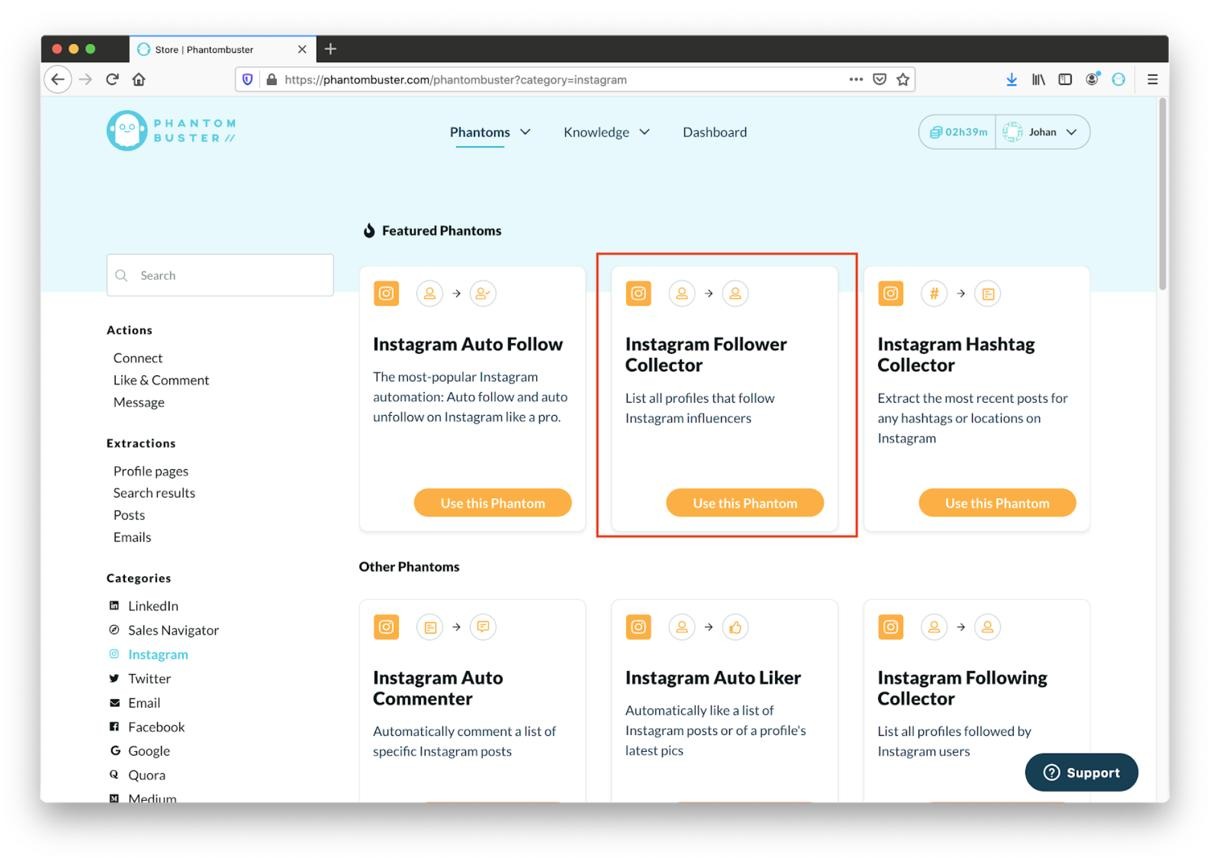
Prestaciones de PhantomBuster:
- Recopilación de perfiles públicos
- Extracción de comentarios en publicaciones
- Sincronización directa con Google Sheets
- Ejecución desatendida mediante programación temporal
Ventajas
- Uso totalmente libre de código.
- Puesta en marcha de tareas en pocos minutos.
- Conexión fluida con el stack tecnológico de marketing digital.
Desventajas
- Tiempos de ejecución mensual estrictamente limitados según el plan contratado.
- Poco adecuado para conjuntos de datos masivos.
- Escaso margen de maniobra para transformaciones de datos complejas.
Nota práctica: La plataforma factura según el tiempo de ejecución diario disponible; es preferible fragmentar los trabajos en lotes pequeños en vez de procesar listas enormes en una sola ejecución. Así optimizará el consumo y reducirá los riesgos de detección.
Para labores sistemáticas como el seguimiento periódico de la competencia o la prospección comercial, PhantomBuster aporta mayor agilidad que el mantenimiento de código propio.
5. Cómo crear un scraper para Instagram con Python, Selenium o Playwright
Cuando las opciones comerciales prediseñadas no se ajustan a los requisitos de su proyecto, construir un scraper propio garantiza un dominio integral sobre la recolección de datos. Este método es el más indicado cuando se necesitan filtros a medida, integración directa con bases de datos internas o el uso simultáneo de varias cuentas.
Las librerías más empleadas en la actualidad son Selenium, Playwright y Puppeteer. Todas ellas permiten emular navegadores reales, acceder a la web de Instagram e interactuar con el DOM para extraer la información visible.
Paso 1. Preparar el entorno de desarrollo
Antes de comenzar con el código, configure un entorno de trabajo sólido para evitar fallos de dependencias durante la ejecución.
Requisitos previos:
- Entorno de ejecución de Python o Node.js
- Instalación de Selenium, Playwright o Puppeteer
- Proxies dedicados (imprescindibles al usar múltiples cuentas)
- Directorio local configurado para almacenar las salidas en JSON o CSV
Una vez preparado el entorno, estará en condiciones de conectar el script con Instagram.
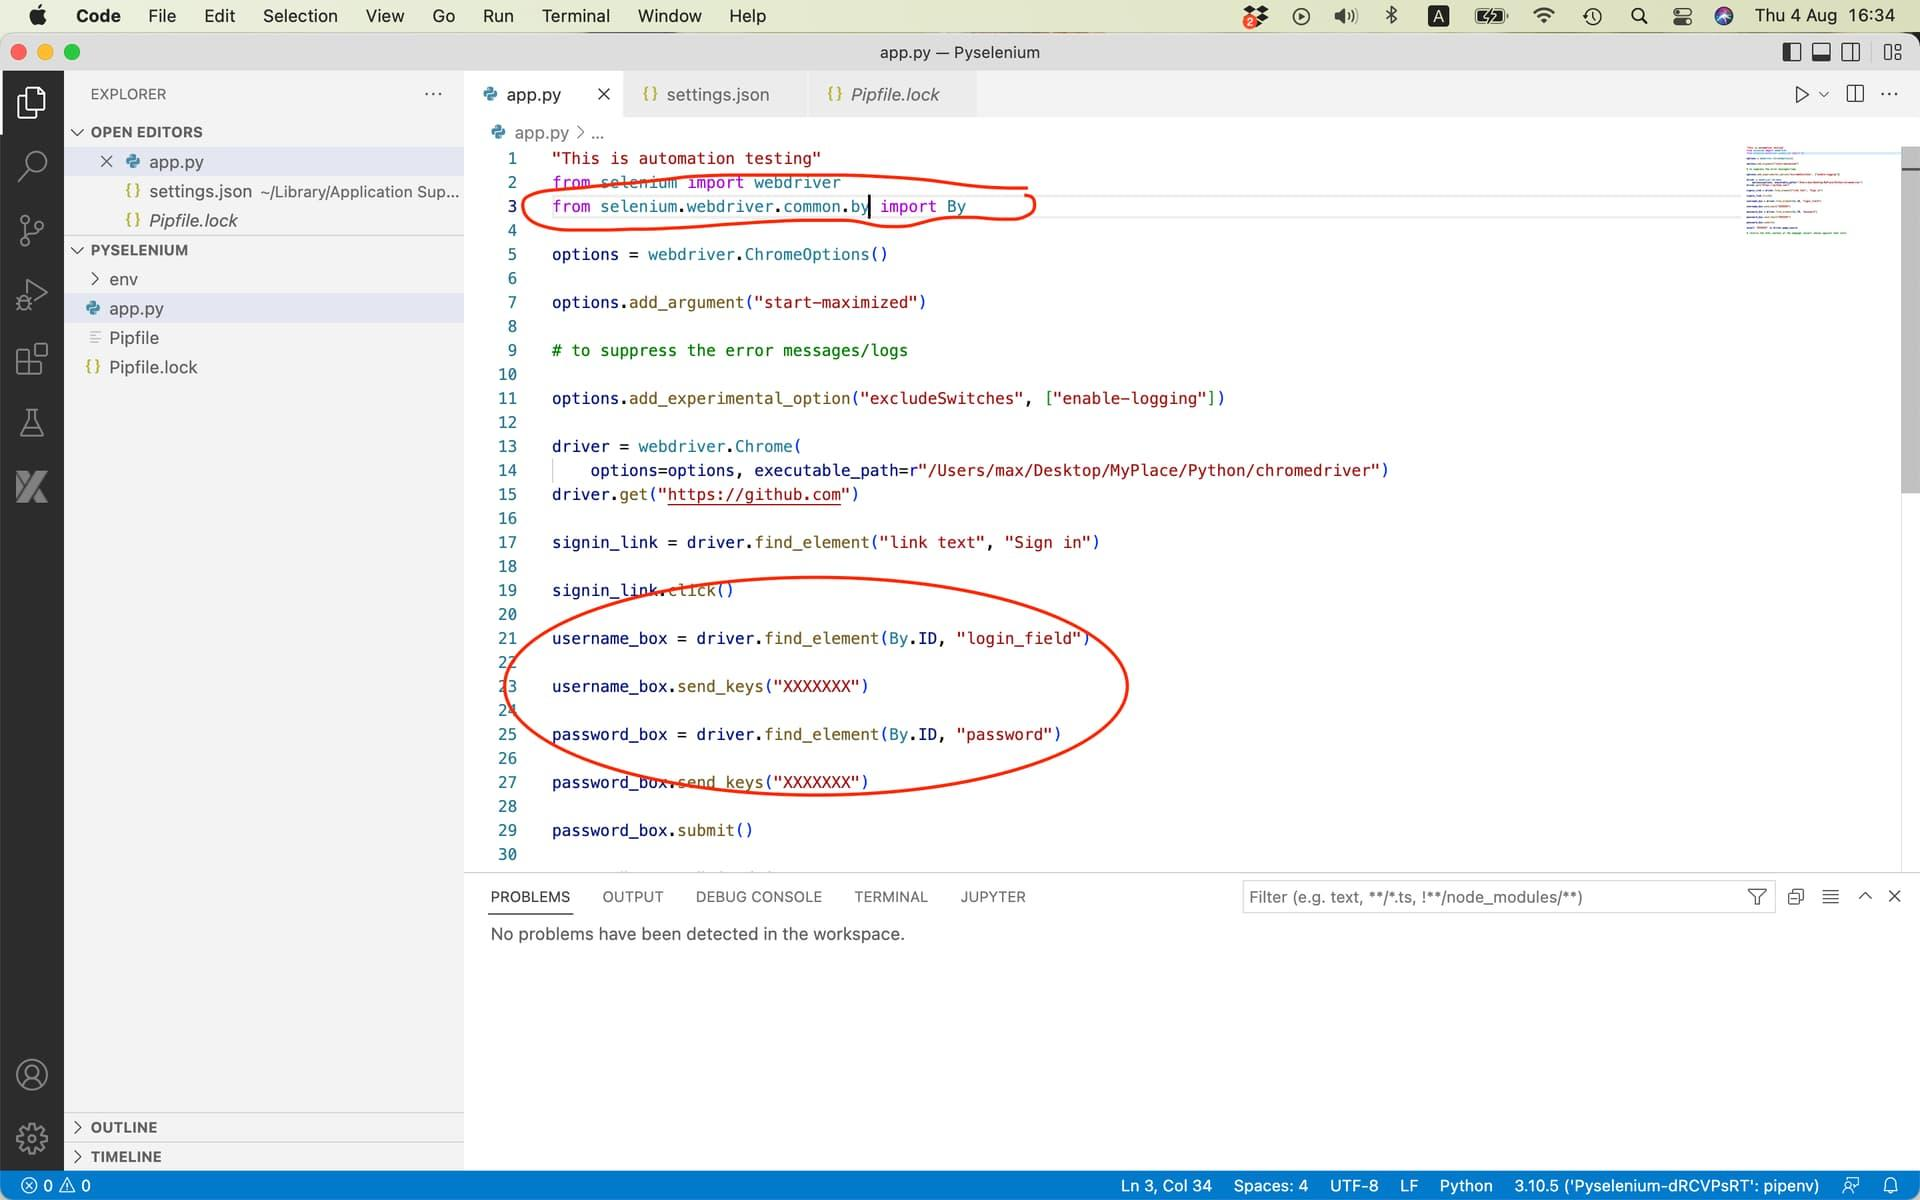
Entorno de desarrollo preparado con Python o Node.js junto a las librerías Selenium, Playwright o Puppeteer.
Paso 2. Conectarse a Instagram
En esta etapa, el script abre una ventana del navegador y carga el perfil o hashtag que se quiere consultar. Según la naturaleza de la tarea, se pueden revisar publicaciones públicas de manera anónima o autenticarse con una cuenta para mantener sesiones más estables.
Secuencia básica:
- Iniciar la instancia del navegador configurando el User-Agent.
- Navegar a la URL del perfil o etiqueta seleccionada.
- Completar el inicio de sesión si el acceso lo requiere.
- Aplicar esperas explícitas para permitir que el contenido dinámico termine de cargar.
Asegurar la carga completa de la página evita errores de extracción de datos vacíos, especialmente en Reels y listas con desplazamiento infinito.
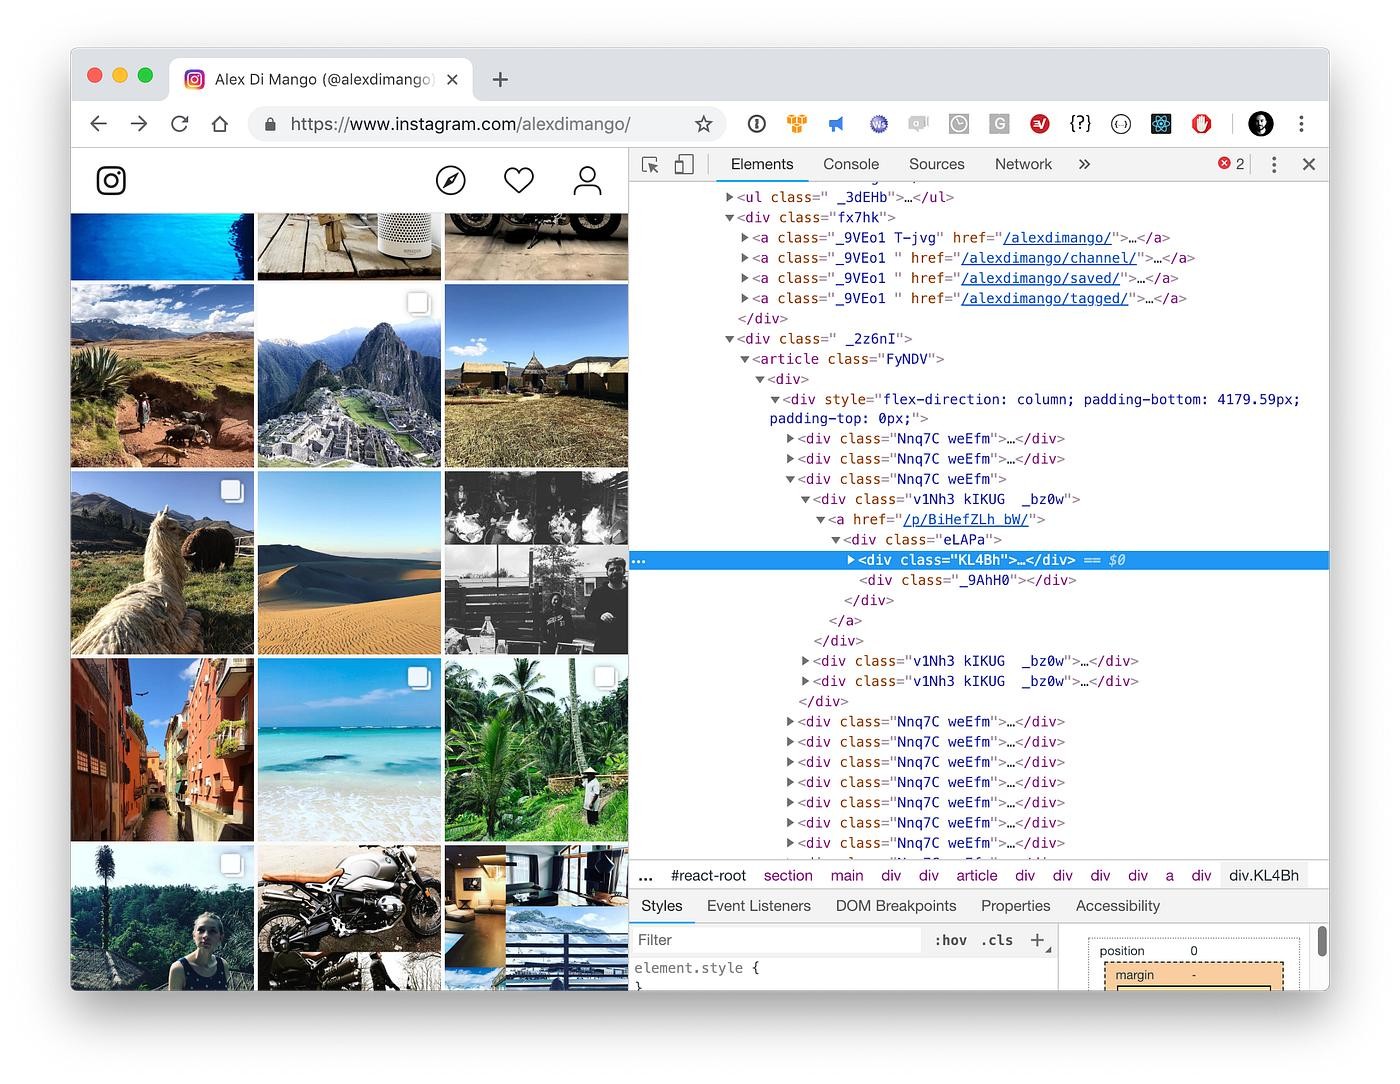
Paso 3. Extraer los datos necesarios
Una vez renderizada la página web, el script localiza los elementos visuales del DOM y los guarda en estructuras ordenadas. Los campos a recopilar se definen según las metas del análisis.
Campos habituales:
- Nombre de usuario y handle
- Texto del pie de foto
- Recuento de «me gusta»
- Comentarios
- Hashtags incluidos
- Fecha y hora de publicación
- Enlace directo a la publicación
Conviene definir nombres de columna claros y homogéneos desde el principio para agilizar el análisis en herramientas de BI o bases de datos.
Paso 4. Limpiar y exportar a JSON o CSV
Los datos obtenidos deben depurarse antes de integrarlos en reportes finales. Este proceso garantiza la calidad de los datos.
Fases del tratamiento de datos:
- Eliminar registros duplicados según el identificador de la publicación.
- Homogeneizar los formatos de fecha y hora a estándares ISO.
- Corregir caracteres especiales y verificar la codificación en UTF-8.
- Generar y guardar los archivos finales en formato JSON o CSV.
Con esto, los conjuntos de datos quedarán listos para su importación directa en Google Sheets, Excel o almacenes de datos.
Paso 5. Conectar el scraper con un perfil de Hidemyacc
Si necesita operar simultáneamente con varias cuentas de Instagram en un mismo equipo, evite que Selenium o Puppeteer abran múltiples ventanas convencionales de Chrome sin protección. Es preferible conectar el script directamente a un perfil previamente abierto en Hidemyacc a través del protocolo CDP (Chrome DevTools Protocol).
Flujo de conexión en 3 pasos:
- Realizar una petición a la Profile API de Hidemyacc para abrir el perfil mediante su ID.
- Obtener la dirección de depuración remota CDP (WebSocket Debug URL).
- Conectar Puppeteer al puerto asignado y comenzar las tareas de extracción.
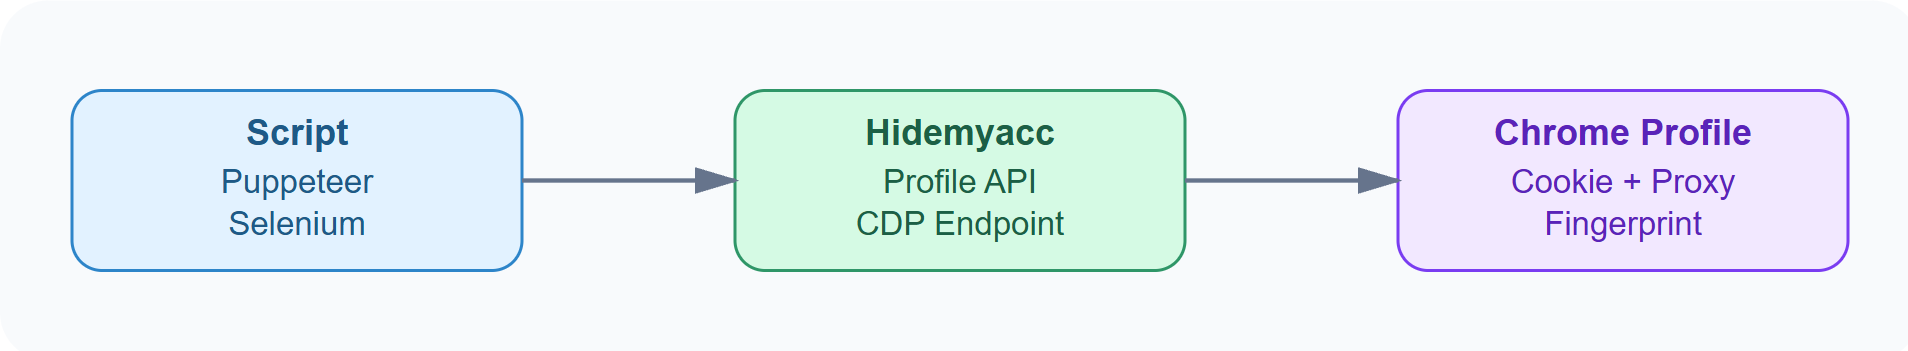
Conexión de un scraper con un perfil existente en Hidemyacc
En lugar de iniciar un navegador limpio genérico, Puppeteer se vincula a un perfil que ya tiene cargadas sus cookies, su proxy específico y una huella digital coherente. Esto garantiza que cada cuenta de Instagram opere en un entorno aislado y seguro al ejecutar procesos paralelos.
Ejemplo de código (Node.js + puppeteer-core):
const axios = require("axios");
const puppeteer = require("puppeteer-core");

async function scrapeWithHidemyaccProfile(profileId) {
  const { data } = await axios.post(
    "http://127.0.0.1:PORT_LOCAL_API/api/v3/profile/start",
    { profile_id: profileId }
  );

  const browser = await puppeteer.connect({
    browserWSEndpoint: data.ws_endpoint,
  });

  const page = await browser.newPage();

  await page.goto("https://www.instagram.com/target_profile/", {
    waitUntil: "networkidle2",
  });

  // Desarrolle aquí la lógica de recolección de datos

  await browser.disconnect();
}
Este fragmento muestra cómo enlazar el scraper a una sesión de navegación activa sin crear navegadores paralelos desprotegidos. Al gestionar múltiples perfiles en paralelo, asigne a cada uno un puerto CDP independiente para evitar conflictos de comunicación.
6. Comparativa de los métodos de recolección de datos en Instagram
Tras revisar las distintas opciones, resulta evidente que no existe una única solución para todos los escenarios. Para estudiar unas pocas cuentas, los recursos manuales o sin código ahorran tiempo de desarrollo; por el contrario, los proyectos recurrentes de gran tamaño exigen el uso de APIs dedicadas o scrapers programados a medida.
| Método | Coste | Dificultad técnica | Uso recomendado |
|---|---|---|---|
| Recopilación manual | Gratuito | Muy baja | Pequeños volúmenes, análisis puntuales |
| Librerías de código abierto | Gratuito | Media | Desarrolladores de Python, investigaciones |
| Servicios de API comerciales | Pago por uso / suscripción | Baja | Empresas, especialistas en marketing |
| Scrapers propios | Costes de desarrollo e infraestructura | Alta | Proyectos con lógica personalizada |
Elegir el método idóneo desde el inicio le permitirá ahorrar tiempo de desarrollo y optimizar costes de operación, especialmente al plantearse escalar la infraestructura en el futuro.
7. ¿Permite Instagram el web scraping?
Esta es una de las dudas más frecuentes al planificar tareas de extracción de datos en redes sociales. De forma directa: Instagram no ofrece una API abierta para la extracción libre de datos y aplica diversos mecanismos técnicos orientados a restringir la recolección automatizada en su plataforma.
Resulta imprescindible diferenciar los datos de acceso público de la información privada y comprender cómo detecta Instagram los patrones anómalos antes de lanzar cualquier flujo automatizado.
7.1. Condiciones del servicio de Meta
Meta insta a los desarrolladores a utilizar la Instagram Graph API para la creación de aplicaciones y la gestión de cuentas profesionales (Business y Creator). El web scraping convencional actúa leyendo los datos representados en la interfaz visual, situándose fuera de los circuitos de acceso homologados por la compañía.
Esto no significa que toda tarea de recolección de datos públicos esté terminantemente prohibida por ley, pero sí infringe los términos de uso de la plataforma. Por ello, conviene restringir las consultas a datos estrictamente públicos y respetar las normativas de Meta para reducir el riesgo de sanciones.
7.2. Datos públicos frente a datos privados
No toda la información presente en Instagram está disponible para su extracción. Antes de crear un scraper, distinga con claridad ambos grupos de datos:
| Datos públicos | Datos privados |
|---|---|
| Biografía y perfiles abiertos | Mensajes directos (DMs) |
| Texto de publicaciones públicas | Contenido de cuentas privadas |
| Contenidos de hashtags abiertos | Listas de seguidores de perfiles privados |
| Comentarios en publicaciones abiertas | Historias reservadas para seguidores |
| Número global de seguidores visibles | Datos personales que exigen permisos expresos |
Dicho de otro modo: el scraping debe limitarse a la información visible para cualquier visitante no autenticado, mientras que los datos privados permanecen protegidos por los controles de acceso de Instagram.
¿Por qué la Graph API resulta insuficiente para estudios de mercado?
Aunque la Instagram Graph API es el recurso oficial de Meta, se diseñó para la administración interna de cuentas autorizadas y no para la exploración de la plataforma en su conjunto. Por este motivo, muchas empresas combinan el uso de APIs con técnicas de scraping en sus análisis de mercado.
Limitaciones más comunes de la Graph API:
- Solo concede acceso a los datos de cuentas previamente autenticadas y autorizadas.
- No permite monitorizar detalladamente a competidores o perfiles externos.
- Aplica cuotas muy restrictivas para rastrear hashtags y cuentas públicas a gran escala.
Si su propósito es seguir las tendencias de contenido o analizar información pública de cuentas ajenas, el scraping ofrece mayor versatilidad que la API oficial.
7.3. ¿Cómo detecta Instagram la actividad de scraping?
Muchos suponen que alternar direcciones IP basta para evitar bloqueos. En la práctica, Instagram cruza múltiples señales técnicas y de comportamiento para determinar si una sesión corresponde a un usuario legítimo o a un script automatizado.
Mecanismos de detección habituales:
- Límites de frecuencia (Rate Limits): Restringen la cantidad de peticiones permitidas en un intervalo temporal. Si se envían solicitudes de forma masiva, Instagram bloquea temporalmente la sesión.
- Captchas y Checkpoints: Se activan cuando la plataforma sospecha de una interacción automatizada o detecta inicios de sesión en entornos no habituales.
- Análisis de comportamiento: Monitoriza la velocidad de desplazamiento, las pausas entre clics y el modo de interactuar con el contenido para diferenciar a los humanos de los bots.
- Reputación de la IP: Valora el nivel de confianza de la dirección de red. Las IPs procedentes de centros de datos o compartidas por muchas cuentas sufren un escrutinio mayor.
- Huella digital del navegador (Browser Fingerprint): Compara parámetros como User-Agent, Canvas, WebGL, fuentes instaladas, idioma y resolución para identificar el dispositivo.
En lugar de intentar extraer información a máxima velocidad, conviene moderar el ritmo de peticiones, añadir pausas aleatorias y conservar un entorno de navegación coherente para evitar bloqueos por Action Block o Checkpoints.
8. Cómo recopilar datos de Instagram reduciendo el riesgo de bloqueo
Un buen scraper no solo debe ser capaz de procesar datos, sino también de operar de forma estable en el tiempo. La mayoría de los bloqueos o solicitudes de verificación no se deben a errores en el código, sino a malas prácticas como compartir un mismo entorno entre varias cuentas, emitir peticiones desmedidas o alterar constantemente los parámetros del navegador. A continuación se detallan 5 pautas para mitigar estas alertas.
8.1. Utilizar un proxy exclusivo para cada sesión
La dirección IP es uno de los primeros parámetros evaluados por los sistemas de seguridad de Instagram. Si diversas cuentas operan simultáneamente bajo una misma IP, resultará sencillo vincularlas entre sí.
Recomendaciones clave:
- Asignar un proxy independiente a cada cuenta de trabajo.
- Priorizar el uso de proxies residenciales o proxies móviles frente a IPs de centros de datos.
- Evitar cambiar de IP de forma continua dentro de una misma sesión activa.
Mantener una IP estable durante una sesión resulta mucho más natural que rotar de dirección cada pocos minutos.
Artículo relacionado: Los 6 mejores proveedores de proxies para Instagram para proteger sus cuentas
8.2. Aislar las huellas digitales del navegador
Incluso cambiando de IP, Instagram puede reconocer su equipo mediante la huella digital del navegador. Esta se compone de parámetros como el User-Agent, Canvas, WebGL, fuentes tipográficas, idioma configurado y resolución de pantalla.
Una huella coherente debe alinear:
- El User-Agent
- La zona horaria local
- El idioma preferido del navegador
- Los datos de renderizado de Canvas y WebGL
- Las fuentes del sistema y la resolución del monitor
Al dotar a cada cuenta de un perfil de huella digital diferenciado, la probabilidad de que las sesiones queden vinculadas se reduce drásticamente.
8.3. Distribuir el trabajo en perfiles aislados en vez de usar una sola sesión
Gestionar entre 5 y 10 cuentas de Instagram iniciando sesión en una única instancia de Chrome provoca el cruce de cookies, sesiones y huellas digitales, especialmente al ejecutar scripts de automatización.
Buenas prácticas recomendadas:
- Regla estricta: una cuenta por cada perfil de navegación.
- Almacenamiento independiente de cookies y sesiones para cada perfil.
- Asignación de un proxy exclusivo por perfil.
- Mantener fija la configuración de la huella digital entre inicios de sesión.
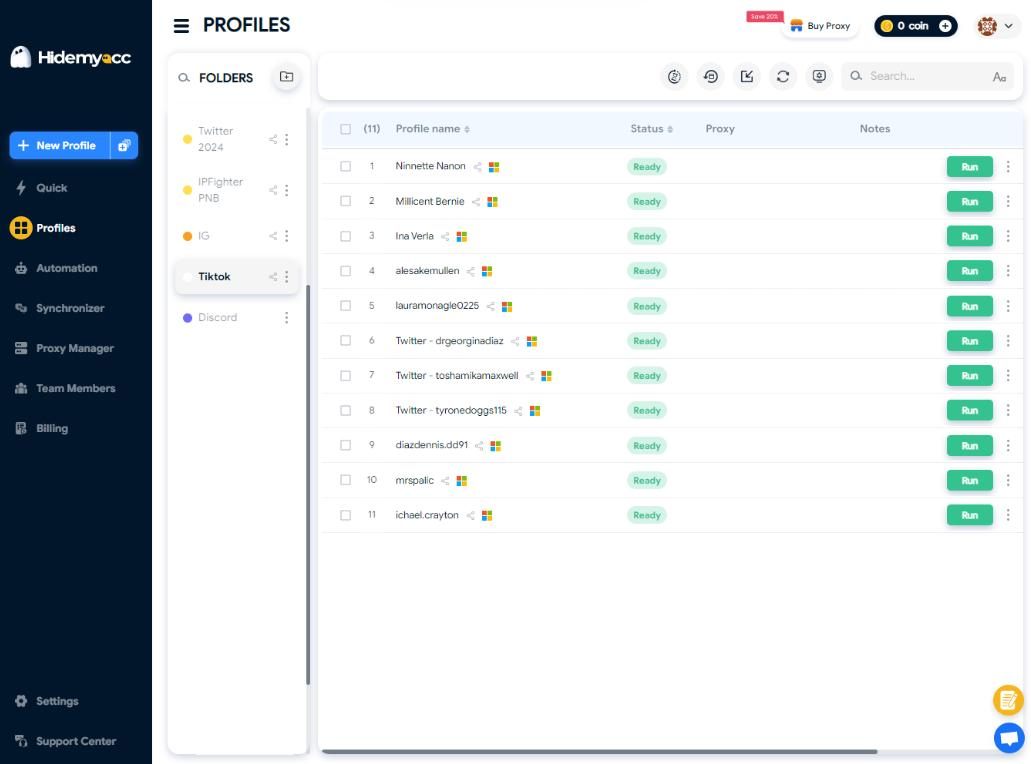
Este es el motivo por el cual muchos desarrolladores combinan el navegador antidetect Hidemyacc con Selenium, Playwright o Puppeteer. En vez de permitir que el script abra ventanas genéricas desprotegidas, el scraper se conecta directamente a perfiles gestionados por Hidemyacc mediante CDP, garantizando entornos independientes y estables.
8.4. Añadir tiempos de espera para simular el comportamiento humano
Instagram no solo contabiliza el volumen total de peticiones, sino también el ritmo de interacción. Un script que abra perfiles, desplace la página y envíe decenas de solicitudes en pocos segundos actuará de forma contraria a la de un usuario real, activando captchas o restricciones por Action Block.
Para hacer que el flujo resulte más natural, ajuste su código con estas pautas:
- Incluya pausas aleatorias entre peticiones en lugar de utilizar intervalos idénticos y fijos.
- Desplace la pantalla de manera escalonada para que el contenido dinámico cargue gradualmente.
- Realice pausas breves al cambiar de perfil o al buscar un nuevo hashtag.
- Establezca un límite diario de perfiles a consultar por sesión de trabajo.
Aunque moderar la velocidad incrementa la duración del proceso de recolección, a cambio garantiza la estabilidad de las sesiones y minimiza las alertas automáticas de la plataforma.
Lectura recomendada: Cómo solucionar el error de sospecha de comportamiento automatizado en cuentas de Instagram
8.5. Supervisar modificaciones en el DOM y en los endpoints
Instagram actualiza con regularidad su código HTML, sus clases CSS y los endpoints internos de su versión web. Por esta razón, un scraper que funcione con normalidad hoy puede devolver campos vacíos mañana si la plataforma renueva su interfaz.
Puntos de control periódicos:
- Selectores de perfiles y publicaciones.
- Estructura de las respuestas de los endpoints.
- Esquema de salida de los archivos JSON.
- Porcentaje de errores en peticiones o datos incompletos.
Un mantenimiento preventivo previene caídas prolongadas del sistema y reduce el tiempo necesario para resolver desajustes cuando la plataforma aplique cambios en su web.
9. Errores habituales al recopilar datos en Instagram
Incluso utilizando herramientas adecuadas, una tarea de extracción puede verse interrumpida por bloqueos o checkpoints si se cometen fallos de planteamiento. Los siguientes descuidos explican la mayoría de las restricciones:
- Compartir el mismo proxy o la misma IP entre varias cuentas: Al operar múltiples perfiles desde una sola dirección de red, Instagram asociará fácilmente las sesiones. Es indispensable utilizar proxies independientes para evitar sanciones en bloque.
- No regular la cadencia de peticiones: Enviar decenas de consultas en pocos segundos es un comportamiento puramente mecánico. Agregar intervalos aleatorios y dividir el trabajo en lotes pequeños asegura mayor estabilidad operativa.
- Ignorar las condiciones del servicio de Meta: El scraping debe orientarse estrictamente a datos públicos con fines legítimos, como estudios de mercado o análisis de contenidos. Intentar acceder a datos privados eleva notablemente el riesgo técnico y legal.
- Verificar solo el script sin revisar la calidad de los datos extraídos: Un scraper puede ejecutarse sin arrojar errores pero haber recopilado textos incompletos o fechas erróneas. Compruebe siempre muestras aleatorias de los datos finales antes de integrarlos en sus informes.
Evitar estas prácticas garantizará procesos de extracción más seguros y reducirá drásticamente la posibilidad de que sus cuentas de Instagram sean suspendidas durante su uso.
10. Conclusiones
El scraping de Instagram se consolida como una de las vías más eficaces para recopilar datos de acceso público destinados al análisis de la competencia, estudios de mercado y detección de tendencias. Según la envergadura del proyecto, puede optar por procedimientos manuales, herramientas de código abierto, servicios de API administrados o el desarrollo de soluciones propias con Selenium, Playwright o Puppeteer.
Con todo, la elección de las librerías es solo una parte del trabajo. Para lograr que la extracción opere con solidez en el largo plazo, es imprescindible gestionar con rigor los proxies, las huellas digitales, las sesiones activas y el ritmo de peticiones de cada cuenta. Mantener entornos limpios, aislados y coherentes reducirá al mínimo los bloqueos por Action Block o Checkpoint, elevando la calidad de los datos recopilados.
Si está diseñando un sistema para extraer datos con múltiples cuentas de Instagram, dé prioridad a la seguridad y al aislamiento de los entornos antes que a la velocidad de recolección.
Artículos recomendados:
- Las mejores herramientas para el scraping de datos en X (Twitter)
- Guía de proxies para Google Scraping: los 7 proveedores más destacados para 2026
- Guía de LinkedIn Scraping orientada a marketing y prospección B2B
- Herramientas gratuitas de IA para web scraping que debe conocer
12. FAQ
1. ¿Es legal el scraping de Instagram?
La recopilación de información pública disponible en la web ha sido respaldada en diversas resoluciones judiciales, aunque la automatización contraviene las Condiciones del servicio de Meta. Si extrae datos públicos con fines de investigación o inteligencia comercial, asegúrese de cumplir las leyes de privacidad aplicables y las directrices de la plataforma.
2. ¿Se pueden extraer datos de cuentas privadas de Instagram?
No. El scraping convencional se limita a datos visibles de acceso público, como publicaciones, hashtags o biografías abiertas. Los contenidos de perfiles privados no están accesibles sin las debidas autorizaciones de acceso.
3. ¿En qué se diferencian la Instagram Graph API y el web scraping?
La Graph API es la solución homologada por Meta: exige que la cuenta conceda permisos expresos y está pensada para la gestión corporativa de activos propios. El web scraping procesa directamente la información representada en la versión web abierta, por lo que resulta ideal para evaluar a la competencia e investigar el mercado.
4. ¿La extracción de listados de seguidores puede provocar el bloqueo de cuentas?
Sí. Consultar listas de seguidores de forma masiva o con frecuencias atípicas activa fácilmente los filtros de seguridad de Instagram, desencadenando captchas, checkpoints o bloqueos de acciones. Aplicar cadencias moderadas y pausas razonables ayuda a mitigar estos riesgos.
5. ¿Qué herramienta de extracción es más aconsejable para principiantes?
Para usuarios sin experiencia en programación, servicios como Apify o PhantomBuster resultan muy accesibles gracias a sus plantillas y paneles gráficos. Si se tienen conocimientos básicos de Python, librerías como Instaloader aportan mayor flexibilidad y ahorro de costes.