¿Desea recopilar datos de productos, precios, reseñas o información de vendedores en Amazon pero no sabe qué método elegir? Escribir su propio scraper le otorga control total sobre el proceso, mientras que los navegadores headless, las APIs oficiales y los servicios de scraping comerciales se adaptan a distintas necesidades operativas. Una mala elección técnica puede traducirse en procesos lentos, difíciles de escalar o interrumpidos constantemente por CAPTCHAs y restricciones de acceso. Este artículo analiza los métodos más habituales para extraer datos de Amazon con el fin de ayudarle a definir la ruta más conveniente.
1. ¿Qué es un scraper de Amazon y cómo funciona?
Un scraper de Amazon es una herramienta o script programado para extraer datos de forma automática en lugar de tener que abrir cada página y copiar la información a mano. En función de sus objetivos de negocio, puede obtener nombres de productos, códigos ASIN, precios actualizados, valoraciones en estrellas, volumen de opiniones, datos del vendedor o disponibilidad de inventario.
El flujo básico comienza enviando una solicitud HTTP a la URL del producto para recibir el código HTML o las respuestas JSON correspondientes. A continuación, el scraper localiza los campos deseados mediante selectores CSS o expresiones XPath, extrae los valores y los almacena en archivos estructurados o bases de datos para su análisis posterior.
Por ejemplo, si únicamente necesita supervisar el precio diario de una decena de artículos, un script sencillo en Python es más que suficiente. Cuando el catálogo a rastrear crece a miles de productos o los datos requeridos son más complejos, se suele migrar hacia navegadores automatizados, APIs oficiales o servicios especializados de scraping API.
2. Crear un script propio con Requests + BeautifulSoup/Scrapy
Si posee conocimientos de Python y busca un control absoluto sobre el procedimiento de recolección, combinar Requests con BeautifulSoup o Scrapy es un punto de partida habitual. En lugar de ejecutar un navegador completo, el script emite solicitudes directas a las URLs de Amazon, descarga el contenido HTML y localiza las etiquetas pertinentes.
Para una ficha de producto básica, un ejemplo de código para capturar el título y el precio sería el siguiente:
import requests
from bs4 import BeautifulSoup

url = "https://www.amazon.com/dp/PRODUCT_ID"

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

# Enviar la solicitud y recibir el contenido HTML
response = requests.get(url, headers=headers, timeout=10)

soup = BeautifulSoup(response.text, "html.parser")

title = soup.select_one("#productTitle")
price = soup.select_one(".a-price .a-offscreen")

print("Producto:", title.get_text(strip=True) if title else "N/A")
print("Precio:", price.get_text(strip=True) if price else "N/A")
La ventaja central de esta alternativa es la libertad técnica: usted define los selectores, el formato de salida y el destino de almacenamiento. Además, el coste inicial es prácticamente nulo, ya que se apoya en librerías de código abierto.
Sin embargo, la mayor dificultad reside en el mantenimiento constante. Amazon suele mostrar CAPTCHAs, aplicar limitaciones de peticiones o alterar la maquetación HTML, lo que provoca que los selectores dejen de funcionar de forma repentina. Asimismo, le corresponderá gestionar por cuenta propia la rotación de proxies, el encabezado User-Agent, los errores de red y la lógica de reintentos.
Este enfoque resulta idóneo para desarrolladores que manejan volúmenes moderados. Por ejemplo, quien gestiona un modelo de dropshipping y necesita comprobar los precios de unos 50 productos al día puede recurrir a un script propio en lugar de contratar plataformas de pago.
3. Uso de navegadores headless con Puppeteer, Selenium o Playwright
No todo el contenido de Amazon está presente en la respuesta HTML estática inicial. Determinados bloques exigen la ejecución de JavaScript en el cliente para mostrarse o actualizarse. En estos escenarios, herramientas de automatización como Puppeteer, Selenium o Playwright superan claramente a las solicitudes HTTP básicas.
Su operativa replica la de un navegador estándar: el programa abre la URL, espera a que el contenido dinámico termine de cargarse y extrae los datos directamente de la interfaz renderizada. Con Playwright, es posible obtener la puntuación de un producto con este fragmento:
from playwright.sync_api import sync_playwright

url = "https://www.amazon.com/dp/PRODUCT_ID"

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True)
    page = browser.new_page()

    page.goto(url, wait_until="domcontentloaded")
    page.wait_for_selector("#acrPopover")

    rating = page.locator("#acrPopover").inner_text()

    print("Valoración:", rating)

    browser.close()
La principal fortaleza de este método reside en su capacidad para interactuar con páginas dinámicas, desplazarse verticalmente y esperar elementos interactivos antes de parsear los datos.
En contrapartida, los navegadores headless demandan significativamente más recursos de hardware (memoria RAM y CPU). La velocidad de recolección es menor en comparación con el envío de peticiones HTTP directas. Además, utilizar un navegador automatizado no evita los sistemas de detección antibot, que a menudo identifican parámetros propios de entornos automatizados.
Es una alternativa a considerar cuando los datos requeridos dependen de JavaScript o cuando la navegación contempla varios pasos secuenciales, como la consulta de variantes complejas o reseñas dinámicas.
4. Amazon Product Advertising API y Creators API
En lugar de procesar el código HTML de las páginas de Amazon, puede recurrir a las APIs oficiales provistas por la propia compañía si cumple con los requisitos de acceso. Mediante este canal, su aplicación realiza consultas directas a los servidores de Amazon y recibe información estructurada y homologada.
Esta opción elimina la necesidad de buscar selectores en el DOM o lidiar con bloqueos técnicos. Los datos se reciben en campos estandarizados, lo que simplifica su posterior integración en bases de datos o sistemas analíticos.
No obstante, estas APIs no están al alcance de cualquier proyecto de forma inmediata. La admisión, las cuotas de consulta y los límites por hora dependen de normativas comerciales estrictas de Amazon. Antes de diseñar una integración, verifique las condiciones actuales y si los campos que precisa están disponibles.
Asimismo, Amazon ha venido migrando de la Product Advertising API 5 hacia la Creators API. Si proyecta una solución a largo plazo, consulte la documentación oficial más reciente en lugar de guiarse por manuales desactualizados.
Para quienes reúnen los requisitos y necesitan un flujo de datos limpio y con respaldo normativo, este método resulta mucho más sostenible que el raspado continuo de HTML.
5. Servicios comerciales de scraping API
Las APIs de scraping de pago son adecuadas para proyectos que demandan extraer datos de Amazon de forma recurrente sin asumir el desarrollo y soporte de una infraestructura compleja. En lugar de gestionar proxies, resolver captchas o mantener servidores, basta con enviar una petición a la API para recibir la información estructurada.
Cada plataforma presenta características distintas: algunas cuentan con endpoints especializados para Amazon, mientras que otras destacan por su red de proxies, su capacidad de renderizado dinámico o sus entornos de ejecución en la nube. A continuación se presentan las más destacadas:
5.1 Bright Data
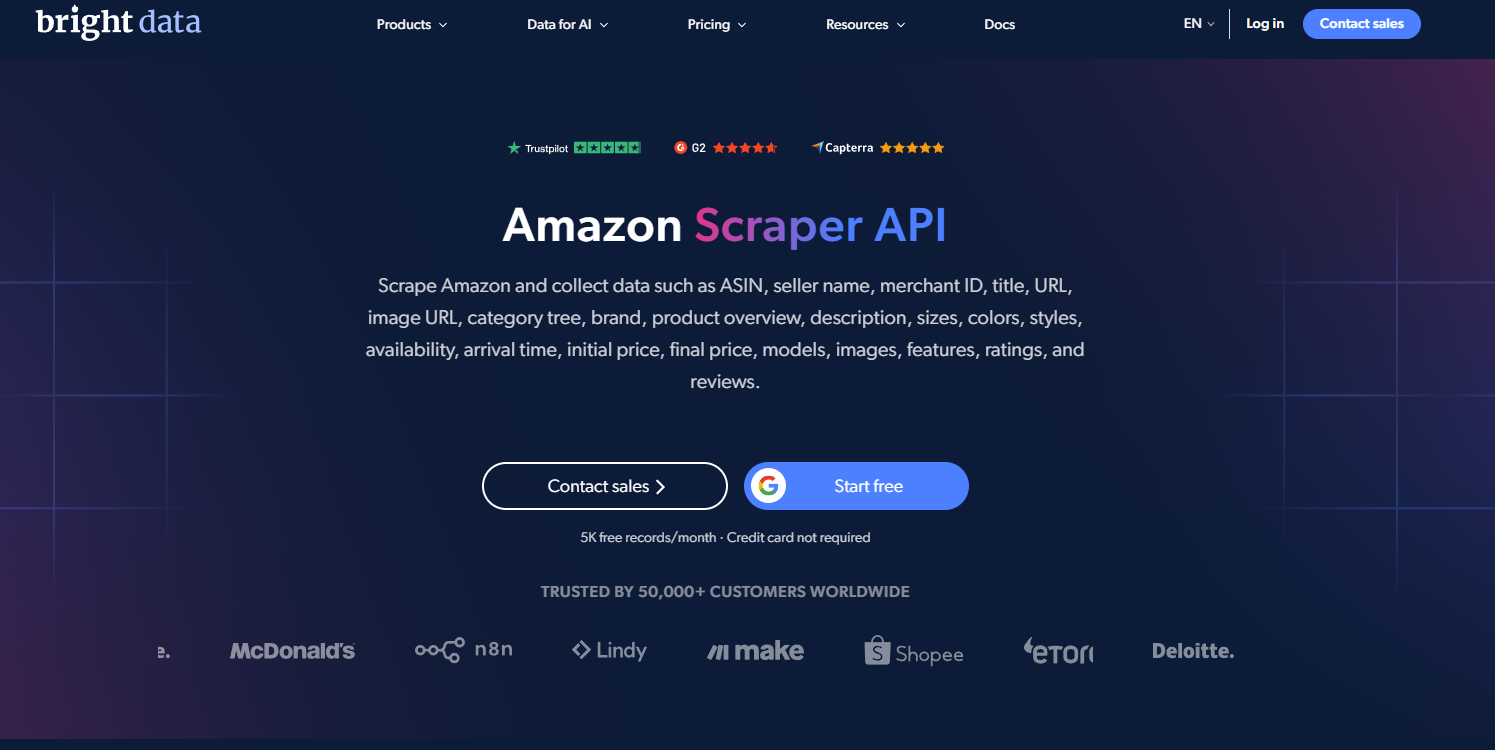
Bright Data ofrece una Amazon Scraper API que permite recopilar información de Amazon sin necesidad de construir scrapers ni gestionar redes de proxies residenciales. Está concebida para proyectos que requieren un gran volumen de datos.
Funcionalidades principales:
- Amazon Scraper API: Extrae datos de productos, precios, opiniones y resultados de búsqueda a través de peticiones estandarizadas.
- Datos estructurados: Devuelve la información formateada en JSON, lista para su integración directa.
- Proxies integrados: Acceso a redes de proxies residenciales y móviles con amplia cobertura geográfica.
- Web Unlocker: Algoritmos automatizados para eludir bloqueos, resolver CAPTCHAs y gestionar huellas digitales.
Estas características disminuyen la carga operativa en proyectos de gran envergadura.
Ventajas:
- Alta escalabilidad: Capacidad de procesar millones de páginas y consultas simultáneas.
- Infraestructura de proxies avanzada: Gran variedad de opciones de red y geolocalización precisa.
- Ahorro de recursos técnicos: Despreocupación por el mantenimiento de servidores de rastreo o bypass de firewalls.
- Múltiples tipos de datos: Útil para monitorizar precios, listados de búsqueda, detalles de catálogo y reseñas.
A pesar de su potencia, existen puntos a valorar:
Inconvenientes:
- Coste: Las tarifas por consumo pueden ser elevadas con altos volúmenes de peticiones.
- Curva de aprendizaje: La amplitud de opciones de la consola exige tiempo de adaptación inicial.
- Conocimientos técnicos: Su integración profunda requiere familiaridad con arquitecturas de API y tratamiento de datos.
Bright Data se orienta a empresas y equipos de desarrollo con necesidades de extracción a gran escala. Para demandas más reducidas, existen alternativas más simples y asequibles.
5.2 Oxylabs
Oxylabs cuenta con una Amazon Scraper API respaldada por su propia red de proxies, orientada a proyectos corporativos de comercio electrónico que precisan monitorización continua.
Funcionalidades principales:
- Amazon Scraper API: Recopilación de fichas de producto, precios, reseñas y posiciones en búsquedas.
- Formato estructurado: Entrega de datos limpios en JSON para facilitar su almacenamiento y análisis.
- Proxies residenciales integrados: Acceso a un pool residencial para consultar precios localizados por código postal.
- Modelos de extracción adaptables: Algoritmos diseñados para resistir cambios repentinos en la maquetación de Amazon.
Estas ventajas la posicionan con fuerza en el sector e-commerce:
Ventajas:
- Especialización en gran volumen: Infraestructura robusta preparada para flujos continuos de datos.
- Solución integral: Combina software de extracción y red de proxies en una misma suscripción.
- Cobertura e-commerce completa: Abarca páginas de producto, anuncios patrocinados y valoraciones.
- Garantías de servicio (SLA): Altos índices de disponibilidad y éxito en las peticiones.
No obstante, convienen considerar ciertos aspectos:
Inconvenientes:
- Coste elevado: Los planes de entrada suelen quedar fuera del alcance de presupuestos pequeños.
- Integración técnica: Requiere desarrollo de software para conectar los endpoints con sistemas internos.
- Innecesario para tareas menores: Resulta poco práctico si solo se pretende rastrear unos pocos productos de forma esporádica.
Oxylabs es adecuada para compañías que necesitan consultar información de Amazon con regularidad y exigen fiabilidad y alta disponibilidad.
5.3 ScraperAPI
ScraperAPI apuesta por la simplicidad ofreciendo endpoints prediseñados para Amazon. La ventaja es que entrega datos limpios en JSON para los formatos admitidos sin necesidad de escribir código de parseo HTML.
Funcionalidades principales:
- Product API: Recoge detalles, especificaciones y datos de la Buy Box de productos.
- Search API: Obtiene listados de resultados a partir de palabras clave.
- Offers API: Consulta ofertas de vendedores externos y precios asociados.
- Reviews API: Extrae valoraciones y comentarios de clientes.
- Salida en JSON: Respuestas limpias y estructuradas de fácil consumo.
Su enfoque modular aporta agilidad al desarrollo:
Ventajas:
- Fácil integración: Conexión ágil mediante peticiones REST estándar.
- Sin mantenimiento de selectores: Evita la necesidad de actualizar expresiones CSS o XPath continuamente.
- Variedad de casos de uso: Cubre búsquedas, productos, ofertas y opiniones.
- Adaptable a proyectos medianos: No exige desplegar arquitecturas complejas para comenzar.
A pesar de su sencillez, presenta ciertas limitaciones:
Inconvenientes:
- Consumo de créditos: Ciertos endpoints y el renderizado JavaScript consumen múltiples créditos por llamada.
- Coste progresivo: El gasto mensual aumenta con rapidez si el volumen de solicitudes se dispara.
- Personalización limitada: Los campos que no formen parte del esquema JSON estándar deben extraerse manualmente del HTML.
5.4 Apify Amazon Scraper
Apify proporciona diversos módulos listos para usar denominados Actors, lo que permite extraer datos de Amazon sin redactar código desde cero. Ofrece tanto un panel web visual como acceso por API, adaptándose a distintos perfiles técnicos.
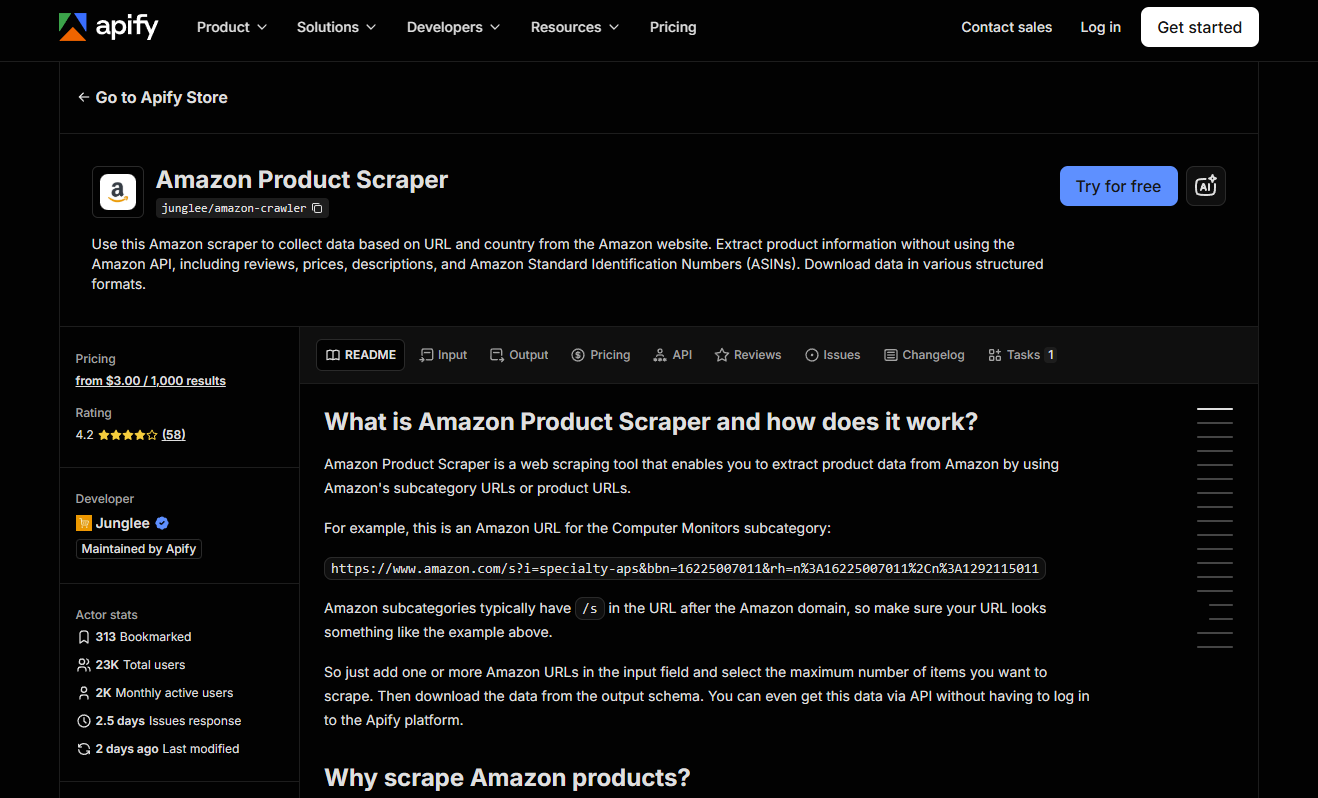
Funcionalidades principales:
- Amazon Product Scraper: Recopila títulos, precios, variantes y datos de ficha de producto.
- Amazon Search Scraper: Extrae listados completos de productos por término de búsqueda.
- Amazon Reviews Scraper: Descarga valoraciones de compradores, texto y archivos multimedia.
- API y automatización: Permite ejecutar Actors mediante llamadas remotas y sincronizar salidas con la nube.
Su versatilidad facilita arrancar con plantillas antes de abordar desarrollos a medida:
Ventajas:
- Plantillas listas para usar: Reduce los tiempos iniciales de programación.
- Entorno amigable: Posibilidad de configurar y lanzar tareas desde el navegador sin escribir código.
- Acceso programático: Flexibilidad para conectar salidas con pipelines analíticos.
- Exportación múltiple: Soporta formatos CSV, JSON, Excel o XML.
No obstante, la dependencia de Actors comunitarios exige precaución:
Inconvenientes:
- Estabilidad variable: El correcto funcionamiento depende de la frecuencia de actualización del desarrollador del Actor.
- Sensibilidad a cambios de diseño: Modificaciones en la interfaz de Amazon pueden romper el script temporalmente.
- Coste según recursos: El consumo de unidades de cómputo y proxies incide en el coste total.
Apify resulta práctico para analistas, equipos reducidos o programadores que buscan agilidad sin renunciar a la opción de integrar los flujos por API.
5.5 Zyte
Zyte combina su API con Scrapy Cloud, apuntando a proyectos que precisan flujos de extracción personalizados. En lugar de depender de herramientas cerradas, Zyte se articula con el framework Scrapy para otorgar un control total sobre el rastreo y tratamiento de datos.
Funcionalidades principales:
- Zyte API: Interfaz de desbloqueo automatizado que gestiona proxies, encabezados y barreras antibot.
- Scrapy Cloud: Plataforma en la nube para hospedar, programar y monitorizar spiders de Scrapy.
- Renderizado dinámico: Capacidad de procesar páginas que dependen de JavaScript.
- Lógica personalizada: Libertad total para diseñar el pipeline de parsing según los campos requeridos.
Zyte destaca cuando el proyecto exige desarrollos con especificaciones particulares:
Ventajas:
- Máxima flexibilidad: Ideal para scrapers con requerimientos de lógica propios.
- Sinergia con Scrapy: Adopción natural para equipos habituados a este framework en Python.
- Alojamiento en la nube gestionado: Ahorro en tareas de mantenimiento de servidores locales.
- Escalabilidad a largo plazo: Permite pasar de pequeñas arañas web a infraestructuras amplias.
Por contra, no es la alternativa más directa para extracciones rápidas de bajo volumen:
Inconvenientes:
- Barrera técnica: Requiere dominar Python, Scrapy y arquitectura de rastreadores web.
- Tiempo de implantación: Desarrollar spiders propios lleva más tiempo que llamar a una API empaquetada.
- Complejidad para tareas básicas: Puede resultar sobredimensionado para consultas puntuales.
Zyte es una solución aconsejable para equipos de ingeniería que construyen pipelines propios para Amazon integrados en ecosistemas de datos más amplios.
5.6 ScrapingBee
ScrapingBee es una API de web scraping de propósito general aplicable a múltiples plataformas, incluida Amazon. Se centra en gestionar peticiones, proxies y renderizado JavaScript de forma transparente para evitar la administración de navegadores automatizados locales.
Funcionalidades principales:
- Renderizado con JavaScript: Ejecución de scripts en el navegador para que las páginas carguen completamente.
- Rotación de proxies: Manejo de direcciones IP residenciales y de centros de datos por solicitud.
- API concisa: Envío de la URL con parámetros para obtener el HTML renderizado o respuestas parseadas.
- Uso transversal: Misma clave de API válida para Amazon y otros sitios de comercio electrónico.
Su enfoque destaca por la sencillez y versatilidad multisitio:
Ventajas:
- Fácil implementación: Prescinde del mantenimiento de navegadores headless y pools de proxies propios.
- Soporte para contenido dinámico: Procesa eficazmente elementos cargados asíncronamente.
- Versatilidad: Aplicable a diversos portales de comercio electrónico dentro del mismo proyecto.
- Precios predecibles: Paquetes de suscripción basados en créditos consumidos.
Sin embargo, al no ser un producto enfocado exclusivamente en Amazon, conviene considerar:
Inconvenientes:
- Sin endpoints específicos de Amazon: Carece de modelos dedicados que entreguen JSON formateado de forma nativa.
- Extracción manual: Es habitual tener que parsear el HTML devuelto para aislar los campos necesarios.
- Multiplicadores de créditos: El renderizado JavaScript y los proxies avanzados descuentan más créditos por llamada.
ScrapingBee se adapta a proyectos medianos que buscan una API de desbloqueo sencilla, especialmente si Amazon es solo una de las diversas fuentes a rastrear.
5.7 Comparativa rápida de herramientas de scraping para Amazon
La siguiente tabla resume las herramientas analizadas en función de su especialización en Amazon, disponibilidad de API, proxies integrados y nivel de dificultad:
| Herramienta | Scraper de Amazon disponible | API | Proxies | Dificultad de configuración | Perfil recomendado |
|---|---|---|---|---|---|
| Bright Data | ✓ | ✓ | ✓ | Media | Escala corporativa |
| Oxylabs | ✓ | ✓ | ✓ | Media | E-commerce avanzado |
| ScraperAPI | ✓ (Endpoints estructurados dedicados) | ✓ | ✓ | Baja | Desarrolladores y startups |
| Apify | ✓ (Mediante Actors de la comunidad) | ✓ | Disponible | Baja | Sin código + flujos API |
| Zyte | Según el flujo (API + Scrapy Cloud) | ✓ | ✓ | Media | Equipos técnicos con Scrapy |
| ScrapingBee | Genérico (no exclusivo de Amazon) | ✓ | ✓ | Baja | Proyectos medianos multisitio |
Para operaciones a gran escala, Bright Data y Oxylabs aportan una infraestructura sólida. ScraperAPI facilita la integración directa con salidas estructuradas en JSON. Apify es muy conveniente para ensayos rápidos con plantillas, mientras que Zyte encaja con equipos experimentados en Scrapy. Para proyectos que recopilan datos de múltiples tiendas además de Amazon, ScrapingBee es una opción adecuada.
6. Comparativa general: 4 métodos para hacer scraping en Amazon
Los cuatro métodos principales presentan diferencias claras en términos de inversión económica, complejidad técnica, evasión de bloqueos y escalabilidad:
| Método | Coste | Dificultad de implementación | Capacidad antibloqueo | Estabilidad a largo plazo | Escala recomendada |
|---|---|---|---|---|---|
| Script propio (Requests) | Bajo | Alta | Baja a media | Baja (sensible a cambios de HTML) | Individual, bajo volumen |
| Navegador headless | Bajo a medio | Alta | Media | Media | Páginas con JavaScript dinámico |
| Canal oficial (Creators API) | Medio (según requisitos de acceso) | Baja | No aplica (acceso oficial y legítimo) | Alta (manteniendo la cuenta activa) | Afiliados, aplicaciones autorizadas |
| Scraping API comercial | Medio a alto | Baja | Alta | Alta | Empresas, operaciones a gran escala |
El código a medida ofrece adaptabilidad a bajo coste, pero demanda atención continua ante roturas de selectores y bloqueos de red. Los navegadores headless resuelven la carga dinámica de JavaScript, aunque consumen más recursos computacionales.
La Creators API es la opción preferente si se cumplen los requisitos de acceso y se prioriza la estabilidad normativa. Para proyectos que necesitan procesar grandes volúmenes de datos sin asumir el mantenimiento de infraestructura, las APIs de scraping comerciales ofrecen la alternativa más práctica.
7. ¿Por qué es más difícil extraer datos de Amazon que de otros sitios?
Amazon cuenta con un catálogo inmenso, pero también implementa sistemas avanzados para supervisar y restringir los accesos automatizados. A diferencia de portales con contenido estático, enviar peticiones de forma continua a Amazon activa rápidamente barreras de seguridad cuando los patrones de tráfico se consideran anómalos.
Entre los obstáculos técnicos más habituales destacan:
- Límites de frecuencia (Rate Limits): Enviar un número excesivo de peticiones en ventanas breves provoca cortes temporales de acceso o respuestas vacías.
- Desafíos CAPTCHA y pantallas de verificación: Al detectar patrones no habituales, Amazon muestra pruebas CAPTCHA de texto o imágenes que detienen el script.
- Alteraciones continuas en la estructura DOM: El código HTML y las clases de los elementos se actualizan periódicamente, lo que rompe selectores rígidos en scripts propios.
- Contenido dependiente de JavaScript: Muchos campos relevantes (precios de la Buy Box, condiciones de envío o reseñas) se renderizan dinámicamente en el cliente.
- Seguimiento por sesiones y cookies: Ciertas consultas exigen gestionar cookies, mantener sesiones activas y definir códigos postales para ver precios regionales, controlando además las huellas digitales del navegador.
- Complejidad para escalar: Rastrear unas pocas decenas de productos es sencillo, pero procesar cientos de miles de páginas exige gestionar redes de proxies, concurrencia, reintentos y almacenamiento ordenado.
Estos aspectos justifican las ventajas y desventajas de cada opción: los scripts ligeros son económicos pero frágiles, los navegadores headless procesan contenido dinámico con alto consumo de recursos, y las APIs oficiales o de pago eliminan la carga técnica a cambio de costes periódicos o requisitos normativos.
8. Buenas prácticas para hacer scraping en Amazon de forma segura
La fiabilidad de un scraper depende directamente de su arquitectura. La forma de pautar las peticiones, gestionar las sesiones y manejar los errores influye en la continuidad del proceso. Considere las siguientes pautas:
- Regular la cadencia de peticiones: Evite ráfagas de consultas simultáneas. Introduzca tiempos de espera aleatorios para simular los intervalos de lectura de un usuario real.
- Utilizar proxies adecuados: Seleccione redes de proxies según la escala requerida. En tareas voluminosas o con precios geolocalizados, los proxies residenciales ofrecen mayor estabilidad ante bloqueos.
- Aislar sesiones y cookies: Gestione de forma separada las cookies de sesión, tokens y preferencias regionales. Mantener los entornos estancos evita cruces de datos entre tareas simultáneas.
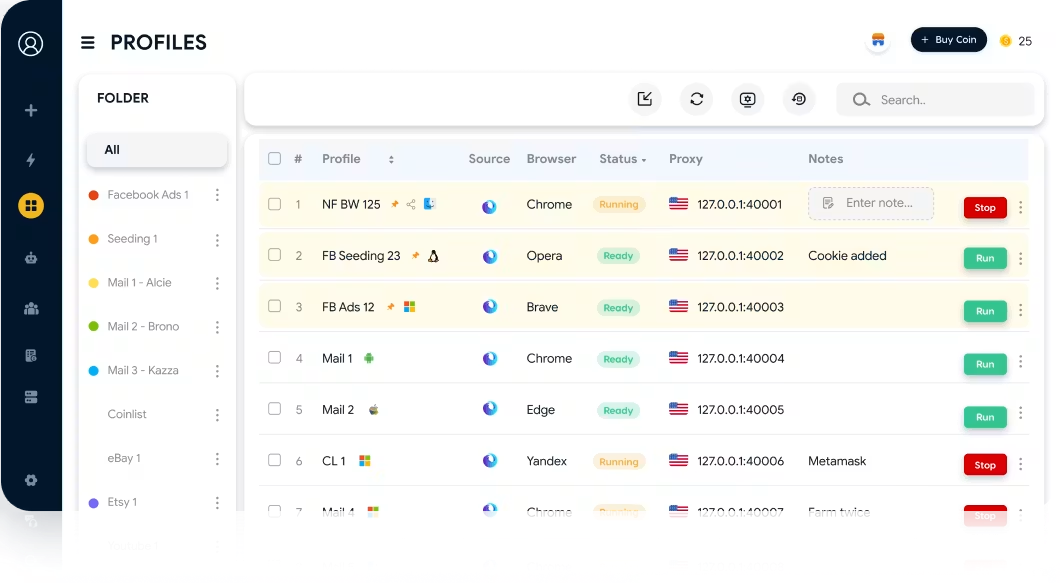
- Separar perfiles de navegador: En automatizaciones con navegador, utilice el navegador antidetect Hidemyacc para estructurar perfiles independientes. Cada tarea operará con una huella digital, sesión y proxy diferenciados.
- Implementar políticas de reintento inteligente: Las peticiones pueden fallar por microcortes de red o respuestas incompletas. Incluya reintentos con esperas exponenciales (exponential backoff) para que un error aislado no detenga todo el trabajo.
- Revisar los términos de servicio: Antes de recolectar datos, examine las Condiciones de uso de Amazon, las directrices de sus APIs y las leyes de privacidad aplicables según la finalidad de la información.
Estas prácticas refuerzan la solidez del sistema, en especial cuando se gestionan procesos concurrentes sobre catálogos amplios.
Más información sobre infraestructura de proxies:
- Los mejores proveedores de proxies para Amazon: impulse sus ventas multicuenta con seguridad
- Proxy móvil: características, ventajas y formas de uso
- Proxy residencial: funcionamiento y razones para utilizarlo
- ¿Qué es un proxy de centro de datos? Todo lo que necesita saber
- Proxies residenciales vs. de centro de datos: diferencias y cómo elegir el adecuado
9. Errores habituales al poner en marcha un scraper de Amazon
Muchos scrapers fallan no por fallos de sintaxis en el código, sino por deficiencias en el diseño inicial del flujo de trabajo. Entre los errores más comunes se encuentran:
- Elegir una herramienta solo por su facilidad inicial: Un script elemental puede funcionar para un ensayo breve, pero fallar al escalar. Diseñe la solución contemplando el volumen total y la frecuencia de actualización desde el principio.
- Aplicar el mismo método para todos los tipos de páginas: Las fichas de producto, las listas de búsqueda y los paneles de ofertas presentan estructuras y cargas dinámicas diferentes; un mismo extractor rara vez sirve para todo.
- Depender de selectores CSS frágiles: Basar el scraper en clases HTML generadas automáticamente provoca fallos con cada actualización estética de la web. Siempre que sea viable, recurra a expresiones XPath estables o extraiga los bloques JSON-LD embebidos.
- Desestimar los cuellos de botella al escalar: Un script que procesa 50 productos sin problemas puede agotar la memoria o bloquear hilos de ejecución al enfrentarse a decenas de miles de URLs.
- Subestimar el mantenimiento continuo: Un scraper exige revisiones periódicas. Las modificaciones de Amazon, los ajustes en las defensas antibot y los nuevos requisitos de datos implican tiempo de soporte técnico.
- Evaluar las APIs de scraping solo por su precio unitario: La tarifa por petición no es el único factor relevante. Valore también la tasa de éxito, la velocidad de respuesta, el soporte de desbloqueo y los factores de consumo de créditos.
Una planificación rigurosa en la etapa inicial evitará rehacer la infraestructura más adelante cuando aumenten las demandas de recolección.
10. Conclusiones
No existe un único método de scraping para Amazon válido para cualquier proyecto. En tareas pequeñas y con equipo técnico, los scripts propios en Python permiten mantener el control de los datos y recortar costes. Los navegadores headless destacan al procesar contenido dinámico en JavaScript. Por su parte, la Creators API y las APIs de scraping comerciales resultan más aconsejables cuando se priorizan la estabilidad operativa y la escalabilidad continua.
Cuando los flujos de extracción dependen de navegadores automatizados, combinar el proceso con un software de aislamiento facilita la operativa. El navegador antidetect Hidemyacc permite generar y organizar perfiles independientes, enlazando proxies y herramientas de automatización como Puppeteer para sostener ejecuciones estables.
Antes de lanzar su scraper, concrete los campos que necesita recopilar, estime la escala del proyecto y estructure el almacenamiento. Al mismo tiempo, consulte las condiciones de uso de Amazon, las políticas de sus APIs y la legislación aplicable para operar con total garantía.
Artículos relacionados:
- ¿Cómo escalar cuentas de vendedor de Amazon de forma eficaz?
- ¿Por qué se bloquea su cuenta de Amazon? 3 consejos para recuperarla
- Dónde comprar cuentas antiguas de Amazon de forma fiable y segura
11. FAQ
1. ¿Es legal el scraping de Amazon?
La legalidad de recopilar datos accesibles públicamente en la web depende del marco normativo de cada país, del método de obtención y del uso posterior que se dé a la información. Revise las Condiciones de uso de Amazon, las políticas de sus APIs y las leyes de protección de datos aplicables antes de comenzar.
2. ¿Es difícil hacer scraping en Amazon con Python?
Extraer datos básicos de pocas páginas con Requests y BeautifulSoup requiere poco código. Sin embargo, al aumentar la escala, la gestión de CAPTCHAs, los límites de frecuencia, la rotación de proxies y las alteraciones en el HTML añaden complejidad técnica.
3. ¿Cómo saber si Amazon está bloqueando mi scraper?
Las señales más habituales incluyen la aparición de pantallas con CAPTCHA, errores HTTP 403 Forbidden o 503 Service Unavailable, tiempos de espera agotados o respuestas incompletas. Si las solicitudes fallan de forma repetida mientras que las URLs abren bien en un navegador manual, es muy probable que su IP o entorno estén limitados.
4. ¿Conviene utilizar proxies gratuitos para raspar Amazon?
No se recomienda recurrir a proxies gratuitos para flujos de trabajo que requieran continuidad. Este tipo de proxies suele presentar velocidades lentas, baja disponibilidad y figurar en las listas negras de los sistemas de seguridad de Amazon, lo que causa altas tasas de error.
5. ¿Es necesario un navegador antidetect para extraer datos de Amazon?
No en todos los casos. Para proyectos pequeños o procesos basados en APIs, las peticiones HTTP directas con proxies suelen bastar. Un navegador antidetect cobra valor cuando la operativa exige automatizar navegadores con perfiles diferenciados, preservando cookies, proxies y huellas digitales independientes.