¿Desea recopilar precios, etiquetas, reseñas o volúmenes de ventas de miles de productos de Etsy para investigar el mercado, pero copiarlos manualmente resulta demasiado lento? El scraping de Etsy le ayuda a automatizar este proceso; sin embargo, cada alternativa conlleva limitaciones técnicas específicas y riesgos de bloqueo. Este artículo compara 5 métodos populares, desde la API oficial, herramientas sin código, scripts de Python y navegadores automatizados hasta servicios de API de scraping, para que elija la opción adecuada a su volumen de trabajo.
1. ¿Qué es el scraping de Etsy y qué datos se pueden recopilar?
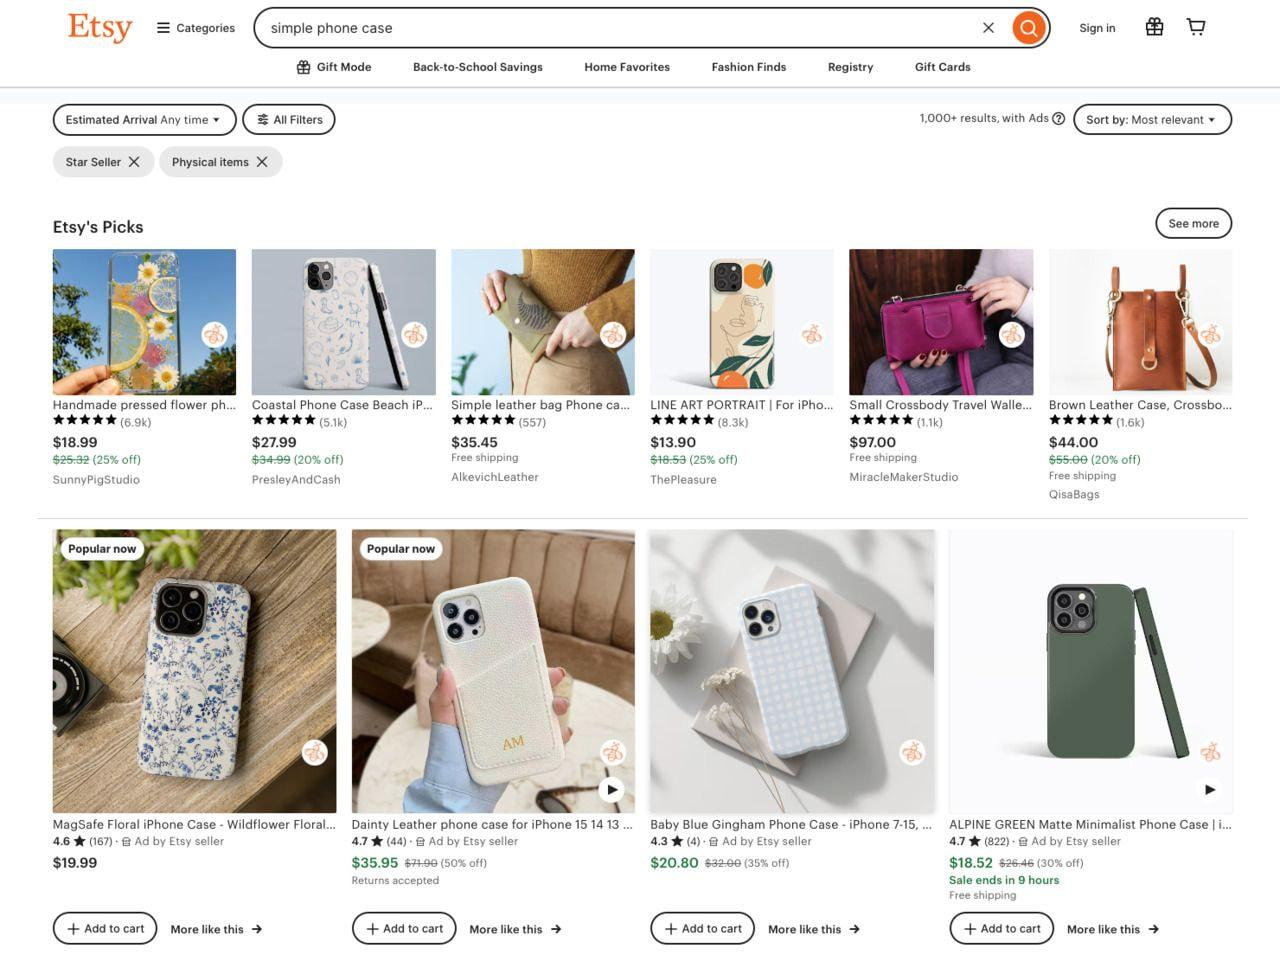
El scraping de Etsy es el proceso de extracción de datos públicos de las páginas de Etsy mediante scripts o herramientas automatizadas en lugar de copiar la información a mano. Con este procedimiento, puede recopilar información detallada de artículos, tiendas o resultados de búsqueda y consolidarla en un archivo estructurado para su posterior análisis.
Datos que se pueden recopilar de Etsy
Según la herramienta y el método implementado, los campos disponibles pueden variar. Las categorías de información más habituales incluyen:
- Datos del producto: Nombre del artículo, URL, imágenes, descripción, categorías y etiquetas (tags).
- Datos de precios: Precio de venta, precio de oferta y unidad monetaria.
- Datos de opiniones: Número de reseñas, puntuación y texto público de las opiniones. Algunas reseñas pueden mostrar el nombre del comprador o identificadores de cuenta. Se trata de información sensible en términos de privacidad que se aborda en la sección legal.
- Datos de la tienda: Nombre de la tienda, cantidad de productos disponibles e información visible en su escaparate.
- Datos de búsqueda y posicionamiento: Resultados por palabra clave, categoría, filtros aplicados y posición orgánica de los artículos.
¿Para qué se utiliza el scraping de datos de Etsy?
Los datos de Etsy se emplean con frecuencia para:
- Investigación de nichos y productos: Descubrir artículos con alta demanda, etiquetas estratégicas y tendencias emergentes.
- Seguimiento de precios y análisis de la competencia: Comparar tarifas, catálogos y ritmo de actualización de distintas tiendas.
- Optimización de publicaciones: Analizar títulos, etiquetas y características recurrentes en artículos de alto rendimiento.
- Análisis de tendencias y valoraciones: Recopilar datos periódicamente para contrastar variaciones y opiniones a lo largo del tiempo.
Cada objetivo requerirá una metodología de recolección distinta. En función del volumen de datos requerido y del nivel de control técnico deseado, podrá seleccionar la opción más conveniente en las secciones siguientes.
Más información: Web Scraping 101: Cómo funciona y aplicaciones prácticas
2. Extracción de datos de Etsy mediante la API oficial
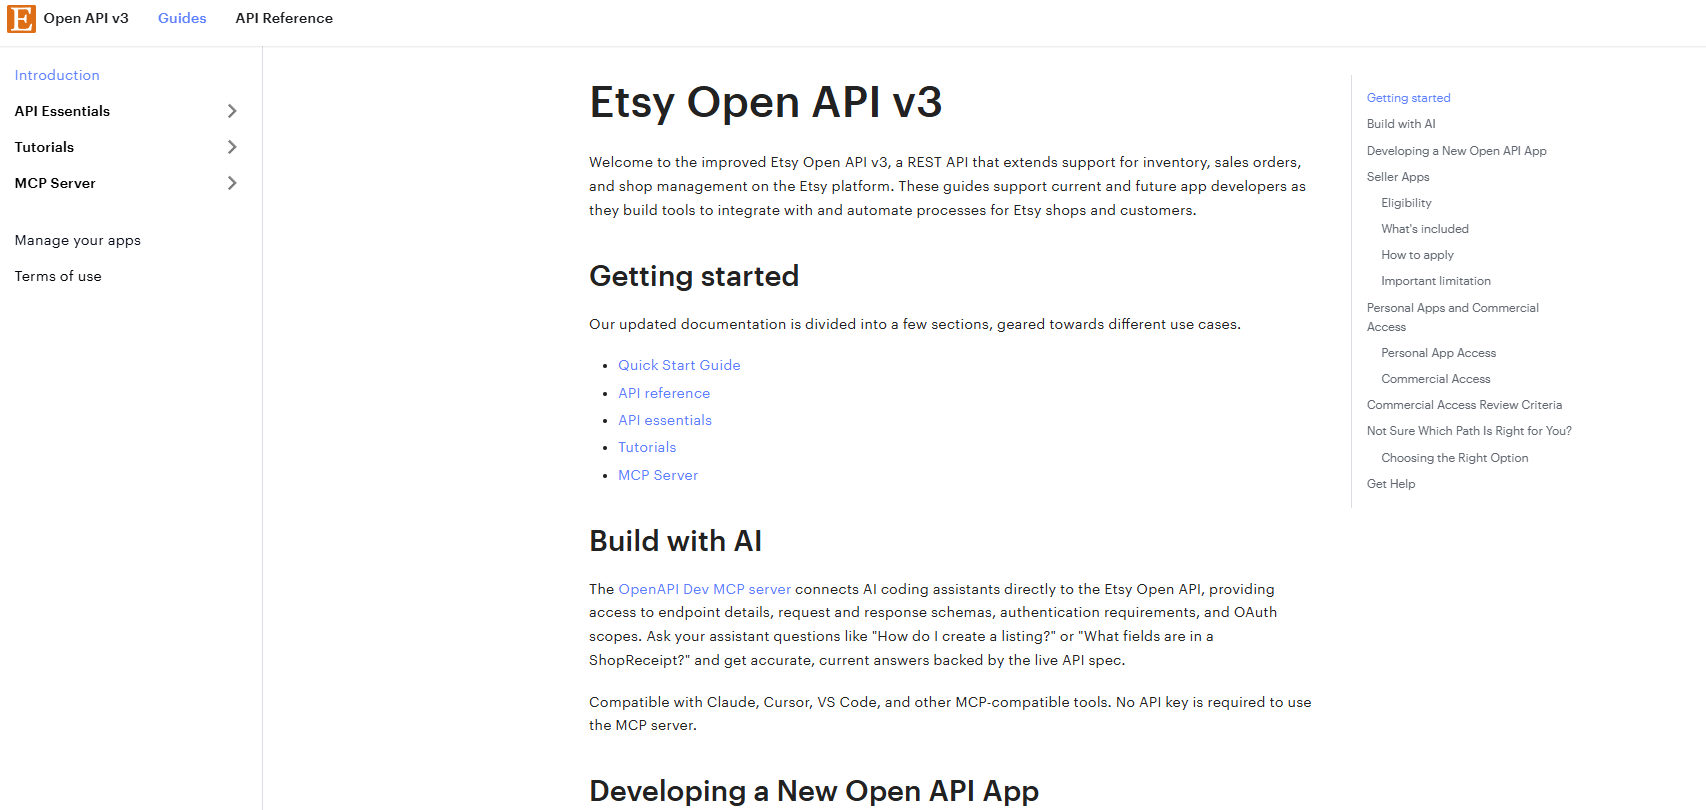
Etsy Open API v3 es el canal oficial para que las aplicaciones externas se conecten con Etsy e ingieran datos a través de los endpoints homologados. En lugar de visitar página por página, su software envía consultas a la API y recibe respuestas estructuradas dentro de los permisos otorgados.
Puede visualizar la API como un puente estandarizado entre su aplicación y Etsy. Usted solicita el tipo de recurso necesario y la API entrega los datos delimitados por el alcance y los límites autorizados.
Datos disponibles
La API de Etsy proporciona información sobre publicaciones, tiendas y detalles asociados, según los permisos de la aplicación. El alcance real depende de las especificaciones vigentes de la API, el tipo de aplicación y los términos de uso fijados por la plataforma.
Ventajas
- Datos limpios y estructurados que facilitan el procesamiento directo.
- Riesgo mínimo de bloqueo de red en comparación con solicitudes web directas.
- Canal oficial y conforme a los lineamientos de Etsy.
Desventajas
- Requiere registrar una aplicación y superar el proceso de autorización de permisos.
- Límites estrictos de consultas por aplicación, con topes diarios y por segundo a nivel de clave API.
- Ampliar la cuota de uso requiere enviar una solicitud formal de aumento para su revisión por parte de Etsy.
- No todos los datos visibles en la interfaz web están accesibles a través de la API.
¿Para quién es adecuada?
La API oficial es adecuada para vendedores que gestionan su propio catálogo o equipos técnicos que requieren un flujo de datos continuo y formal. Si su meta consiste únicamente en obtener un lote reducido de publicaciones externas para exploración comercial, las soluciones sin código pueden resultar más directas.
Para proyectos que buscan flexibilidad sin gestionar solicitudes de acceso a la API oficial, las herramientas sin código constituyen una opción práctica.
3. Herramientas sin código para extraer datos de Etsy
No siempre es necesario programar scripts en Python para recopilar datos de Etsy. Para investigar artículos, vigilar a la competencia o descargar reseñas de listados concretos, las aplicaciones prediseñadas permiten empezar de inmediato. Por lo general, basta con ingresar palabras clave o URLs de Etsy, seleccionar los campos requeridos y exportar los resultados.
3.1 Apify
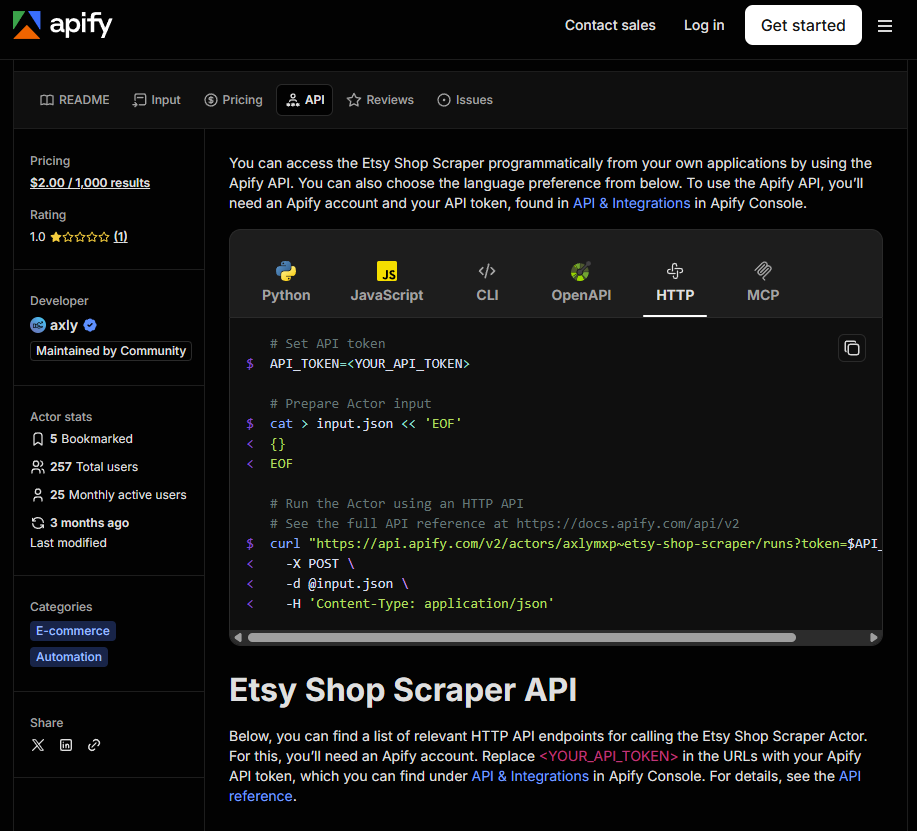
Apify cuenta con una amplia variedad de módulos de scraping (denominados Actors) orientados a diferentes tareas en Etsy. Permite localizar extractores específicos para búsquedas, tiendas, publicaciones o reseñas sin programar desde cero.
Muchos de estos módulos gestionan paginación automática, filtrado y ordenación. Algunos operan mediante la Etsy Open API v3, mientras que otros extraen la información directamente de las páginas web incorporando gestión de proxies.
Ventajas
- No requiere programación ni mantenimiento de código.
- Amplio catálogo de extractores adaptados a distintos tipos de página.
- Diversos módulos incorporan proxies, filtros de datos y paginación automática.
- Permite exportar datos a formatos JSON, CSV o Excel.
Limitaciones
- Los módulos son creados por distintos desarrolladores independientes, por lo que la calidad y los esquemas de salida varían.
- Los cambios en la maquetación de Etsy pueden desajustar el funcionamiento de los extractores temporalmente.
- Ciertas plantillas solo capturan resultados de búsqueda o conjuntos de datos específicos.
- Los registros de reseñas pueden incluir identificadores de usuario que demandan cautela en su tratamiento.
¿Para quién es adecuada?
Apify es ideal si desea extraer datos de Etsy sin montar infraestructura propia. Vendedores y especialistas en producto pueden seleccionar el módulo adecuado a sus necesidades y escalar las ejecuciones una vez validado el proceso.
3.2 Web Scraper
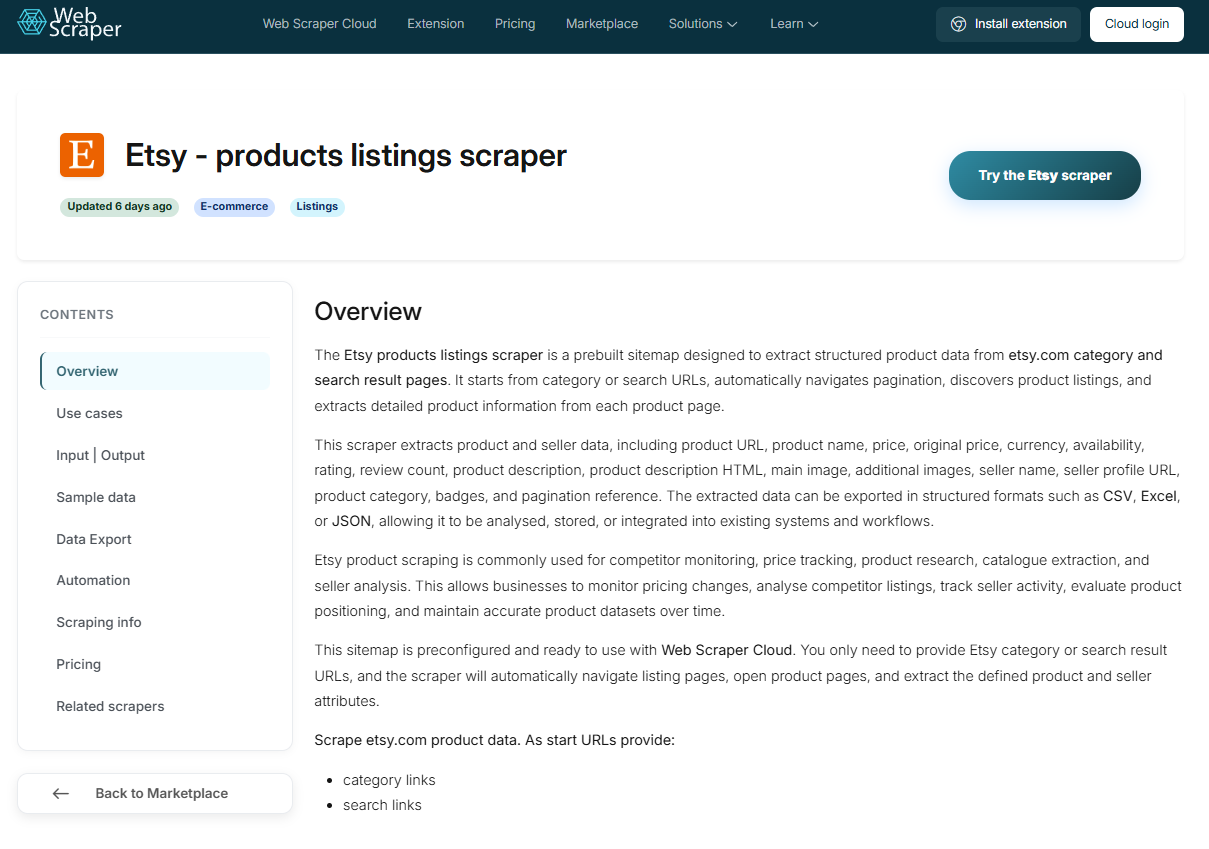
Web Scraper dispone de plantillas configuradas para el marketplace de Etsy, permitiendo extraer información de productos mediante una interfaz visual sin escribir código. Se define un mapa del sitio (sitemap), se configuran las URLs de categorías o búsquedas y se establece la navegación entre páginas.
Entre los campos extraíbles figuran el nombre del producto, URL, precio de oferta, precio original, moneda, estado de stock, puntuación, volumen de opiniones, descripción, imágenes, vendedor, tienda y categoría.
Ventajas
- Interfaz gráfica accesible sin conocimientos de programación.
- Campos de información comunes preconfigurados para productos.
- Exportación de datos a CSV, Excel y JSON.
- Capacidad para capturar datos adicionales sobre tiendas y vendedores.
Limitaciones
- Menor flexibilidad de adaptación en comparación con scripts personalizados.
- Exige ajustar el mapa del sitio manualmente cada vez que cambia la estructura web.
- Ciertas secciones dinámicas en JavaScript y defensas antibot requieren pruebas previas al procesar grandes volúmenes.
¿Para quién es adecuada?
Es una opción adecuada para quienes necesitan recopilar campos de producto estándar mediante una interfaz visual en el navegador. En proyectos con lógica avanzada o transformaciones frecuentes, Python aporta mayor adaptabilidad.
3.3 Etsy Reviews Extractor (extensión de Chrome)
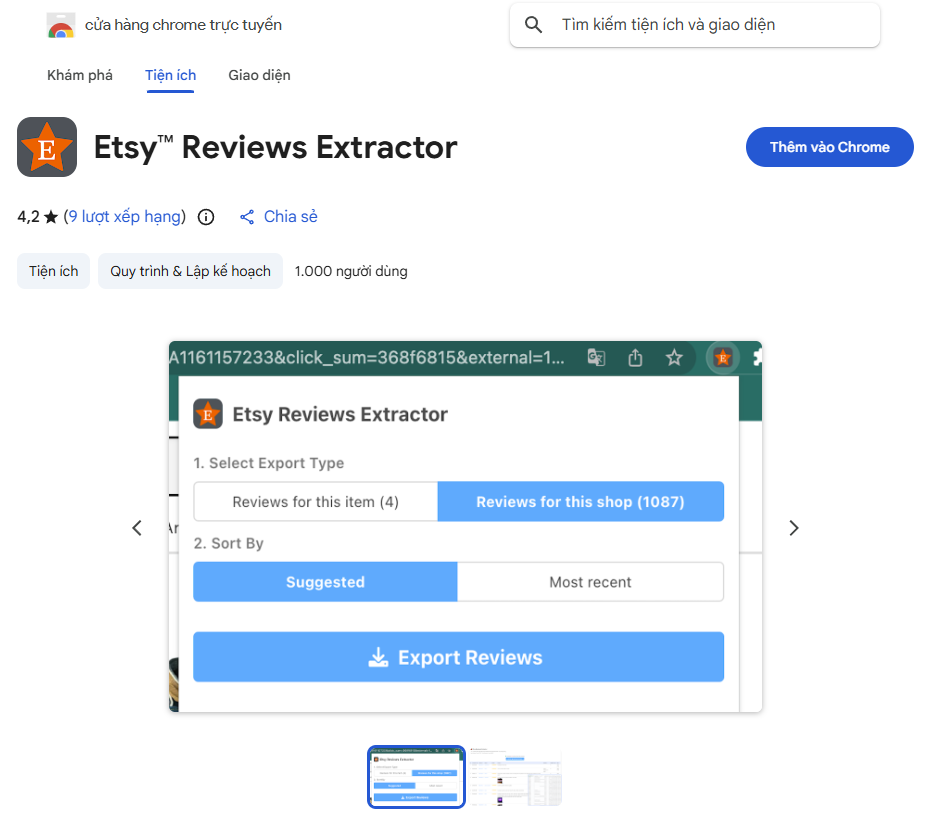
Etsy Reviews Extractor es una extensión para Chrome diseñada para extraer opiniones de publicaciones individuales. En lugar de ejecutar un rastreo integral de Etsy, se utiliza cuando el propósito central es analizar las valoraciones de los compradores en artículos concretos.
Los datos pueden incluir nombres de usuario, puntuación, texto de la reseña, imágenes adjuntas, fecha y referencias de producto. Las salidas pueden guardarse en formatos CSV, JSON o XLSX.
Ventajas
- Configuración e inicio inmediatos con un solo clic.
- Orientada específicamente a la información de opiniones.
- Incluye funciones de síntesis de reseñas mediante IA.
- Múltiples formatos de exportación disponibles.
Limitaciones
- Diseñada para artículos puntuales y no para barridos masivos de catálogo.
- Inadecuada para el análisis exhaustivo de categorías o rankings de búsqueda.
- Las reseñas suelen contener identificadores personales que requieren prudencia en su uso.
¿Para quién es adecuada?
Esta herramienta es idónea para extraer y sintetizar opiniones sobre artículos específicos con el fin de detectar necesidades del mercado. Si el objetivo es procesar cientos o miles de publicaciones en paralelo, es preferible utilizar otra metodología.
3.4 EtsyHunt y eRank (herramientas de investigación, no scrapers)
El análisis de mercado en Etsy no siempre requiere construir extractores propios. Soluciones como EtsyHunt y eRank se enfocan en la investigación de productos, palabras clave y volumen de demanda, cubriendo gran parte de estas necesidades sin necesidad de recopilar datos en crudo por cuenta propia.
EtsyHunt está orientada al seguimiento del rendimiento de artículos y detección de productos. eRank se centra en el volumen de búsqueda de términos y la optimización del posicionamiento de publicaciones.
Si la meta consiste únicamente en localizar productos viables o estudiar palabras clave, estas herramientas ahorran la fase de recolección manual. No obstante, si necesita datos en bruto para análisis internos propios, un scraper dedicado seguirá siendo indispensable.
Más información: Automatización en Etsy: las 15 mejores herramientas que debería probar
4. Scraping de datos de Etsy con Python (Requests y BeautifulSoup)
Cuando se requiere pleno control sobre la obtención y el procesamiento de la información, Python brinda una adaptabilidad superior a las opciones comerciales cerradas. Con librerías como Requests y BeautifulSoup, es viable comenzar con unas pocas publicaciones, extraer los campos indispensables y almacenar las salidas para su tratamiento.
Flujo de implementación
En primer lugar, defina las URLs objetivo y los atributos requeridos, como título, precio, descripción o métricas de valoraciones. A continuación, Requests traslada la petición a la página de Etsy, mientras que BeautifulSoup recorre el árbol HTML para localizar los elementos deseados.
Gran parte de los datos de producto en Etsy se encuentran incrustados en el código HTML como objetos JSON-LD. En tales casos, leer directamente estos bloques estructurados resulta mucho más robusto que parsear la interfaz gráfica completa mediante selectores CSS volátiles.
El siguiente fragmento muestra cómo consultar un producto y extraer sus parámetros a partir del JSON incrustado:
import json

import requests

from bs4 import BeautifulSoup

url = "https://www.etsy.com/listing/LISTING_ID"

headers = {"User-Agent": "Mozilla/5.0"}

response = requests.get(url, headers=headers, timeout=10)

soup = BeautifulSoup(response.text, "html.parser")

# Localizar la etiqueta de script con datos del producto en formato JSON
tag = soup.find("script", string=lambda s: s and '"offers"' in s)

data = json.loads(tag.string) if tag else {}

print("Nombre:", data.get("name", "N/A"))

print("Precio:", data.get("offers", {}).get("price", "N/A"))
Recomendaciones para solicitudes HTTP directas: Etsy suele devolver errores 403 Forbidden o desafíos CAPTCHA ante patrones de peticiones automatizadas. Conviene comenzar por fichas de producto individuales, ya que muchas integran bloques JSON estáticos, mientras que los resultados de búsqueda frecuentemente requieren JavaScript. Al escalar el script, contemple la gestión de paginación y posibles campos vacíos.
Ventajas
- Control absoluto sobre los campos a capturar y su transformación.
- Capacidad de adaptar el flujo a las necesidades puntuales de cada proyecto.
- Integración natural con librerías analíticas de Python (como Pandas) para limpieza y análisis.
Limitaciones
- Demanda experiencia previa en programación en Python y análisis de HTML.
- Sensible a bloqueos 403 o CAPTCHAs si se detecta actividad automatizada.
- Las actualizaciones en el diseño de página pueden invalidar selectores de forma imprevista.
- Requiere codificar manualmente la navegación entre páginas y la gestión de valores ausentes.
¿Para quién es adecuada?
Python está indicado para desarrolladores que necesitan un control riguroso sobre el scraping en Etsy. En tareas pequeñas, se puede iniciar con unas pocas publicaciones, verificar la integridad de los datos y añadir posteriormente paginación, rotación de proxies y gestión de reintentos.
5. Scraping de Etsy mediante navegadores automatizados
Cuando las peticiones básicas no logran obtener el contenido o las páginas requieren JavaScript para renderizarse, se hace necesario recurrir a navegadores automatizados. Tres de las opciones más extendidas son Playwright, Selenium y Puppeteer. Estas herramientas emulan la interacción dentro de un navegador real, facilitando la captura de contenido dinámico.
Playwright, Selenium y Puppeteer
Aunque presentan arquitecturas distintas, los tres entornos operan gobernando instancias de navegador. El script abre la página en Etsy, espera a que los componentes indispensables estén disponibles y extrae la información directamente del documento renderizado en lugar de depender únicamente de respuestas de red en crudo.
- Playwright: Soporta múltiples motores de navegación y cuenta con esperas automáticas integradas, destacando en sitios con alta presencia de componentes dinámicos.
- Selenium: Marco de trabajo de amplia trayectoria en automatización web, compatible con numerosos lenguajes de programación.
- Puppeteer: Especializado en Chromium y ampliamente adoptado en proyectos basados en Node.js.
Ventajas
- Procesa contenido renderizado en el cliente mediante JavaScript.
- Replica el comportamiento de navegación humana con mayor precisión que las peticiones simples.
- Permite configurar proxies, cookies y múltiples sesiones en simultáneo para distintos requerimientos.
Limitaciones
- Consumo notablemente superior de memoria RAM y CPU en comparación con scripts básicos.
- Velocidad de recolección más pausada debido al procesamiento de recursos gráficos.
- Las firmas de automatización del navegador aún pueden ser identificadas por cortafuegos antibot.
- Ejecutar múltiples sesiones concurrentes exige una gestión cuidadosa de recursos locales y del entorno del navegador.
Al procesar varias sesiones en paralelo, es fundamental mantener aislados los entornos de navegación. Las direcciones IP, las cookies y las huellas digitales deben gestionarse de manera coherente e individualizada para evitar que múltiples sesiones compartan la misma identidad de dispositivo con patrones discordantes.
Integración con el navegador antidetect Hidemyacc
Al escalar la recolección de datos en Etsy, los obstáculos van más allá de parsear HTML o ejecutar JavaScript. Si se abren múltiples instancias dentro del mismo entorno de navegador, las cookies, las huellas digitales y las IPs terminan asociadas. En este punto es donde el navegador antidetect Hidemyacc ofrece una solución estructural.
Hidemyacc le permite generar perfiles de navegación independientes, dotando a cada uno de huella digital, cookies y proxy propios. De esta manera, es posible desacoplar por completo las sesiones de extracción en lugar de ejecutarlas sobre un entorno compartido.
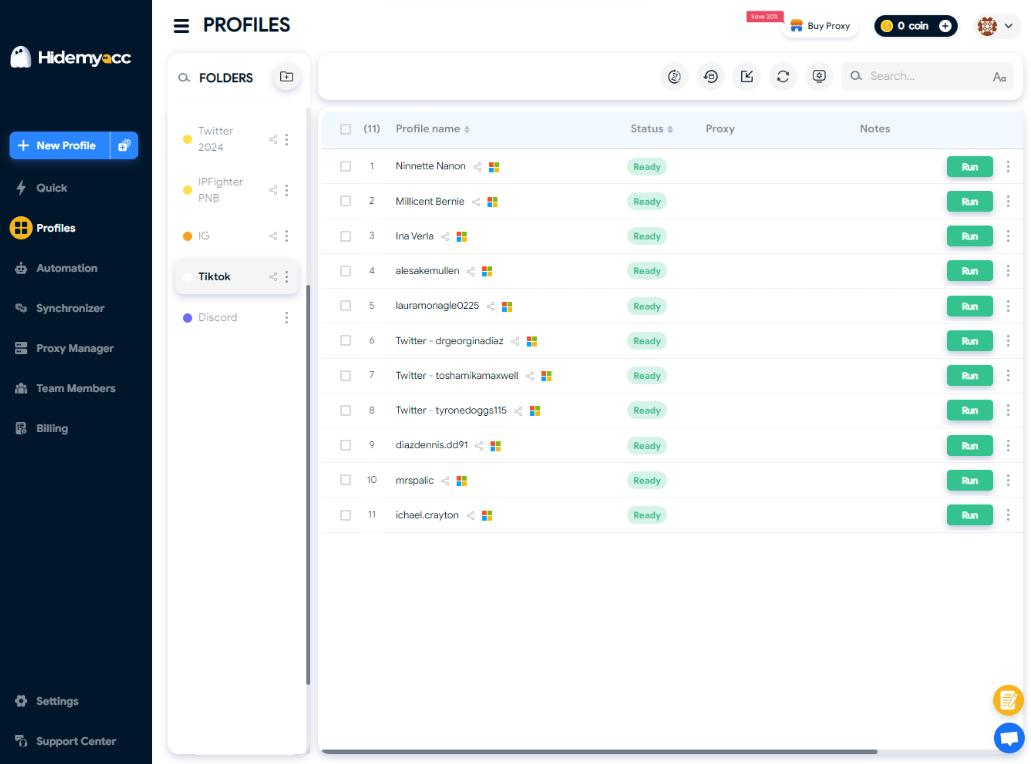
Consola de administración de perfiles de navegador en Hidemyacc.
Un flujo estructurado de extracción en Etsy puede articularse así:
- Creación de perfiles: Generar perfiles dedicados para cada hilo de recolección de datos.
- Asignación de proxies: Vincular un proxy adecuado a cada perfil para garantizar el aislamiento de IP.
- Conexión con herramientas de automatización: Utilizar Playwright o Puppeteer para gobernar el perfil y navegar en las páginas de Etsy mediante puertos de depuración remota (CDP).
- Extracción de información: Ejecutar scripts para obtener publicaciones, precios, etiquetas o variables analíticas.
- Validación previa al escalado: Probar el circuito con un lote reducido, monitorear la respuesta del servidor y aumentar el volumen progresivamente.
Conviene subrayar que Hidemyacc no reemplaza el código del scraper. Playwright o Puppeteer mantienen la tarea de navegar y extraer los datos, mientras que Hidemyacc suministra entornos de navegación aislados para gestionar las sesiones de forma segura. Esta combinación resulta óptima al coordinar múltiples perfiles o procesos de extracción simultáneos.
No obstante, emplear un navegador antidetect no exime de prestar atención a las medidas de seguridad. Es necesario moderar el ritmo de peticiones, cuidar la rotación de proxies y vigilar los límites operativos durante la ejecución.
Artículos relacionados:
- ¿Qué es un navegador antidetect? Por qué supera a las VPN y proxies convencionales
- Navegadores antidetect para web scraping: las mejores herramientas en 2026
6. Servicios de API de scraping de pago
Cuando el volumen de información es masivo y la administración de proxies, JavaScript o desafíos CAPTCHA se vuelve compleja, recurrir a una API de scraping resulta muy conveniente. En lugar de construir infraestructura local desde cero, se envían las URLs o palabras clave deseadas al proveedor y la extracción se procesa en la nube.
6.1 Bright Data
Bright Data ofrece tres APIs de scraping específicas para Etsy: captura por URL de producto, por término de búsqueda y por URL de tienda. Los datos obtenidos incluyen título, precio, tienda, características, variantes, políticas de envío y devolución, puntuación media y reseñas relevantes. Además de su API, comercializa conjuntos de datos prediseñados de Etsy.
Ventajas
- Tres modalidades que cubren artículos, búsquedas y perfiles de tienda.
- Estructura de datos lista para consumir, minimizando el desarrollo de parsers.
- Disponibilidad de bases de datos precompiladas para evitar la ejecución periódica de scripts.
Limitaciones
- Exige conocimientos básicos sobre consumo de APIs y manipulación de JSON.
- Introduce dependencia hacia un proveedor externo.
- Puede resultar excesiva si la necesidad se reduce a pocos registros.
¿Para quién es adecuada?
Bright Data se orienta a operaciones que requieren grandes volúmenes de datos de Etsy o actualizaciones sistemáticas. Al desarrollar sistemas de inteligencia de producto a gran escala, estas APIs e inventarios de datos reducen drásticamente la inversión en servidores de recolección.
6.2 Oxylabs
Oxylabs integra un Etsy Scraper dentro de su E-Commerce Scraper API, unificando la capacidad de extracción con su infraestructura global de proxies. Es posible trasladar peticiones vía API y recibir datos estructurados en JSON listos para alimentar bases de datos internas.
Entre sus parámetros destacan título, precio, moneda, imágenes, categoría, valoración de la tienda, puntuaciones, ubicación de envío y disponibilidad de stock. Permite además parametrizar el país de salida, el User-Agent y el perfil de dispositivo.
Ventajas
- Guías documentadas y muestras de código orientadas a Etsy.
- Respuestas normalizadas en formato JSON.
- API de desbloqueo y red de proxies gestionadas bajo un mismo servicio.
Limitaciones
- Es necesario contrastar previamente los campos devueltos con las exigencias del proyecto.
- Sujeta a compromisos contractuales mínimos y límites del proveedor.
- Poco rentable si la meta es procesar unas pocas publicaciones.
¿Para quién es adecuada?
Si prefiere concentrarse en el análisis de mercado y desligarse del mantenimiento de proxies o resolución de bloqueos, Oxylabs aligera significativamente esta operativa técnica, encajando en entornos con procesamiento de datos consolidado.
6.3 ScraperAPI
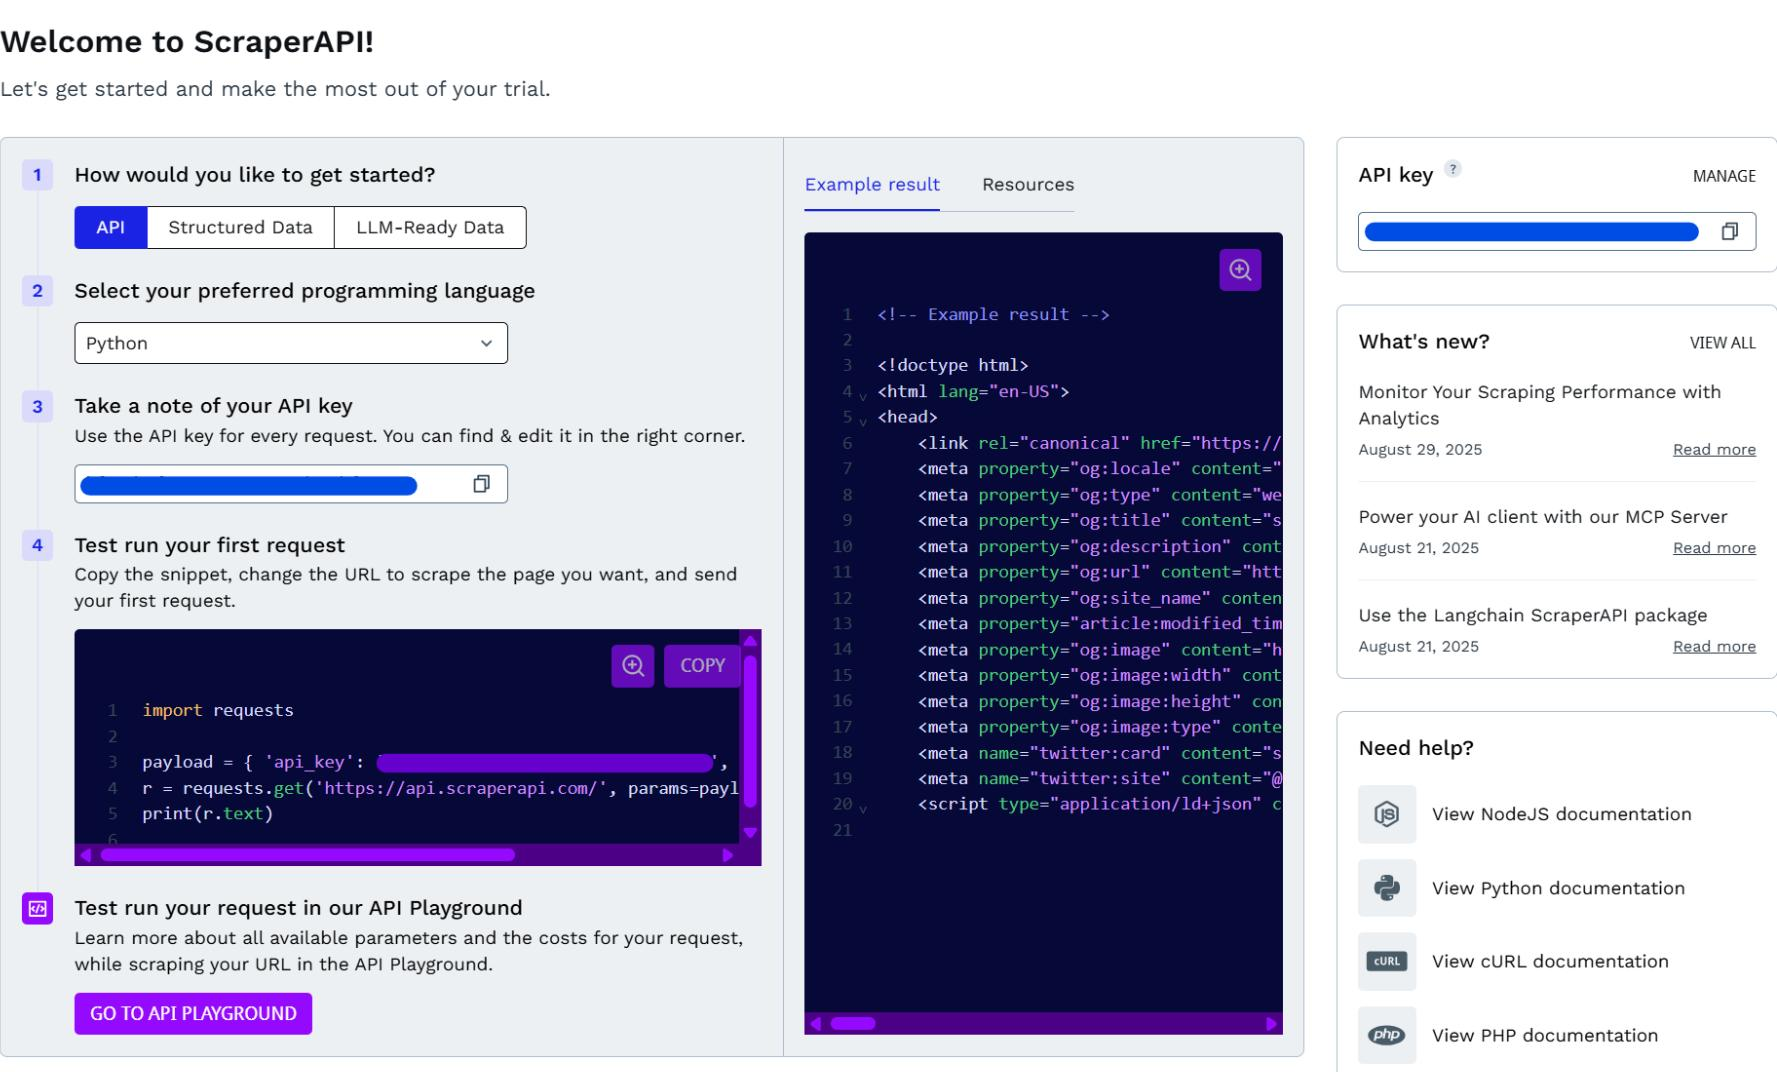
ScraperAPI opera bajo un esquema sumamente accesible. Se proporciona la URL de Etsy a rastrear, el servicio resuelve la petición en sus servidores y entrega el código HTML limpio para ser procesado mediante código propio.
Cuenta con documentación para trabajar con Etsy y permite definir rotación de IPs, encabezados personalizados o geolocalización por país, asumiendo la resolución de CAPTCHAs de forma automatizada.
Ventajas
- Integración ágil, requiriendo únicamente anteponer la URL del gateway.
- Manuales de integración en Python preparados para Etsy.
- Reutilizable para múltiples plataformas web de comercio electrónico.
Limitaciones
- Devuelve HTML en crudo, por lo que debe mantener selectores locales. Las clases CSS pueden variar si Etsy actualiza su interfaz.
- No es apta para flujos que requieran inicio de sesión con cuentas o formularios complejos.
- La precisión en la selección de países depende del nivel de suscripción.
¿Para quién es adecuada?
ScraperAPI resulta muy útil para desarrolladores con soltura en Python que prefieren mantener la lógica de extracción bajo su control. El servicio asume la gestión de proxies y peticiones, permitiendo usar BeautifulSoup o herramientas análogas para aislar los campos necesarios.
6.4 Scrapfly
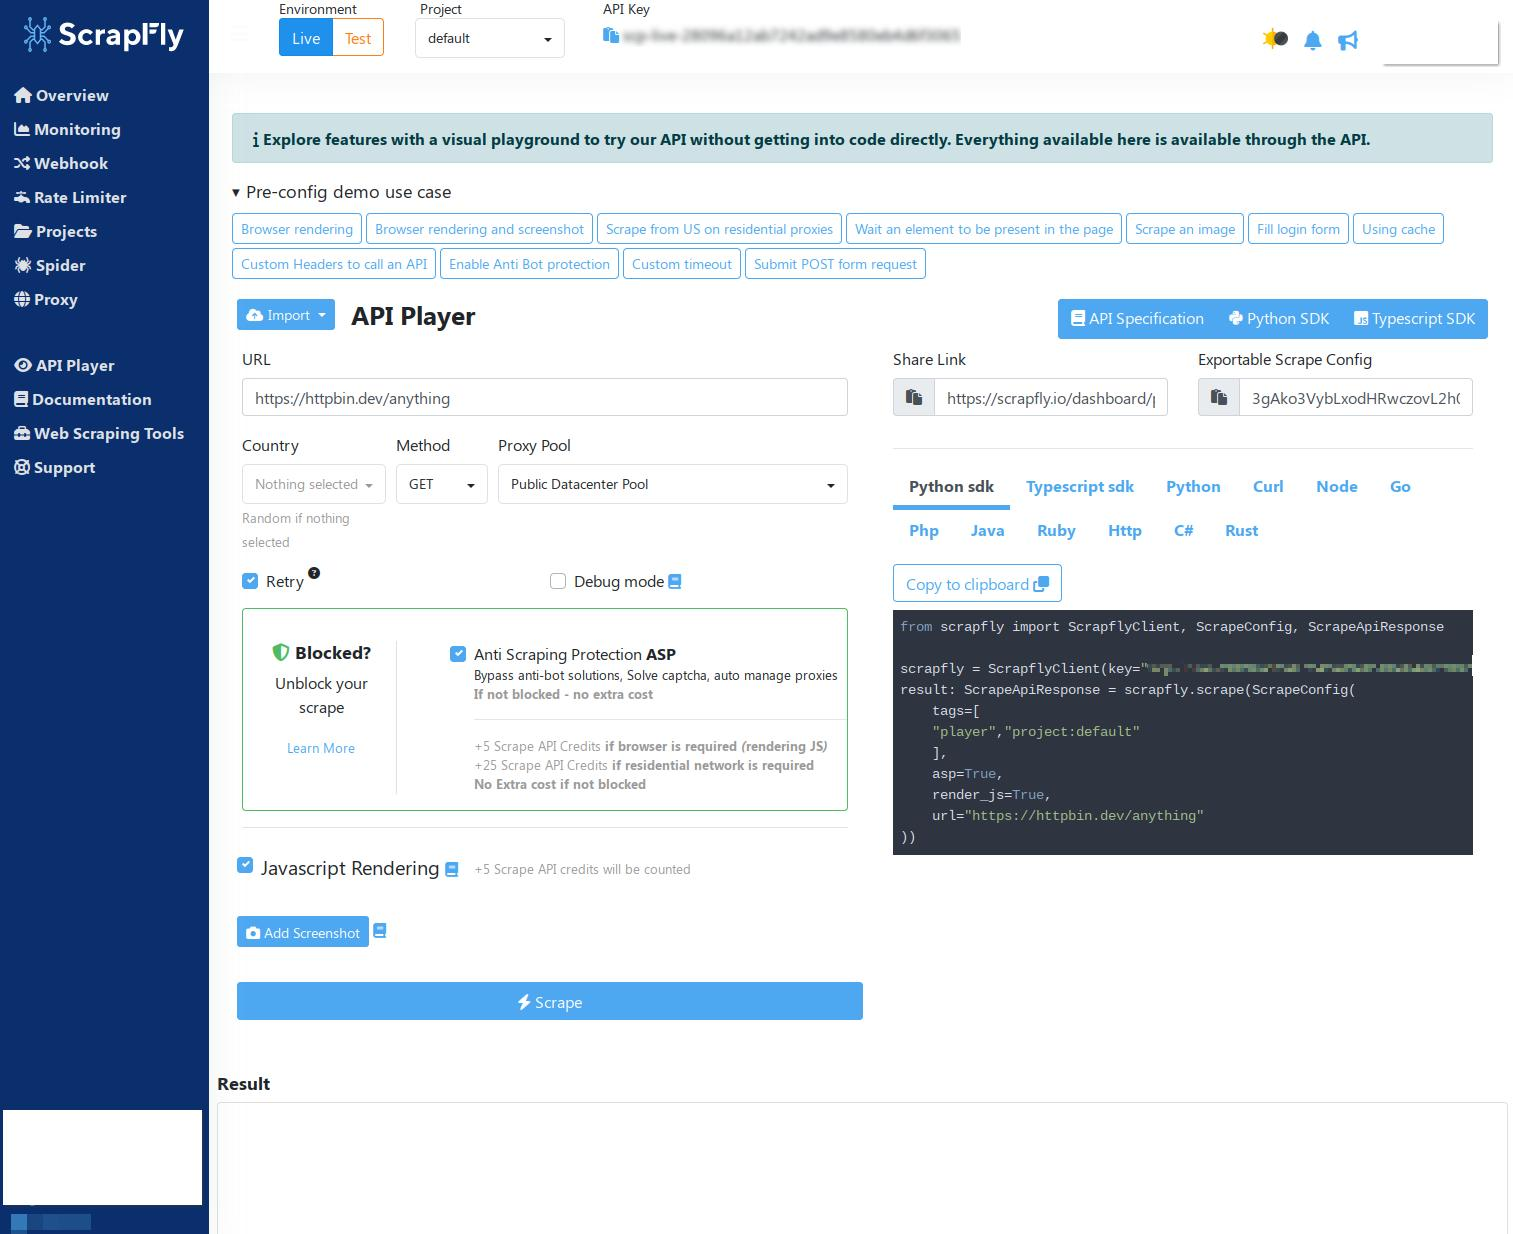
Scrapfly ofrece una API orientada a desarrolladores que combina rotación de proxies residenciales, elusión de barreras antibot y renderizado de JavaScript en la nube. Proporciona tutoriales de scraping en Etsy con Python, facilitando su inserción en flujos existentes sin implementar infraestructura pesada.
Se envía la URL de Etsy vía API con los parámetros de renderizado requeridos y se recibe el código HTML procesado o estructurado. Scrapfly también pone a disposición SDKs para diversos entornos de desarrollo.
Ventajas
- Solución integrada para evasión antibot y renderizado dinámico de JavaScript.
- SDKs en varios lenguajes con ejemplos de código para Etsy.
- Selección granular del país de salida de la IP.
Limitaciones
- El coste de créditos por petición se incrementa al activar funciones antibot, JavaScript y proxies residenciales.
- Los planes iniciales aplican limitaciones a la concurrencia máxima de peticiones simultáneas.
- Requiere depurar y estructurar los datos internamente tras la respuesta.
¿Para quién es adecuada?
Scrapfly es conveniente si ya dispone de scripts propios pero busca externalizar la gestión de proxies, desafíos antibot y renderizado complejo, manteniendo la lógica de transformación bajo su supervisión.
6.5 Comparativa de APIs de scraping para Etsy
Las cuatro plataformas presentan enfoques técnicos diferenciados. La siguiente tabla resume sus contrastes funcionales para facilitar la elección:
| Herramienta | Extractor de Etsy preconfigurado | Acceso por API | Proxies integrados | Facilidad de puesta en marcha | Perfil idóneo |
|---|---|---|---|---|---|
| Bright Data | ✓ (3 endpoints específicos) | ✓ | Pools residenciales incluidos | Media | Escala corporativa con demanda amplia de campos |
| Oxylabs | ✓ (E-Commerce Scraper) | ✓ | ✓ (Proxies residenciales) | Media | Equipos que requieren API y proxies unificados |
| ScraperAPI | ✓ (Página dedicada a Etsy, entrega HTML) | ✓ | ✓ (Rotación automática de IP) | Fácil | Desarrolladores con scripts locales de parseo HTML |
| Scrapfly | Guías documentadas para Etsy | ✓ | ✓ (Proxies residenciales disponibles) | Media | Desarrolladores con crawlers personalizados |
Para conjuntos de datos modestos, Python o herramientas sin código suelen bastar. Al afrontar volúmenes masivos, las APIs de scraping evitan la carga de administrar proxies, resolver JavaScript y eludir bloqueos técnicos.
7. Comparativa general: 5 métodos de scraping en Etsy
Cada método presenta fortalezas particulares. La API oficial ofrece fiabilidad y datos estructurados, mientras que Python y los navegadores automatizados brindan máxima autonomía. Las herramientas sin código responden bien ante necesidades puntuales y las APIs de scraping reducen la fricción al escalar a gran escala.
| Método | Dificultad de implementación | Capacidad de evasión antibot | Estabilidad a largo plazo | Escala recomendada | Nivel de cumplimiento normativo |
|---|---|---|---|---|---|
| API oficial (Etsy Open API v3) | Baja | No aplica (canal formal homologado) | Alta (si se preservan las condiciones de acceso) | Vendedores que gestionan tiendas o integraciones estables | Alto bajo términos de la API |
| Herramientas sin código | Baja | Depende de cada herramienta | Media (sujeta al soporte de los creadores) | Pequeña a mediana | Consultar términos de servicio de Etsy |
| Python (Requests y BeautifulSoup) | Alta | Baja (sensible a DataDome y cortafuegos) | Baja (fácil rotura ante cambios en el HTML) | Proyectos reducidos | Consultar términos de servicio de Etsy |
| Navegadores automatizados | Alta | Media (requiere aislar perfiles) | Media | Páginas con JavaScript dinámico y ejecución concurrente | Consultar términos de servicio de Etsy |
| Servicios de API de scraping | Baja a media | Media a alta (según el proveedor) | Media a alta | Operaciones a gran escala | Consultar términos de servicio de Etsy |
Orientación según la escala de trabajo:
- Decenas de publicaciones: Una extensión sin código o un script elemental en Python cubren con holgura estudios rápidos de producto o análisis de precios.
- Varios miles de publicaciones: Python o navegadores headless otorgan control exhaustivo sobre el esquema de datos. Para procesos periódicos, las APIs de scraping resultan convenientes.
- Decenas de miles de publicaciones: Las APIs comerciales o clústeres de navegadores headless distribuidos con aislamiento son idóneos para manejar la concurrencia sin interrupciones de red.
- Datos cubiertos por la Etsy Open API: Si la API oficial provee los campos necesarios y su aplicación reúne los requisitos, priorice siempre este canal frente al scraping web directo.
El volumen no es el único criterio. Conviene ponderar también la naturaleza de los datos, la periodicidad de captura, la experiencia en programación y el grado de control deseado sobre el pipeline.
8. Buenas prácticas para hacer scraping en Etsy de forma segura
Etsy implementa controles automáticos para detectar patrones de tráfico no convencionales. Realizar peticiones excesivas en intervalos cortos o abrir múltiples sesiones desprotegidas puede ocasionar la suspensión de cuentas en Etsy o el bloqueo temporal de la IP. Las siguientes cuatro recomendaciones ayudan a mitigar incidencias:
Etsy supervisa el acceso no humano. Cuando el volumen de solicitudes es desmedido, pueden surgir comprobaciones CAPTCHA, códigos de error 403 o restricciones por IP. Considere estos principios:
- Comprender los mecanismos de detección de Etsy: La reputación de la IP, la huella digital, la cadencia de peticiones y el comportamiento en página son evaluados junto con las cookies y sesiones. Las páginas de búsqueda suelen tener filtros más rigurosos que las fichas de producto, y ciertas herramientas optan por rastrear páginas de categoría en su lugar. Es prudente comenzar por artículos individuales o categorías, moderar la frecuencia y realizar pruebas en pequeños lotes.
- Seleccionar proxies fiables y prescindir de opciones gratuitas: Los proxies públicos o el uso de una única IP para todas las consultas aceleran la inclusión en listas negras. Emplee proxies residenciales o móviles limpios.
- Preservar la coherencia de huellas digitales y sesiones: En automatizaciones con navegador, asegúrese de que el User-Agent, el sistema operativo y la zona horaria concuerden entre sí y con la ubicación del proxy. Al ejecutar procesos simultáneos, asigne a cada hilo un entorno de perfil independiente, tal como se describió en la sección 5.
- Revisar los términos de servicio y aspectos legales: Las posturas varían: las condiciones de uso de Etsy restringen el acceso automatizado no autorizado, mientras que la captura de datos públicos cuenta con interpretaciones diversas según la jurisdicción. Revise siempre los términos y el archivo robots.txt de Etsy antes de proceder. Evite compilar o almacenar identificadores personales de compradores en reseñas y nunca emplee la información obtenida para plagiar creaciones de otros vendedores. Esta guía no constituye asesoría jurídica; para usos comerciales, consulte a especialistas legales.
Avanzar paso a paso y auditar las salidas antes de expandir el proceso le permitirá asegurar la calidad de la información y prevenir pérdidas de datos en etapas posteriores.
Más información: Los mejores proveedores de proxies para Etsy para gestionar múltiples cuentas en 2026
9. Errores comunes al hacer scraping en Etsy
Determinadas deficiencias en la configuración del scraper pueden provocar pérdida de datos, salidas inexactas o comprometer la seguridad de sus perfiles. Evite estos tres fallos habituales:
- Hacer scraping con la cuenta principal de vendedor abierta: Si ejecuta scripts manteniendo la sesión de su tienda activa, el perfil comercial puede recibir sanciones. Trabaje siempre sin iniciar sesión o recurra a cuentas secundarias exclusivas para investigación.
- Escalar de golpe dependiendo de clases CSS inestables: Valide primero con unos pocos artículos. Priorice bloques JSON estructurados embebidos en el código, guarde volcados intermedios y filtre duplicados o campos vacíos antes de procesar el lote completo.
- Emplear una sola técnica para cualquier escala o tipo de página: Las fichas de producto, páginas de búsqueda, escaparates de tiendas y secciones de reseñas difieren en maquetación y barreras de protección. Seleccione el método correspondiente basándose en la matriz comparativa de la sección 7.
Prevenir estos errores desde el inicio optimiza los tiempos de desarrollo y evita tener que reestructurar la información ante fallos de captura.
10. Conclusión
La extracción de datos en Etsy no exige comenzar necesariamente con sistemas técnicos complejos. Lo esencial es delimitar con precisión qué datos requiere, en qué volumen y cuánto control técnico desea mantener. A partir de ahí, podrá seleccionar entre la API oficial, extensiones sin código, scripts en Python, navegadores headless o APIs de scraping especializadas.
Para unas pocas decenas de publicaciones, una extensión de navegador o un script básico en Python cubren el propósito con solvencia. Cuando el catálogo escala a miles o decenas de miles de artículos, optar por arquitecturas con gestión de proxies y desbloqueo integrado facilitará el control del flujo y reducirá incidentes de red.
Cualquiera sea la vía seleccionada, empiece con pruebas breves, audite la calidad de los campos obtenidos y clarifique su uso comercial antes de ampliar el alcance. Con un proceso estable, podrá expandir las consultas para fundamentar decisiones de selección de producto, políticas de precios y análisis del mercado en Etsy.
Artículos recomendados:
- Más de 30 productos digitales destacados para vender en Etsy
- ¿Se pueden tener múltiples tiendas en Etsy? Guía práctica
- Cómo hacer scraping en eBay como un profesional
- Guía para extraer datos de la página Explorar de Instagram: herramientas y consejos imprescindibles
- Scraper de Amazon: comparativa de los métodos de extracción más populares
11. FAQ
1. ¿Es legal hacer scraping de datos en Etsy?
La legalidad está vinculada a la naturaleza de los datos, los métodos de captura y la finalidad de uso. Se deben revisar las condiciones de uso de Etsy y las normativas de privacidad vigentes. En especial, las reseñas pueden exhibir nombres de compradores o identificadores de cuenta; actúe con cautela y evite almacenar datos personales.
2. ¿Conviene usar la API de Etsy o hacer scraping web directo?
Si los campos requeridos están presentes en la Etsy Open API y su perfil cumple con los requisitos, la API es el camino óptimo por estabilidad y datos estructurados. El scraping directo permite capturar elementos adicionales mostrados en la interfaz pública, aunque requiere asumir desafíos técnicos y gestión antibot por cuenta propia.
3. ¿Es difícil programar un scraper para Etsy en Python?
Para volúmenes reducidos, utilizar Requests y BeautifulSoup para leer el JSON incrustado en el HTML es sencillo. Al incrementar el volumen a miles de productos o interactuar con elementos dinámicos en JavaScript, el script requerirá paginación, navegadores headless y rotación de proxies, aumentando su complejidad.
4. ¿Etsy puede bloquear mi scraper?
Sí. Emitir solicitudes a una frecuencia elevada o abrir sesiones concurrentes desde entornos no aislados puede activar limitaciones de acceso, errores 403 o bloqueos de IP. Regule la velocidad de las consultas y escale de forma progresiva.
5. ¿Se necesita un navegador antidetect para hacer scraping en Etsy?
No siempre es obligatorio. Un navegador antidetect resulta útil principalmente cuando se ejecutan múltiples sesiones automatizadas en paralelo y se requiere aislar por completo la huella digital, las cookies y los proxies en cada entorno de ejecución.