Muốn thu thập dữ liệu từ Instagram để phân tích đối thủ, tìm KOL hay nghiên cứu xu hướng nội dung? Thay vì sao chép thủ công từng bài đăng, bạn có thể sử dụng Instagram scraping để lấy dữ liệu nhanh hơn và xuất ra JSON, CSV hoặc Excel.
Trong bài viết này, bạn sẽ được hướng dẫn từng cách thu thập dữ liệu Instagram, từ phương pháp thủ công, công cụ mã nguồn mở, dịch vụ API đến tự viết scraper bằng Python, đồng thời biết cách giảm nguy cơ bị Instagram giới hạn khi làm việc với nhiều tài khoản.
1. Instagram scraping là gì và có thể thu thập những dữ liệu nào?
Nếu bạn từng muốn biết đối thủ đang đăng nội dung gì, hashtag nào đang lên xu hướng hay một KOL có tỷ lệ tương tác ra sao, thì Instagram scraping chính là cách giúp tự động thu thập những dữ liệu đó. Thay vì sao chép thủ công từng bài đăng, scraper sẽ lấy dữ liệu công khai từ Instagram và xuất thành các định dạng như JSON, CSV hoặc Excel để dễ phân tích hơn.
Điểm cần phân biệt là Instagram scraping không giống Instagram Graph API. Graph API là giải pháp chính thức của Meta và chỉ cho phép truy cập dữ liệu từ những tài khoản đã cấp quyền. Trong khi đó, scraping được dùng để thu thập dữ liệu công khai từ profile, hashtag hoặc Reels nhằm phục vụ nghiên cứu thị trường và phân tích đối thủ.
Bạn có thể thu thập những dữ liệu nào?
Dữ liệu có thể lấy sẽ phụ thuộc vào công cụ và quyền truy cập, nhưng phổ biến nhất gồm:
| Loại dữ liệu | Ví dụ có thể thu thập |
|---|---|
| Profile & Bio | Username, avatar, bio, website, số bài đăng |
| Bài đăng & Reels | Caption, hình ảnh/video, thời gian đăng, lượt thích, lượt xem |
| Bình luận | Nội dung comment, lượt thích bình luận, engagement cơ bản |
| Hashtag & Explore | Bài viết theo hashtag, xu hướng nội dung, Explore Page |
| Followers | Số lượng follower công khai (danh sách đầy đủ bị giới hạn) |
Sau khi thu thập, dữ liệu thường được xuất dưới dạng JSON, CSV hoặc Excel, giúp bạn dễ dàng nhập vào Google Sheets, Power BI hoặc các công cụ phân tích khác.
Tìm hiểu rõ hơn tại: Hướng dẫn lấy dữ liệu từ trang Khám phá Instagram: Những công cụ và mẹo bạn cần biết
2. Thu thập dữ liệu Instagram thủ công
Thu thập thủ công là cách đơn giản nhất để lấy dữ liệu từ Instagram khi bạn chỉ cần phân tích một vài profile, hashtag hoặc bài đăng. Dù không phù hợp với quy mô lớn, phương pháp này vẫn hữu ích trong giai đoạn nghiên cứu ban đầu vì không cần cài đặt công cụ hay viết bất kỳ dòng code nào.
Mỗi phương pháp đều có điểm mạnh và hạn chế riêng. Với thu thập thủ công, bạn nên cân nhắc những yếu tố dưới đây trước khi áp dụng.
Ưu điểm
- Miễn phí và không cần cài đặt phần mềm.
- Dễ thực hiện trên cả điện thoại và máy tính.
- Hầu như không có rủi ro bị Instagram giới hạn vì không sử dụng bot.
Nhược điểm
- Tốn nhiều thời gian khi số lượng bài đăng lớn.
- Khó cập nhật dữ liệu định kỳ.
- Dễ xảy ra sai sót trong quá trình nhập liệu.
Cách thực hiện
Bạn có thể bắt đầu bằng việc thu thập các chỉ số cơ bản từ profile hoặc hashtag cần phân tích theo quy trình sau:
- Mở profile, hashtag hoặc Reels cần phân tích.
- Ghi lại caption, lượt thích, bình luận và thời gian đăng.
- Lưu dữ liệu vào Google Sheets hoặc Excel theo từng cột.
- Kiểm tra và loại bỏ các bản ghi trùng lặp trước khi phân tích.
Nếu chỉ cần theo dõi vài chục bài đăng hoặc thực hiện một nghiên cứu ngắn hạn, đây vẫn là cách nhanh và tiết kiệm chi phí nhất trước khi chuyển sang các giải pháp tự động.
3. Công cụ mã nguồn mở để scrape dữ liệu Instagram
Nếu bạn biết Python cơ bản và muốn tự xây dựng workflow scraping, công cụ mã nguồn mở sẽ là lựa chọn cân bằng nhất giữa chi phí và khả năng tùy chỉnh. Bạn có thể chủ động kiểm soát dữ liệu đầu ra, đồng thời dễ dàng tích hợp với các công cụ phân tích hoặc hệ thống nội bộ.
3.1. Instaloader
Instaloader phù hợp khi mục tiêu chính là thu thập dữ liệu công khai như profile, bài đăng hoặc hashtag mà không cần phụ thuộc vào nền tảng trả phí.
Instaloader có thể giúp bạn thu thập:
- Profile công khai
- Bài đăng và Reels
- Hashtag
- Dữ liệu JSON
Trước khi triển khai, hãy cân nhắc những điểm mạnh và hạn chế của công cụ này.
Ưu điểm
- Miễn phí và được cập nhật thường xuyên.
- Dễ tích hợp với Python.
- Phù hợp với các dự án cá nhân và nghiên cứu.
Nhược điểm
- Hạn chế với dữ liệu yêu cầu đăng nhập.
- Có thể gặp rate limit nếu scrape số lượng lớn.
Với nhu cầu thu thập dữ liệu công khai, Instaloader là một trong những lựa chọn dễ bắt đầu nhất nhờ quy trình cài đặt đơn giản và cộng đồng sử dụng lớn.
Cách thực hiện với Instaloader
Quy trình triển khai chỉ gồm vài bước cơ bản:
- Cài đặt Instaloader trong môi trường Python.
- Nhập username hoặc hashtag cần thu thập.
- Chạy script để tải dữ liệu.
- Xuất kết quả thành JSON hoặc CSV.
Sau khi xuất dữ liệu, bạn có thể tiếp tục làm sạch và đưa vào Excel hoặc Power BI để phân tích.
3.2. instagrapi / aiograpi
Khi cần thu thập nhiều loại dữ liệu hơn như follower, following hoặc comment, instagrapi và aiograpi sẽ linh hoạt hơn Instaloader vì hỗ trợ nhiều endpoint hơn.
Nhóm thư viện này hỗ trợ:
- Profile
- Followers & Following
- Comment
- Story
- Metadata bài đăng
Do hoạt động thông qua private API, bạn cũng nên cân nhắc ưu điểm và rủi ro trước khi sử dụng.
Ưu điểm
- Dữ liệu phong phú và chi tiết.
- Tốc độ xử lý nhanh.
- Dễ mở rộng thành workflow tự động.
Nhược điểm
- Cần đăng nhập tài khoản Instagram.
- Dễ gặp checkpoint nếu thao tác bất thường.
- Phải cập nhật khi Instagram thay đổi endpoint.
Nhìn chung, instagrapi phù hợp với những dự án cần dữ liệu chuyên sâu hơn, nhưng đổi lại bạn sẽ phải quản lý session và tài khoản cẩn thận hơn.
Cách thực hiện với instagrapi
Để triển khai hiệu quả, bạn có thể thực hiện theo quy trình sau:
- Đăng nhập bằng tài khoản Instagram.
- Gọi endpoint cần thu thập dữ liệu.
- Lưu kết quả dưới dạng JSON.
- Làm sạch và chuẩn hóa dữ liệu trước khi phân tích.
Cách tiếp cận này linh hoạt hơn Instaloader, nhưng bạn cũng cần quản lý session và tài khoản cẩn thận để giảm nguy cơ checkpoint.
4. Dịch vụ API quản lý sẵn cho Instagram scraping
Nếu không muốn tự xây dựng scraper từ đầu, bạn có thể sử dụng các dịch vụ API để thu thập dữ liệu Instagram. Điểm mạnh của nhóm công cụ này là đã xử lý sẵn hạ tầng proxy, cơ chế chống phát hiện và trả dữ liệu dưới dạng có cấu trúc, giúp việc tích hợp vào hệ thống hoặc phân tích dữ liệu trở nên đơn giản hơn.
4.1. Bright Data
Bright Data là một trong những nền tảng Instagram Scraper API phổ biến nhất hiện nay, hướng đến các dự án cần thu thập dữ liệu ở quy mô lớn. Công cụ này hỗ trợ lấy profile, bài đăng, Reels, comment và hashtag mà không cần tự xây dựng hạ tầng scraping.
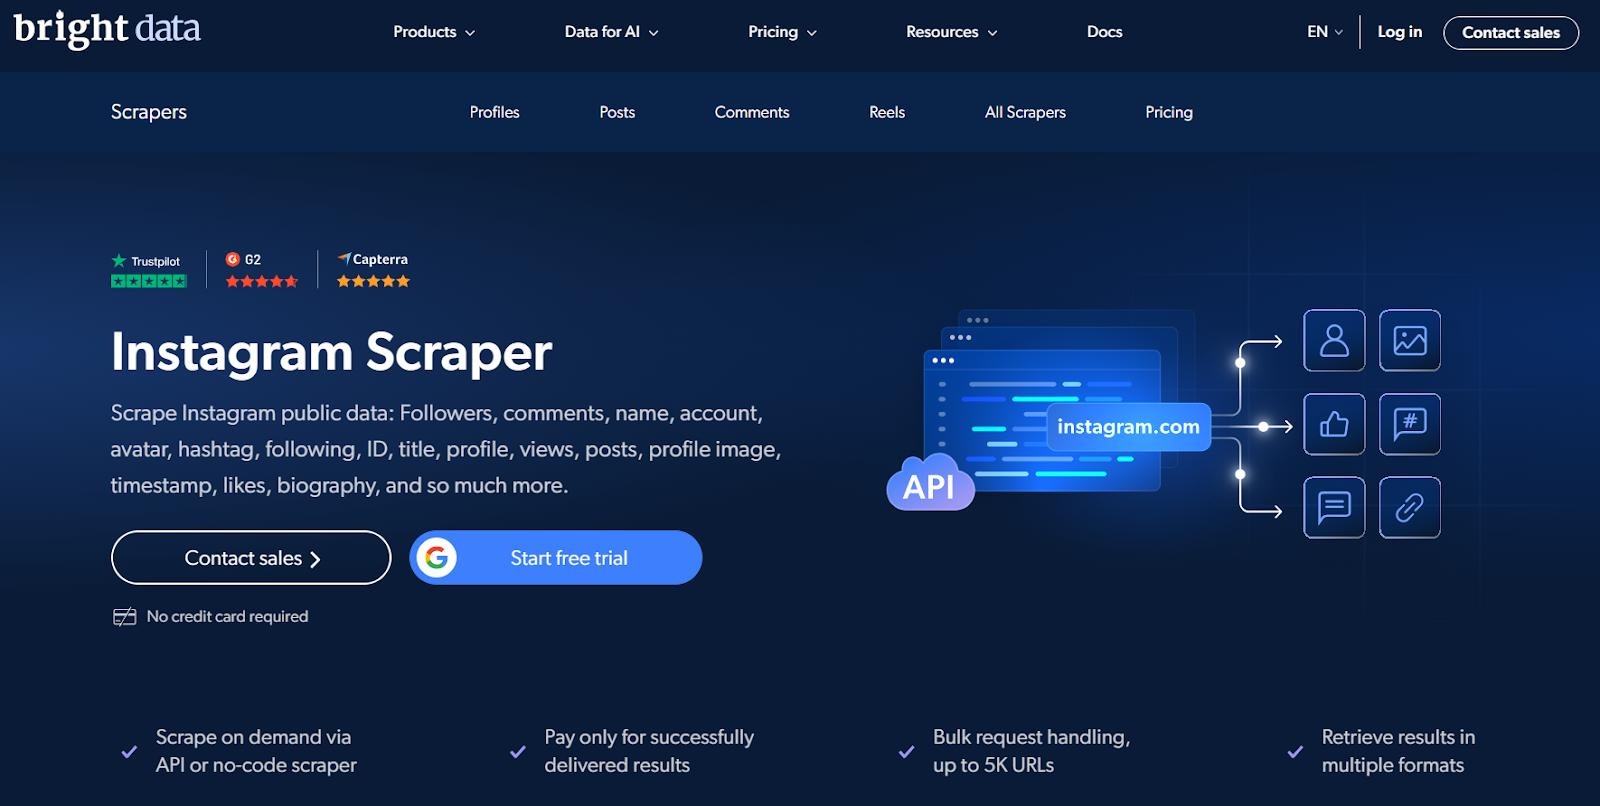
Bright Data nổi bật ở những điểm sau:
- Thu thập được nhiều loại dữ liệu Instagram công khai.
- Dữ liệu trả về dưới dạng JSON có cấu trúc.
- Tích hợp sẵn mạng proxy residential để tăng độ ổn định.
- Phù hợp với hệ thống cần xử lý lượng dữ liệu lớn.
Điểm cần lưu ý
- Chi phí tương đối cao so với các công cụ no-code.
- Có nhiều gói dịch vụ nên cần lựa chọn theo đúng nhu cầu.
Nếu bạn đang xây dựng hệ thống social listening hoặc phân tích hàng nghìn profile Instagram, Bright Data sẽ phù hợp hơn các công cụ automation thông thường.
4.2. Oxylabs
Oxylabs là nền tảng cung cấp API thu thập dữ liệu Instagram, phù hợp với các dự án cần tích hợp trực tiếp vào hệ thống phân tích hoặc nghiên cứu thị trường. So với các công cụ no-code, Oxylabs hướng nhiều hơn đến khả năng mở rộng và xử lý dữ liệu ở quy mô lớn.
Những gì Oxylabs hỗ trợ
- Thu thập hồ sơ công khai
- Bài đăng và hashtag
- Trả dữ liệu thông qua API
- Kết hợp hạ tầng proxy dân cư
Ưu điểm
- Hạ tầng ổn định, tỷ lệ thu thập dữ liệu thành công cao.
- Dễ tích hợp vào hệ thống nội bộ thông qua API.
- Phù hợp với các dự án cần vận hành lâu dài.
Hạn chế
- Chi phí tương đối cao so với các công cụ dành cho cá nhân.
- Nhiều tính năng hướng đến doanh nghiệp nên có thể dư thừa với nhu cầu nhỏ.
Nếu bạn cần xây dựng hệ thống theo dõi đối thủ hoặc thu thập dữ liệu Instagram tự động trong thời gian dài, Oxylabs sẽ phù hợp hơn các công cụ kéo thả.
4.3. Apify
Apify là nền tảng thu thập dữ liệu theo hướng không cần tự xây scraper từ đầu. Thay vì viết toàn bộ quy trình bằng Python, bạn có thể sử dụng các mẫu có sẵn để lấy dữ liệu từ profile, hashtag, bài đăng hoặc bình luận, sau đó xuất trực tiếp thành tệp phân tích.
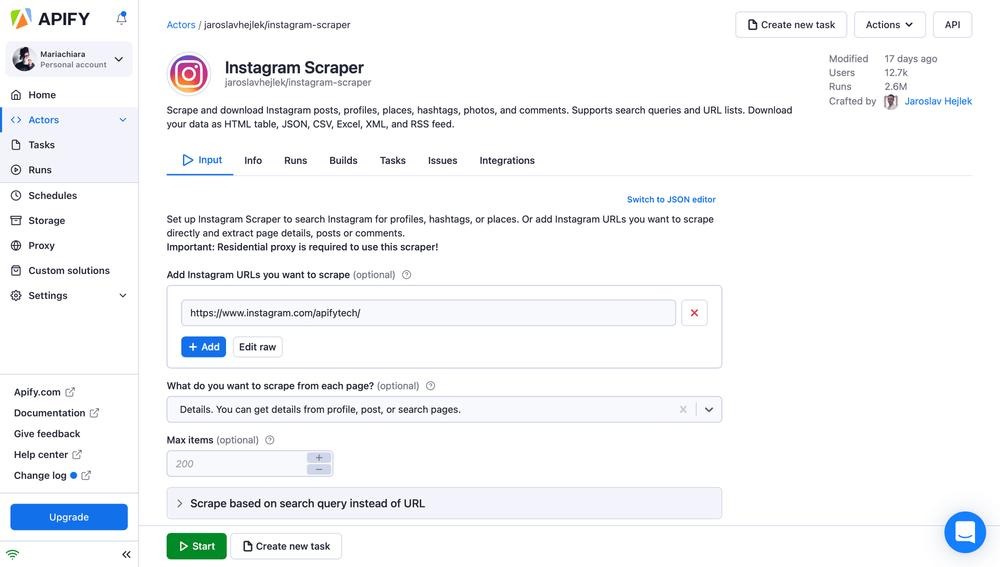
Apify hỗ trợ thu thập
- Hồ sơ người dùng (profile)
- Bài đăng và Reels
- Hashtag
- Bình luận công khai
- Dữ liệu xuất dưới dạng JSON, CSV hoặc Excel
Ưu điểm
- Không yêu cầu kiến thức lập trình.
- Thiết lập và chạy quy trình khá nhanh.
- Hỗ trợ nhiều định dạng xuất dữ liệu để phân tích hoặc đồng bộ sang công cụ khác.
- Có thể lên lịch thu thập dữ liệu tự động.
Hạn chế
- Chất lượng các mẫu thu thập không hoàn toàn giống nhau.
- Một số tác vụ sẽ cần kết hợp thêm proxy để hoạt động ổn định.
- Khả năng tùy chỉnh không linh hoạt bằng việc tự viết scraper.
Lưu ý khi sử dụng
Apify có rất nhiều mẫu do cộng đồng phát triển, vì vậy bạn nên kiểm tra lượt sử dụng, đánh giá và thời gian cập nhật trước khi lựa chọn. Với các workflow thu thập dữ liệu Instagram quy mô lớn, việc kết hợp thêm proxy sẽ giúp tăng độ ổn định.
Nếu bạn là marketer hoặc cần triển khai dự án trong thời gian ngắn, Apify là lựa chọn dễ tiếp cận nhất trong nhóm công cụ no-code.
4.4. PhantomBuster
PhantomBuster tập trung vào tự động hóa các tác vụ trên Instagram hơn là xây dựng scraper từ đầu. Công cụ này phù hợp khi bạn muốn thu thập dữ liệu định kỳ và đồng bộ kết quả sang Google Sheets hoặc CRM.
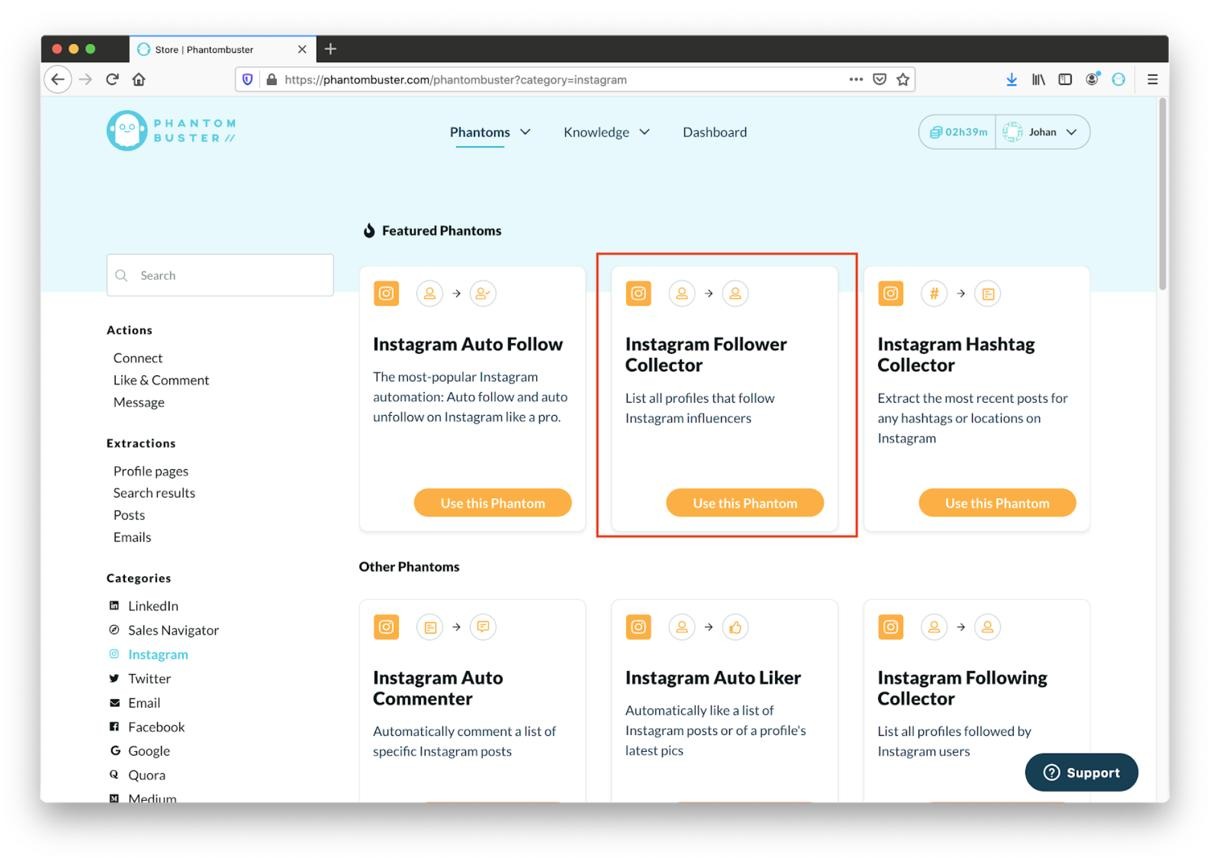
PhantomBuster hỗ trợ
- Thu thập hồ sơ người dùng
- Lấy bình luận công khai
- Xuất dữ liệu sang Google Sheets
- Chạy tác vụ theo lịch
Ưu điểm
- Không cần lập trình.
- Thiết lập workflow nhanh.
- Dễ tích hợp với các công cụ marketing.
Hạn chế
- Giới hạn thời gian chạy theo từng gói.
- Không phù hợp với dữ liệu rất lớn.
- Ít linh hoạt hơn khi cần tùy chỉnh sâu.
Lưu ý: PhantomBuster hoạt động theo thời lượng thực thi hằng ngày, vì vậy bạn nên chia nhỏ các tác vụ thay vì scrape quá nhiều profile trong một lần chạy. Điều này vừa tiết kiệm thời gian chạy vừa giảm nguy cơ gặp giới hạn từ Instagram.
Với những tác vụ lặp lại như theo dõi đối thủ hoặc cập nhật dữ liệu hằng ngày, PhantomBuster sẽ thuận tiện hơn việc tự viết script.
5. Cách tự viết Instagram scraper bằng Python, Selenium hoặc Playwright
Nếu các công cụ dựng sẵn chưa đáp ứng được nhu cầu, bạn có thể tự viết Instagram scraper để chủ động kiểm soát toàn bộ quy trình thu thập dữ liệu. Cách tiếp cận này phù hợp khi cần lấy dữ liệu theo logic riêng, tích hợp với hệ thống nội bộ hoặc chạy đồng thời nhiều tài khoản Instagram.
Ba thư viện được sử dụng phổ biến nhất hiện nay là Selenium, Playwright và Puppeteer. Chúng đều có khả năng điều khiển trình duyệt, truy cập Instagram và trích xuất dữ liệu trực tiếp từ giao diện.
Bước 1. Chuẩn bị môi trường
Trước khi bắt đầu, bạn cần chuẩn bị đầy đủ môi trường phát triển để scraper hoạt động ổn định. Việc thiết lập đúng ngay từ đầu sẽ giúp hạn chế lỗi trong quá trình triển khai.
Bạn cần chuẩn bị
- Python hoặc Node.js
- Selenium, Playwright hoặc Puppeteer
- Proxy (nếu chạy nhiều tài khoản)
- Thư mục lưu dữ liệu JSON hoặc CSV
Sau khi hoàn tất bước này, bạn đã sẵn sàng kết nối scraper với Instagram.
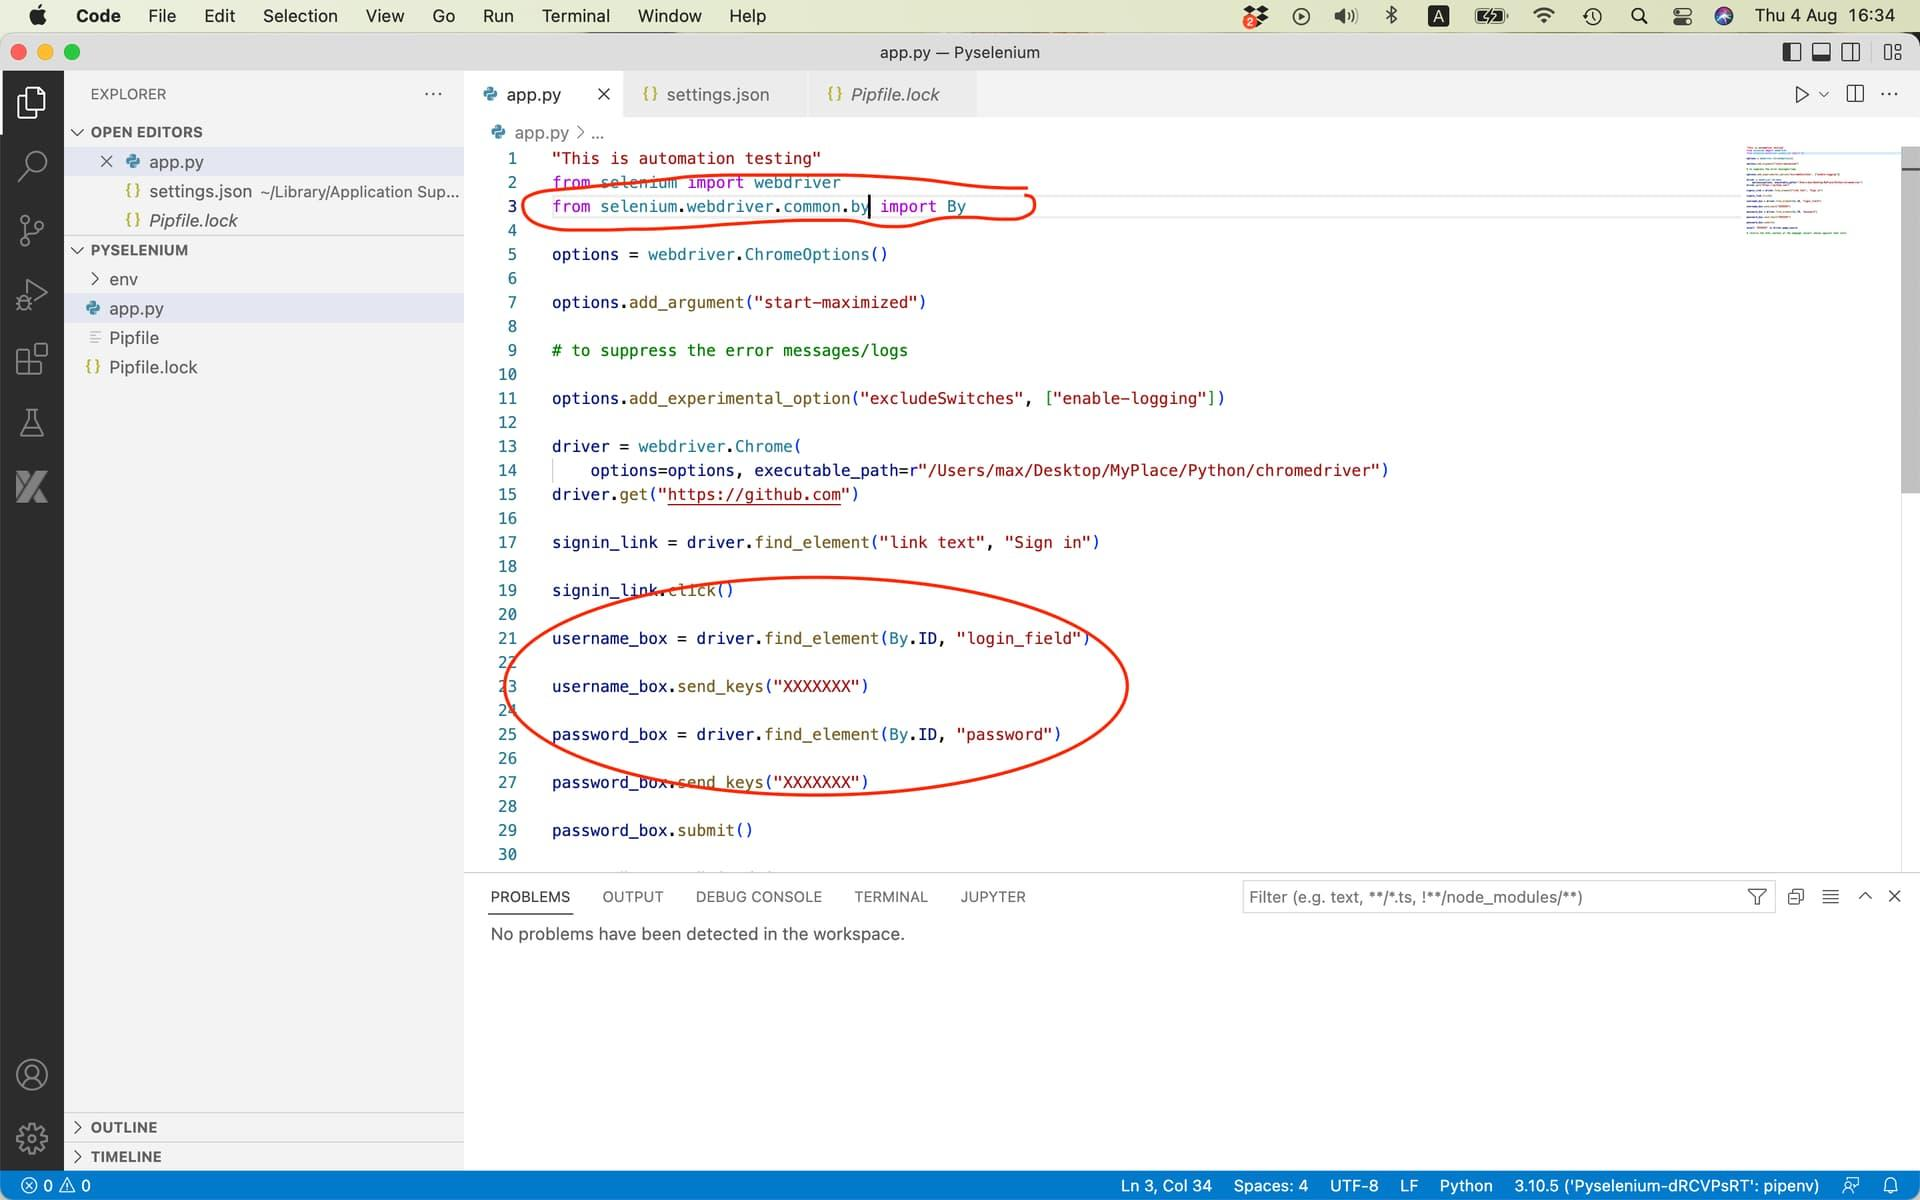
Môi trường phát triển với Python hoặc Node.js cùng thư viện Selenium, Playwright hoặc Puppeteer.
Bước 2. Kết nối tới Instagram
Ở bước tiếp theo, scraper sẽ mở trình duyệt và truy cập profile hoặc hashtag cần thu thập. Tùy từng workflow, bạn có thể scrape dữ liệu công khai hoặc đăng nhập trước để duy trì một phiên làm việc ổn định.
Quy trình kết nối cơ bản
- Khởi tạo trình duyệt.
- Mở URL profile hoặc hashtag.
- Đăng nhập (nếu cần).
- Chờ trang tải hoàn tất trước khi đọc dữ liệu.
Việc chờ trang tải đầy đủ sẽ giúp hạn chế lỗi thiếu dữ liệu, đặc biệt với Reels và nội dung tải động.
Bước 3. Trích xuất dữ liệu cần thiết
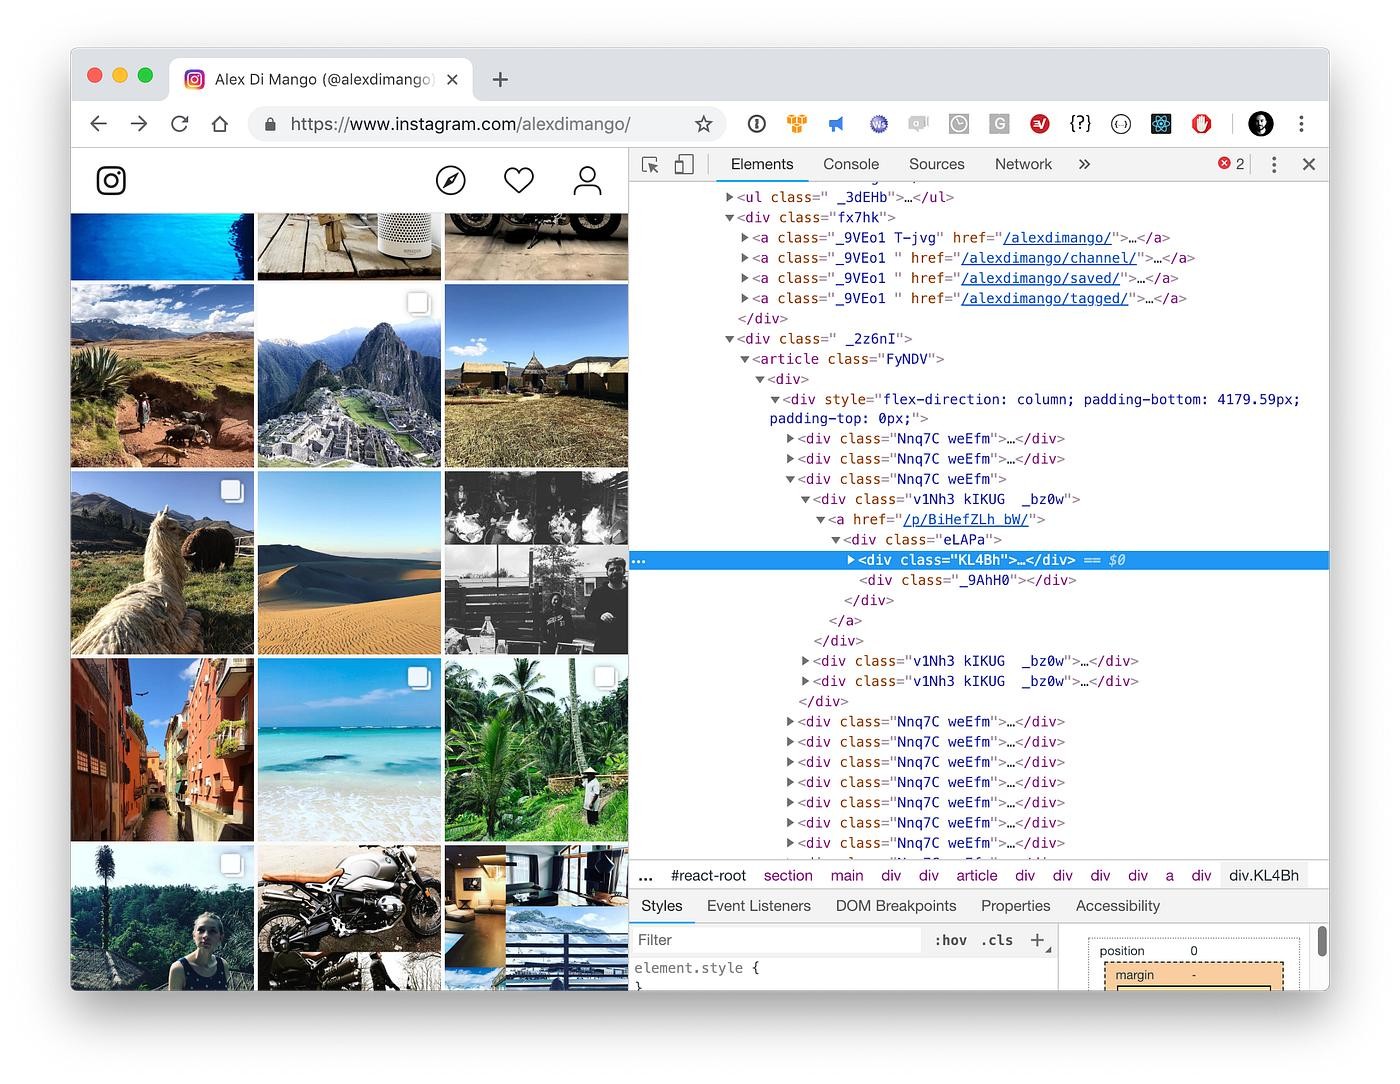
Khi trang đã hiển thị đầy đủ, scraper sẽ đọc các phần tử trên giao diện và lưu thành dữ liệu có cấu trúc. Tùy mục đích sử dụng, bạn có thể lấy nhiều hoặc ít trường thông tin khác nhau.
Những trường dữ liệu phổ biến gồm
- Username
- Caption
- Lượt thích
- Bình luận
- Hashtag
- Thời gian đăng
- URL bài viết
Bạn nên thống nhất tên các trường dữ liệu ngay từ đầu để thuận tiện khi phân tích bằng Excel, Power BI hoặc các công cụ BI khác.
Bước 4. Xuất dữ liệu ra JSON hoặc CSV
Sau khi thu thập xong, dữ liệu cần được làm sạch trước khi đưa vào phân tích. Đây là bước thường bị bỏ qua nhưng lại ảnh hưởng trực tiếp đến chất lượng dữ liệu đầu ra.
Quy trình xử lý dữ liệu
- Loại bỏ bản ghi trùng lặp.
- Chuẩn hóa định dạng ngày giờ.
- Kiểm tra ký tự và mã hóa dữ liệu.
- Xuất thành JSON hoặc CSV.
Kết quả sau cùng sẽ sẵn sàng để nhập vào Google Sheets, Excel hoặc các hệ thống phân tích dữ liệu.
Bước 5. Kết nối scraper với một profile Hidemyacc
Khi cần chạy nhiều tài khoản Instagram trên cùng một máy, bạn không nên để Selenium hoặc Puppeteer tự mở nhiều cửa sổ Chrome mới. Thay vào đó, scraper có thể kết nối trực tiếp với một profile đã được Hidemyacc khởi chạy thông qua CDP (Chrome DevTools Protocol).
Quy trình hoạt động gồm 3 bước
- Gọi Profile API của Hidemyacc để khởi chạy profile theo ID.
- Nhận địa chỉ CDP (WebSocket Debug URL).
- Kết nối Puppeteer tới profile và bắt đầu scraping.
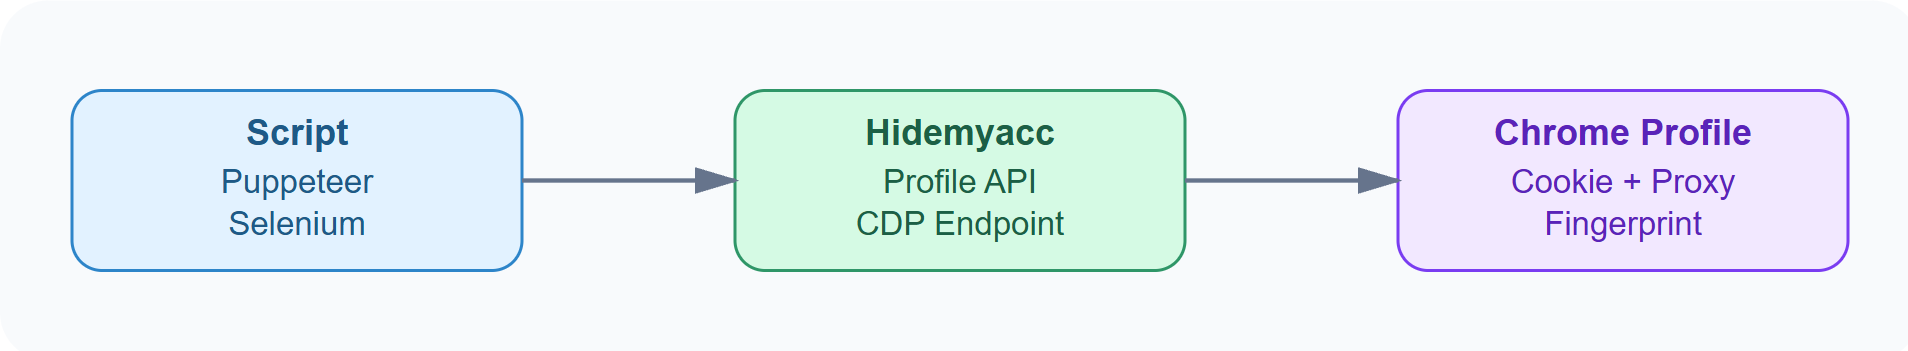
Kết nối scraper với một profile Hidemyacc
Thay vì tạo một trình duyệt hoàn toàn mới, Puppeteer sẽ kết nối vào đúng profile đã có sẵn cookie, proxy và browser fingerprint. Điều này giúp mỗi tài khoản Instagram hoạt động trong một môi trường riêng biệt và thuận tiện hơn khi chạy song song nhiều workflow scraping.
Ví dụ minh họa (Node.js + puppeteer-core)
const axios = require("axios");
const puppeteer = require("puppeteer-core");

async function scrapeWithHidemyaccProfile(profileId) {
  const { data } = await axios.post(
    "http://127.0.0.1:PORT_LOCAL_API/api/v3/profile/start",
    { profile_id: profileId }
  );

  const browser = await puppeteer.connect({
    browserWSEndpoint: data.ws_endpoint,
  });

  const page = await browser.newPage();

  await page.goto("https://www.instagram.com/target_profile/", {
    waitUntil: "networkidle2",
  });

  // Trích xuất dữ liệu tại đây

  await browser.disconnect();
}
Đoạn code trên minh họa cách kết nối scraper với một profile đã tồn tại thay vì tự mở trình duyệt mới. Khi chạy song song nhiều profile, mỗi profile sẽ có một CDP endpoint riêng và cần được quản lý độc lập để tránh xung đột.
6. So sánh các phương pháp thu thập dữ liệu Instagram
Sau khi tìm hiểu từng phương pháp, có thể thấy không có lựa chọn nào phù hợp với mọi trường hợp. Nếu bạn chỉ cần phân tích vài profile, công cụ miễn phí hoặc no-code sẽ tiết kiệm thời gian hơn. Ngược lại, những dự án cần dữ liệu lớn và chạy tự động lâu dài sẽ phù hợp với API hoặc scraper tự viết.
| Phương pháp | Chi phí | Độ khó | Phù hợp |
|---|---|---|---|
| Thu thập thủ công | Miễn phí | Thấp | Dữ liệu nhỏ |
| Công cụ mã nguồn mở | Miễn phí | Trung bình | Người biết Python |
| Dịch vụ API | Trả phí | Thấp | Doanh nghiệp, marketer |
| Tự viết scraper | Chi phí phát triển | Cao | Dự án riêng |
Lựa chọn đúng công cụ ngay từ đầu sẽ giúp bạn tiết kiệm đáng kể thời gian phát triển và chi phí vận hành, đặc biệt khi cần mở rộng quy mô thu thập dữ liệu trong tương lai.
7. Instagram có cho phép scraping không?
Đây là câu hỏi được tìm kiếm nhiều nhất khi bắt đầu thu thập dữ liệu Instagram. Câu trả lời ngắn gọn là Instagram không cung cấp API chính thức cho mọi trường hợp scraping, đồng thời nền tảng cũng có nhiều cơ chế nhằm hạn chế hoạt động thu thập dữ liệu tự động.
Điều quan trọng là bạn cần hiểu sự khác biệt giữa dữ liệu công khai và dữ liệu riêng tư, cũng như cách Instagram phát hiện các hành vi bất thường trước khi xây dựng workflow scraping.
7.1. Điều khoản dịch vụ của Meta
Meta khuyến khích các nhà phát triển sử dụng Instagram Graph API khi xây dựng ứng dụng hoặc quản lý dữ liệu của tài khoản Business và Creator. Trong khi đó, Instagram scraping hoạt động bằng cách đọc dữ liệu hiển thị trực tiếp trên giao diện, vì vậy không thuộc luồng truy cập chính thức của nền tảng.
Điều này không có nghĩa mọi hoạt động scraping đều bị cấm tuyệt đối, nhưng bạn nên giới hạn ở dữ liệu công khai và tuân thủ các quy định của Meta để giảm rủi ro cho tài khoản.
7.2. Public data và private data
Không phải mọi dữ liệu trên Instagram đều có thể thu thập được. Trước khi xây dựng scraper, bạn nên phân biệt rõ hai nhóm dữ liệu dưới đây.
| Public data | Private data |
|---|---|
| Profile công khai | Tin nhắn |
| Caption | Nội dung tài khoản private |
| Hashtag | Danh sách follower riêng tư |
| Bình luận công khai | Story chỉ dành cho người theo dõi |
| Số lượng follower | Dữ liệu yêu cầu cấp quyền |
Nói cách khác, scraping chủ yếu được sử dụng để thu thập dữ liệu công khai, còn các nội dung riêng tư vẫn được bảo vệ bởi cơ chế phân quyền của Instagram.
Vì sao Graph API không đủ?
Instagram Graph API là giải pháp chính thức của Meta, nhưng nó được thiết kế để quản lý dữ liệu của chính tài khoản đã cấp quyền, chứ không phải để nghiên cứu toàn bộ nền tảng. Đây cũng là lý do nhiều doanh nghiệp vẫn kết hợp scraping trong các bài toán phân tích thị trường.
Những giới hạn phổ biến gồm:
- Chỉ truy cập được dữ liệu của tài khoản đã cấp quyền.
- Không phù hợp để phân tích đối thủ hoặc influencer bên ngoài.
- Hạn chế khả năng thu thập dữ liệu từ hashtag và profile công khai ở quy mô lớn.
Nếu mục tiêu của bạn là theo dõi xu hướng nội dung hoặc thu thập dữ liệu công khai từ nhiều tài khoản khác nhau, Instagram scraping sẽ linh hoạt hơn Graph API.
7.3. Instagram phát hiện scraping bằng cách nào?
Nhiều người cho rằng chỉ cần thay đổi địa chỉ IP là có thể tránh bị phát hiện. Thực tế, Instagram sẽ kết hợp nhiều tín hiệu khác nhau để đánh giá liệu một phiên truy cập có giống hành vi của người dùng thật hay không, từ tốc độ gửi yêu cầu đến dấu vân tay của trình duyệt.
Những cơ chế phát hiện phổ biến gồm:
- Rate limit: Giới hạn số lượng request trong một khoảng thời gian. Nếu gửi quá nhiều yêu cầu liên tiếp, Instagram có thể tạm thời chặn phiên truy cập.
- CAPTCHA và Checkpoint: Xuất hiện khi hệ thống nghi ngờ tài khoản đang được điều khiển tự động hoặc đăng nhập từ môi trường bất thường.
- Phân tích hành vi: Theo dõi tốc độ cuộn trang, thời gian chờ giữa các thao tác và cách người dùng tương tác với nội dung để phân biệt bot với người thật.
- IP Reputation: Đánh giá mức độ uy tín của địa chỉ IP. Những IP từng bị lạm dụng hoặc được nhiều tài khoản sử dụng cùng lúc sẽ có rủi ro cao hơn.
- Browser Fingerprint: So sánh các thông số như User Agent, Canvas, WebGL, font, ngôn ngữ và độ phân giải màn hình để nhận diện thiết bị.
Thay vì cố gắng tăng tốc độ thu thập dữ liệu, bạn nên giới hạn số lượng request, thêm thời gian chờ ngẫu nhiên và duy trì môi trường truy cập ổn định để giảm nguy cơ bị Action Block hoặc Checkpoint.
8. Làm sao thu thập dữ liệu Instagram mà giảm nguy cơ bị block?
Một scraper tốt không chỉ lấy được dữ liệu, mà còn phải hoạt động ổn định trong thời gian dài. Trên thực tế, phần lớn tài khoản bị Action Block hoặc Checkpoint không phải vì công cụ sử dụng, mà do nhiều tài khoản dùng chung môi trường, gửi quá nhiều request hoặc thay đổi thiết bị liên tục. Dưới đây là 5 cách giúp giảm đáng kể nguy cơ bị Instagram phát hiện.
8.1. Dùng proxy riêng cho từng phiên
Địa chỉ IP là một trong những tín hiệu đầu tiên Instagram sử dụng để đánh giá mức độ bất thường của một phiên truy cập. Nếu nhiều tài khoản cùng hoạt động trên một IP, chúng rất dễ bị liên kết với nhau.
Bạn nên áp dụng nguyên tắc sau:
- Mỗi tài khoản sử dụng một proxy riêng.
- Ưu tiên proxy dân cư hoặc proxy di động thay vì proxy trung tâm dữ liệu.
- Hạn chế thay đổi IP liên tục trong cùng một phiên làm việc.
Việc duy trì một IP ổn định sẽ tự nhiên hơn nhiều so với việc liên tục đổi IP sau mỗi vài phút.
Có thể bạn quan tâm: 6 Dịch vụ proxy Instagram tốt nhất cho tài khoản an toàn
8.2. Tách browser fingerprint
Ngay cả khi đã đổi IP, Instagram vẫn có thể nhận diện thiết bị thông qua browser fingerprint. Đây là tập hợp nhiều thông số của trình duyệt như User Agent, Canvas, WebGL, font chữ, ngôn ngữ và độ phân giải màn hình.
Một fingerprint nhất quán thường bao gồm:
- User Agent
- Timezone
- Ngôn ngữ trình duyệt
- Canvas & WebGL
- Font và độ phân giải màn hình
Khi mỗi tài khoản có một fingerprint riêng, khả năng nhiều phiên bị liên kết sẽ giảm đáng kể.
8.3. Chia nhiều profile thay vì một tài khoản
Nhiều người quản lý 5–10 tài khoản Instagram nhưng đều đăng nhập trong cùng một Chrome. Điều này khiến cookie, session và fingerprint dễ bị chồng chéo, đặc biệt khi chạy automation.
Nguyên tắc nên áp dụng là:
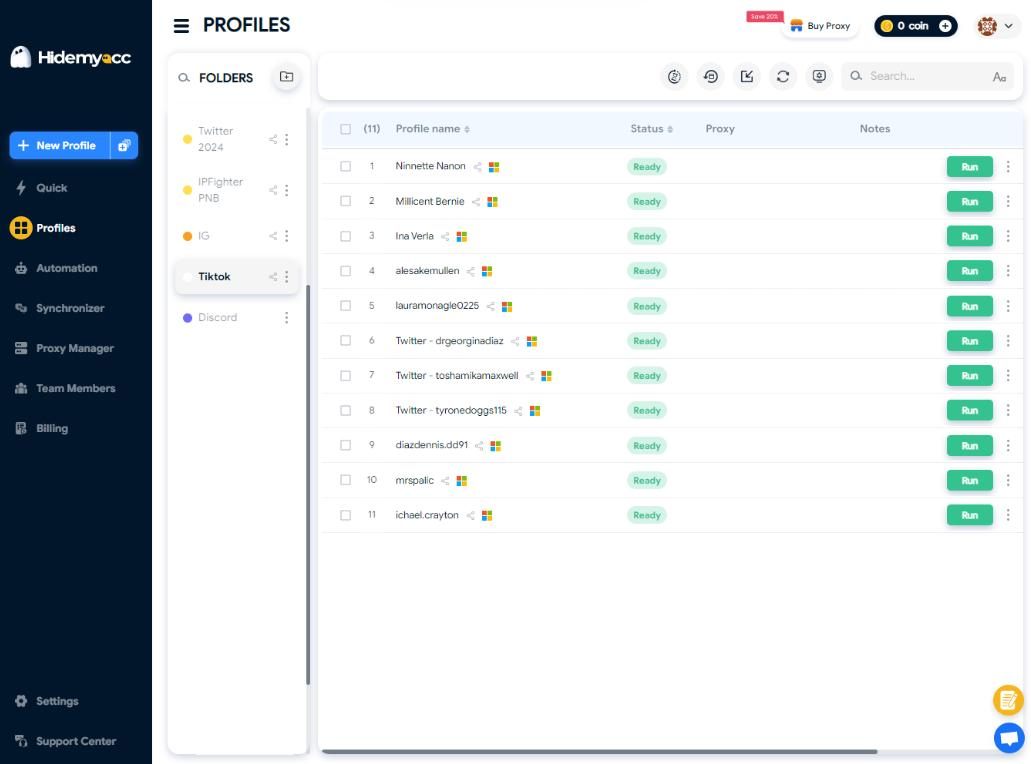
- Một tài khoản \= một profile trình duyệt.
- Mỗi profile có cookie và session riêng.
- Gắn proxy riêng cho từng profile.
- Không thay đổi fingerprint sau mỗi lần đăng nhập.
Đây cũng là cách nhiều developer kết hợp antidetect browser Hidemyacc với Selenium, Playwright hoặc Puppeteer. Thay vì để script tự mở nhiều cửa sổ Chrome mới, scraper sẽ kết nối trực tiếp vào từng profile đã được Hidemyacc khởi chạy thông qua CDP, giúp mỗi tài khoản duy trì một môi trường trình duyệt độc lập và ổn định.
8.4. Thêm delay, mô phỏng hành vi người dùng
Instagram không chỉ đếm số lượng request mà còn theo dõi nhịp độ tương tác của mỗi phiên truy cập. Một scraper liên tục mở profile, cuộn trang và gửi hàng chục request trong vài giây sẽ có hành vi rất khác so với người dùng thật, từ đó dễ kích hoạt CAPTCHA hoặc Action Block.
Để workflow tự nhiên hơn, bạn nên điều chỉnh script theo các nguyên tắc sau:
- Thêm thời gian chờ ngẫu nhiên giữa mỗi request thay vì dùng một khoảng cố định.
- Cuộn trang từng phần để nội dung tải dần, thay vì lấy toàn bộ dữ liệu ngay lập tức.
- Nghỉ vài giây khi chuyển sang profile hoặc hashtag khác.
- Giới hạn số lượng profile xử lý trong mỗi phiên làm việc.
Giảm tốc độ scraping có thể khiến thời gian thu thập lâu hơn, nhưng đổi lại sẽ giúp session ổn định và giảm đáng kể nguy cơ bị Instagram đánh dấu là hoạt động tự động.
Đọc thêm: Cách xử lý lỗi nghi ngờ hành vi tự động trên tài khoản Instagram
8.5. Theo dõi thay đổi API và endpoint
Instagram thường xuyên thay đổi cấu trúc HTML, selector và endpoint phía sau giao diện. Vì vậy, một scraper đang hoạt động bình thường hôm nay vẫn có thể trả về dữ liệu rỗng sau một bản cập nhật của nền tảng.
Bạn nên kiểm tra định kỳ:
- Selector của profile và bài đăng.
- Endpoint trả dữ liệu.
- Định dạng JSON đầu ra.
- Tỷ lệ request lỗi hoặc dữ liệu thiếu.
Việc bảo trì định kỳ sẽ giúp scraper ổn định hơn và giảm thời gian sửa lỗi khi Instagram thay đổi cấu trúc hệ thống.
9. Sai lầm thường gặp khi thu thập dữ liệu Instagram
Ngay cả khi sử dụng đúng công cụ, một workflow scraping vẫn có thể bị Action Block hoặc Checkpoint nếu triển khai không đúng cách. Những sai lầm dưới đây là nguyên nhân phổ biến khiến tài khoản bị giới hạn hoặc dữ liệu thu thập kém ổn định.
- Dùng chung proxy hoặc IP cho nhiều tài khoản: Khi nhiều tài khoản cùng hoạt động trên một địa chỉ IP, Instagram sẽ dễ liên kết các phiên truy cập với nhau. Mỗi tài khoản nên có proxy riêng để giảm rủi ro bị ảnh hưởng dây chuyền.
- Không giới hạn tốc độ request: Gửi hàng chục request liên tiếp trong vài giây là hành vi rất khác với người dùng thật. Thêm delay ngẫu nhiên và chia nhỏ khối lượng dữ liệu sẽ giúp scraper hoạt động ổn định hơn.
- Bỏ qua điều khoản dịch vụ của Meta: Scraping nên được giới hạn ở dữ liệu công khai và phục vụ những mục đích hợp pháp như nghiên cứu thị trường hoặc phân tích nội dung. Việc cố gắng truy cập dữ liệu riêng tư sẽ làm tăng cả rủi ro kỹ thuật lẫn rủi ro về chính sách.
- Chỉ kiểm tra script mà không kiểm tra dữ liệu đầu ra: Một scraper có thể chạy thành công nhưng vẫn trả về caption thiếu, thời gian đăng sai hoặc dữ liệu rỗng. Sau mỗi lần thu thập, bạn nên kiểm tra ngẫu nhiên một phần dữ liệu để đảm bảo chất lượng trước khi đưa vào phân tích.
Tránh được những sai lầm trên sẽ giúp workflow scraping bền vững hơn và giảm đáng kể nguy cơ tài khoản bị Instagram đình chỉ trong quá trình hoạt động.
10. Kết luận
Instagram scraping là một trong những cách hiệu quả nhất để thu thập dữ liệu công khai phục vụ phân tích đối thủ, nghiên cứu thị trường và theo dõi xu hướng nội dung. Tùy vào quy mô dự án, bạn có thể lựa chọn từ phương pháp thủ công, công cụ mã nguồn mở, dịch vụ API cho đến tự xây dựng scraper bằng Selenium, Playwright hoặc Puppeteer.
Tuy nhiên, công cụ chỉ là một phần của workflow. Để quá trình thu thập dữ liệu hoạt động ổn định trong thời gian dài, bạn cần quản lý tốt proxy, browser fingerprint, session và tốc độ request của từng tài khoản. Một môi trường được tách biệt và nhất quán sẽ giúp giảm đáng kể nguy cơ bị Action Block hoặc Checkpoint, đồng thời nâng cao chất lượng dữ liệu thu thập được.
Nếu bạn đang xây dựng hệ thống scraping nhiều tài khoản Instagram, hãy ưu tiên thiết kế workflow an toàn ngay từ đầu thay vì chỉ tập trung vào tốc độ thu thập dữ liệu.
Bài viết liên quan:
- Top công cụ scraping X (Twitter) đáng dùng để lấy dữ liệu
- Hướng dẫn chọn proxy Google Scraping: Top 7 dịch vụ tốt nhất 2026
- Hướng dẫn LinkedIn Scraping cho marketing và bán hàng
- Top công cụ AI miễn phí cho web scraping bạn không nên bỏ qua
12. FAQ
1. Instagram scraping có hợp pháp không?
Instagram scraping không hoàn toàn là bất hợp pháp, nhưng việc sử dụng công cụ tự động để thu thập dữ liệu có thể vi phạm Điều khoản dịch vụ của Meta. Nếu dùng cho mục đích nghiên cứu hoặc phân tích dữ liệu công khai, bạn vẫn cần tuân thủ các quy định của nền tảng.
2. Có thu thập được dữ liệu tài khoản private không?
Không. Instagram scraping chủ yếu chỉ thu thập được dữ liệu công khai như profile, bài đăng hoặc hashtag. Nội dung của tài khoản private sẽ không thể truy cập nếu không có quyền hợp lệ.
3. Instagram Graph API và scraping khác nhau thế nào?
Graph API là giải pháp chính thức của Meta, yêu cầu tài khoản cấp quyền truy cập và phù hợp với ứng dụng doanh nghiệp. Scraping thì lấy dữ liệu trực tiếp từ giao diện Instagram, thường được dùng để phân tích đối thủ hoặc nghiên cứu thị trường.
4. Thu thập dữ liệu follower có bị khóa tài khoản không?
Có thể. Việc gửi quá nhiều request trong thời gian ngắn hoặc truy cập follower với tần suất bất thường dễ khiến tài khoản bị giới hạn, CAPTCHA hoặc checkpoint. Thực hiện với tốc độ hợp lý sẽ giảm rủi ro hơn.
5. Công cụ thu thập dữ liệu Instagram nào phù hợp cho người mới?
Nếu không biết lập trình, Apify hoặc PhantomBuster là lựa chọn dễ sử dụng nhờ có sẵn workflow và giao diện trực quan. Nếu biết Python cơ bản, Instaloader sẽ linh hoạt và tiết kiệm chi phí hơn.