Bạn muốn thu thập dữ liệu sản phẩm, giá, review hoặc thông tin người bán trên Amazon nhưng chưa biết nên dùng cách nào? Tự viết scraper cho phép bạn kiểm soát quy trình, trong khi headless browser, API và các dịch vụ scraping lại phù hợp với những nhu cầu khác nhau. Chọn sai phương pháp có thể khiến việc thu thập dữ liệu tốn nhiều thời gian, khó mở rộng hoặc liên tục gặp CAPTCHA và giới hạn truy cập. Bài viết này sẽ phân tích từng phương pháp Amazon scraper phổ biến để bạn dễ dàng xác định hướng triển khai phù hợp.
1. Amazon Scraper là gì và hoạt động như nào?
Amazon scraper là công cụ hoặc đoạn mã giúp tự động thu thập dữ liệu từ Amazon thay vì phải mở từng trang và sao chép thông tin thủ công. Tùy mục đích, bạn có thể lấy tên sản phẩm, mã ASIN, giá, số sao, số lượng đánh giá, thông tin người bán hoặc tình trạng còn hàng.
Quy trình cơ bản bắt đầu từ việc truy cập trang sản phẩm và lấy dữ liệu HTML hoặc JSON được trả về. Scraper sau đó xác định những trường thông tin cần thiết, tách dữ liệu và lưu vào tệp hoặc cơ sở dữ liệu để tiếp tục xử lý.
Chẳng hạn, nếu bạn chỉ muốn theo dõi giá của một số sản phẩm mỗi ngày, một đoạn mã đơn giản đã có thể đáp ứng nhu cầu. Khi số lượng sản phẩm tăng lên hoặc dữ liệu cần thu thập phức tạp hơn, bạn có thể chuyển sang trình duyệt tự động, API chính thức hoặc dịch vụ scraping API.
2. Tự viết script scraper với Requests + BeautifulSoup/Scrapy
Nếu bạn có kiến thức Python và muốn tự kiểm soát quá trình thu thập dữ liệu, Requests kết hợp với BeautifulSoup hoặc Scrapy là một điểm bắt đầu khá phổ biến. Thay vì mở trình duyệt, chương trình gửi yêu cầu trực tiếp đến URL Amazon, nhận nội dung trang rồi tìm đến những phần dữ liệu cần lấy.
Với một trang sản phẩm đơn giản, đoạn mã có thể bắt đầu từ việc lấy tên và giá như sau:
import requests
from bs4 import BeautifulSoup

url = "https://www.amazon.com/dp/PRODUCT_ID"

headers = {
    "User-Agent": "Mozilla/5.0"
}

# Gửi yêu cầu và nhận nội dung trang
response = requests.get(url, headers=headers, timeout=10)

soup = BeautifulSoup(response.text, "html.parser")

title = soup.select_one("#productTitle")
price = soup.select_one(".a-price .a-offscreen")

print("Product:", title.get_text(strip=True) if title else "N/A")
print("Price:", price.get_text(strip=True) if price else "N/A")
Điểm đáng chú ý ở cách làm này là bạn có thể tự quyết định scraper sẽ lấy trường nào, xử lý dữ liệu ra sao và lưu kết quả ở đâu. Chi phí ban đầu cũng thấp vì các thư viện cần thiết đều có thể sử dụng trong môi trường Python.
Dù vậy, phần khó thường nằm ở quá trình duy trì chứ không phải vài dòng code đầu tiên. Amazon có thể áp dụng CAPTCHA, giới hạn truy cập hoặc thay đổi cấu trúc HTML. Khi đó, selector đang dùng có thể không còn lấy đúng dữ liệu. Bạn cũng phải tự xử lý proxy, User Agent, lỗi kết nối và các yêu cầu gửi lại khi request thất bại.
Vì vậy, cách này hợp với người có khả năng lập trình và đang xử lý khối lượng dữ liệu vừa phải. Ví dụ, một người làm dropshipping muốn kiểm tra giá của khoảng 50 sản phẩm mỗi ngày có thể bắt đầu bằng scraper tự viết thay vì đầu tư ngay vào một dịch vụ bên ngoài.
3. Dùng headless browser với Puppeteer, Selenium, Playwright
Không phải nội dung nào trên Amazon cũng xuất hiện đầy đủ ngay trong phản hồi HTML ban đầu. Một số thành phần cần JavaScript để tải hoặc thay đổi sau khi trang được mở. Trong trường hợp đó, trình duyệt tự động như Puppeteer, Selenium và Playwright sẽ có lợi thế hơn cách gửi request trực tiếp.
Cách hoạt động tương đối giống một trình duyệt thông thường. Chương trình mở URL, chờ trang tải nội dung cần thiết, sau đó đọc dữ liệu từ giao diện đã được tạo ra. Với Playwright, bạn có thể lấy rating của sản phẩm bằng đoạn mã ngắn như sau:
from playwright.sync_api import sync_playwright

url = "https://www.amazon.com/dp/PRODUCT_ID"

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True)
    page = browser.new_page()

    page.goto(url, wait_until="domcontentloaded")
    page.wait_for_selector("#acrPopover")

    rating = page.locator("#acrPopover").inner_text()

    print("Rating:", rating)

    browser.close()
Ưu thế của phương pháp này nằm ở khả năng xử lý những trang có nội dung động và các thao tác cần đến trình duyệt. Bạn cũng có thể mở trang, chờ một phần tử xuất hiện rồi mới lấy dữ liệu, thay vì phải xử lý toàn bộ nội dung ngay từ phản hồi đầu tiên.
Đổi lại, trình duyệt tự động cần nhiều tài nguyên hơn. Nếu chạy đồng thời nhiều phiên, máy chủ sẽ phải xử lý thêm bộ nhớ và tài nguyên CPU. Tốc độ thu thập cũng có thể thấp hơn so với việc gửi request trực tiếp. Ngoài ra, việc sử dụng trình duyệt tự động không đồng nghĩa với việc tránh được các cơ chế phát hiện hoạt động tự động.
Đây là lựa chọn đáng cân nhắc khi dữ liệu bạn cần phụ thuộc vào JavaScript hoặc quy trình thu thập có nhiều bước tương tác. Ví dụ, một nhóm nghiên cứu thị trường cần cập nhật rating và đánh giá của nhiều sản phẩm theo lịch có thể xây dựng quy trình bằng Playwright để tự động mở và xử lý các trang cần thiết.
4. Amazon Product Advertising API và Creators API
Thay vì tự lấy dữ liệu từ mã nguồn trang Amazon, bạn cũng có thể sử dụng API do Amazon cung cấp nếu đáp ứng các điều kiện tham gia. Với cách này, chương trình gửi yêu cầu đến hệ thống API và nhận dữ liệu theo cấu trúc được Amazon hỗ trợ.
Đây là điểm khác biệt lớn so với hai phương pháp trên. Bạn không phải tự tìm selector trong HTML và cũng không cần xây dựng bộ phân tích riêng cho từng thành phần của trang. Dữ liệu được trả về theo các trường mà API cung cấp, giúp quá trình xử lý phía sau gọn hơn.
Tuy nhiên, API chính thức không phải lựa chọn mà bất kỳ dự án nào cũng có thể sử dụng ngay. Quyền truy cập, giới hạn sử dụng và phạm vi dữ liệu phụ thuộc vào điều kiện của Amazon. Vì vậy, trước khi xây dựng hệ thống dựa trên API, bạn cần kiểm tra yêu cầu hiện hành và xác định dữ liệu mình cần có được hỗ trợ hay không.
Amazon cũng đang chuyển đổi từ Product Advertising API 5 sang Creators API. Nếu bạn dự định xây dựng một hệ thống sử dụng API trong thời gian dài, nên kiểm tra tài liệu mới nhất của Amazon thay vì chỉ dựa vào hướng dẫn cũ.
Với những người đủ điều kiện và cần một nguồn dữ liệu có cấu trúc rõ ràng, đây có thể là hướng triển khai phù hợp hơn so với việc tự duy trì scraper dựa trên HTML.
5. Dùng dịch vụ scraping API trả phí
Các dịch vụ scraping API trả phí phù hợp với những dự án cần thu thập dữ liệu Amazon thường xuyên nhưng không muốn tự xây dựng và duy trì toàn bộ hệ thống. Thay vì tự xử lý từng yêu cầu truy cập, proxy hay nội dung trang, bạn có thể gửi yêu cầu qua API và nhận dữ liệu theo định dạng mà dịch vụ hỗ trợ.
Mỗi nền tảng có cách tiếp cận khác nhau. Một số dịch vụ cung cấp sẵn công cụ thu thập dữ liệu Amazon, trong khi những dịch vụ khác tập trung vào proxy, xử lý nội dung động hoặc môi trường chạy mã. Dưới đây là một số lựa chọn phổ biến.
5.1 Bright Data
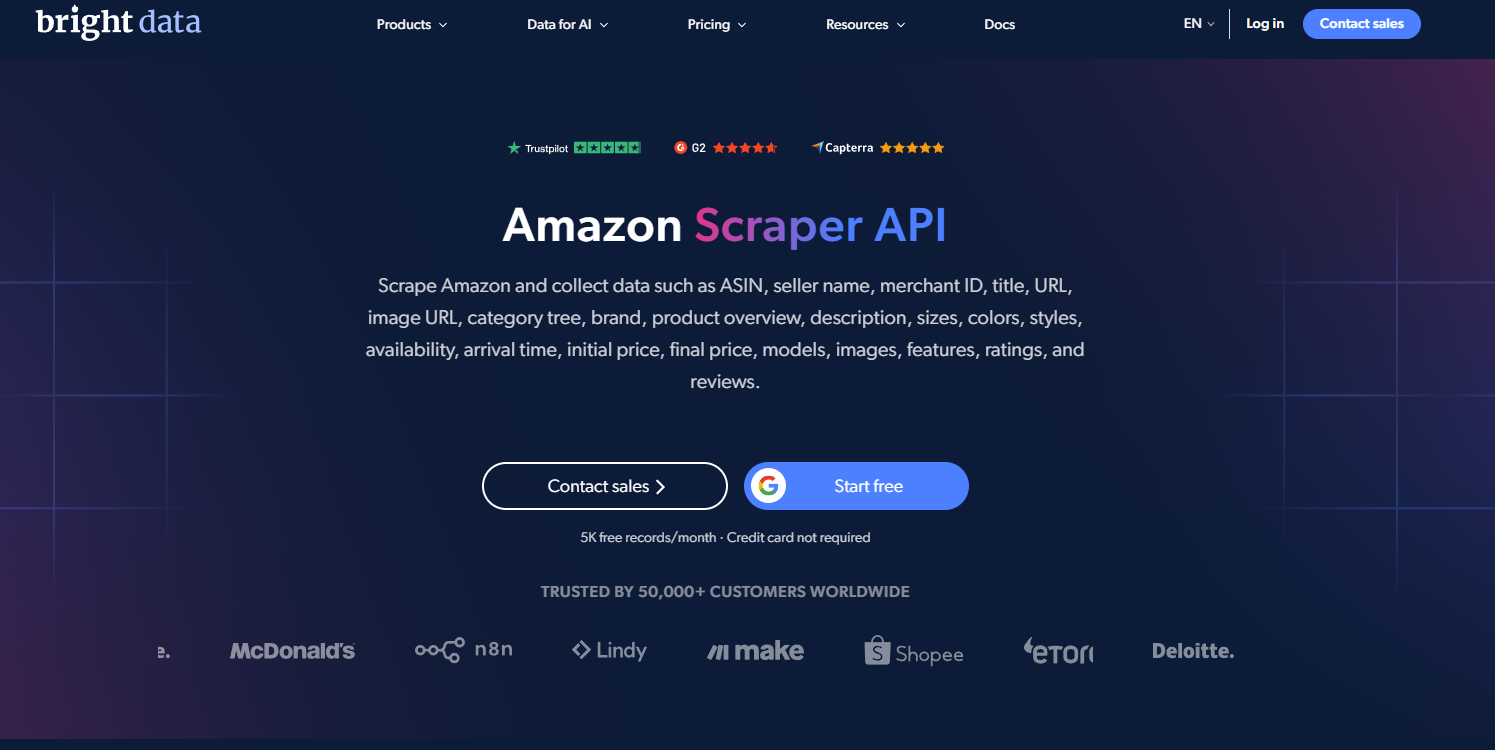
Bright Data cung cấp Amazon Scraper API cho phép thu thập dữ liệu Amazon mà không cần tự xây dựng toàn bộ scraper và hệ thống proxy. Công cụ phù hợp với các dự án cần lấy dữ liệu sản phẩm ở quy mô lớn.
Tính năng chính:
- Amazon Scraper API: Thu thập dữ liệu sản phẩm, giá, đánh giá và kết quả tìm kiếm Amazon thông qua API.
- Dữ liệu có cấu trúc: Trả về dữ liệu đã được xử lý, giúp bạn dễ đưa vào hệ thống phân tích hoặc lưu trữ.
- Proxy tích hợp: Hỗ trợ nhiều loại proxy để phục vụ các yêu cầu thu thập dữ liệu với quy mô khác nhau.
- Web Unlocker: Hỗ trợ xử lý các cơ chế kiểm soát truy cập trong quá trình thu thập dữ liệu.
Những tính năng này giúp Bright Data giảm đáng kể phần công việc phải tự xây dựng khi triển khai Amazon scraper, đặc biệt với các dự án có lượng dữ liệu lớn.
Ưu điểm:
- Khả năng mở rộng tốt: Phù hợp với các tác vụ thu thập dữ liệu Amazon có khối lượng lớn.
- Hạ tầng proxy đa dạng: Có nhiều lựa chọn về loại proxy và vị trí.
- Giảm công việc kỹ thuật: Không cần tự xây dựng toàn bộ hệ thống proxy và xử lý truy cập.
- Nhiều loại dữ liệu: Có thể sử dụng cho dữ liệu sản phẩm, tìm kiếm, giá và đánh giá.
Tuy vậy, quy mô lớn và nhiều tùy chọn cũng khiến Bright Data có một số điểm cần cân nhắc:
Nhược điểm:
- Chi phí: Có thể khá cao khi lượng dữ liệu và số request tăng.
- Độ phức tạp: Nền tảng có nhiều tính năng nên người mới cần thời gian làm quen.
- Yêu cầu kỹ thuật: Một số cách triển khai cần kiến thức về API và thu thập dữ liệu.
Bright Data phù hợp với doanh nghiệp và đội ngũ kỹ thuật cần triển khai Amazon scraper ở quy mô lớn. Với nhu cầu nhỏ, bạn có thể ưu tiên những API đơn giản hơn để giảm chi phí và thời gian thiết lập.
5.2 Oxylabs
Oxylabs cung cấp Amazon Scraper API kết hợp với hệ thống proxy, hướng đến các dự án cần thu thập dữ liệu thương mại điện tử ở quy mô lớn. Dịch vụ này giúp bạn lấy dữ liệu Amazon thông qua API thay vì tự xây dựng toàn bộ hệ thống scraping.
Tính năng chính:
- Amazon Scraper API: Thu thập dữ liệu sản phẩm, giá, đánh giá và kết quả tìm kiếm trên Amazon.
- Dữ liệu có cấu trúc: Trả về dữ liệu đã được xử lý để thuận tiện cho việc phân tích và lưu trữ.
- Proxy tích hợp: Cung cấp hạ tầng proxy phục vụ các tác vụ thu thập dữ liệu với nhiều yêu cầu khác nhau.
- Thu thập dữ liệu theo quy mô: Có thể sử dụng cho các dự án cần xử lý lượng lớn trang Amazon.
Các tính năng trên giúp Oxylabs tập trung khá rõ vào nhu cầu thu thập dữ liệu thương mại điện tử. Một số ưu điểm đáng chú ý gồm:
Ưu điểm:
- Phù hợp với quy mô lớn: Có hạ tầng phục vụ các dự án cần thu thập lượng dữ liệu Amazon lớn.
- Kết hợp scraper và proxy: Bạn không cần tự xây dựng riêng hai phần này.
- Dữ liệu đa dạng: Hỗ trợ nhiều loại thông tin phổ biến từ sản phẩm và kết quả tìm kiếm Amazon.
- Khả năng mở rộng: Phù hợp khi nhu cầu thu thập dữ liệu tăng theo thời gian.
Tuy nhiên, những lợi thế về hạ tầng và quy mô cũng đi kèm một số hạn chế:
Nhược điểm:
- Chi phí: Có thể không kinh tế với dự án chỉ cần thu thập một lượng nhỏ dữ liệu.
- Cấu hình: Người mới có thể cần thời gian để làm quen với API và các tùy chọn triển khai.
- Không cần thiết cho nhu cầu đơn giản: Nếu chỉ theo dõi một số ít sản phẩm, việc sử dụng nền tảng lớn có thể tạo thêm chi phí không cần thiết.
Oxylabs phù hợp hơn với doanh nghiệp và đội ngũ kỹ thuật cần thu thập dữ liệu Amazon thường xuyên, đặc biệt khi dự án có yêu cầu về quy mô và khả năng mở rộng.
5.3 ScraperAPI
ScraperAPI tập trung vào việc đơn giản hóa Amazon scraping thông qua các API có sẵn. Điểm đáng chú ý của công cụ là cung cấp các endpoint riêng cho từng loại dữ liệu Amazon, giúp bạn không phải tự phân tích HTML trong những trường hợp API đã hỗ trợ.
Tính năng chính:
- Product API: Thu thập thông tin chi tiết về sản phẩm Amazon.
- Search API: Lấy dữ liệu từ kết quả tìm kiếm theo từ khóa.
- Offers API: Thu thập thông tin về ưu đãi và người bán.
- Reviews API: Lấy dữ liệu đánh giá sản phẩm.
- Dữ liệu JSON: Trả về dữ liệu đã được cấu trúc để dễ dàng tích hợp vào ứng dụng.
Nhờ các endpoint được thiết kế riêng cho Amazon, ScraperAPI có lợi thế về sự đơn giản khi triển khai:
Ưu điểm:
- Dễ tích hợp: Có thể kết nối với ứng dụng thông qua API mà không cần xây dựng scraper từ đầu.
- Dữ liệu có cấu trúc: Giảm công việc xử lý HTML và trích xuất dữ liệu.
- Nhiều loại dữ liệu: Hỗ trợ sản phẩm, tìm kiếm, ưu đãi và đánh giá.
- Phù hợp với dự án nhỏ và vừa: Không cần xây dựng một hệ thống scraping quá phức tạp.
Dù dễ triển khai, ScraperAPI vẫn có một số giới hạn mà bạn nên kiểm tra trước khi sử dụng:
Nhược điểm:
- Giới hạn theo API: Một số loại dữ liệu hoặc endpoint có thể có điều kiện sử dụng riêng.
- Chi phí tăng theo mức sử dụng: Dự án càng nhiều request thì chi phí càng cao.
- Khả năng tùy chỉnh: Những nhu cầu nằm ngoài dữ liệu mà endpoint hỗ trợ có thể vẫn cần xử lý riêng.
5.4 Apify Amazon Scraper
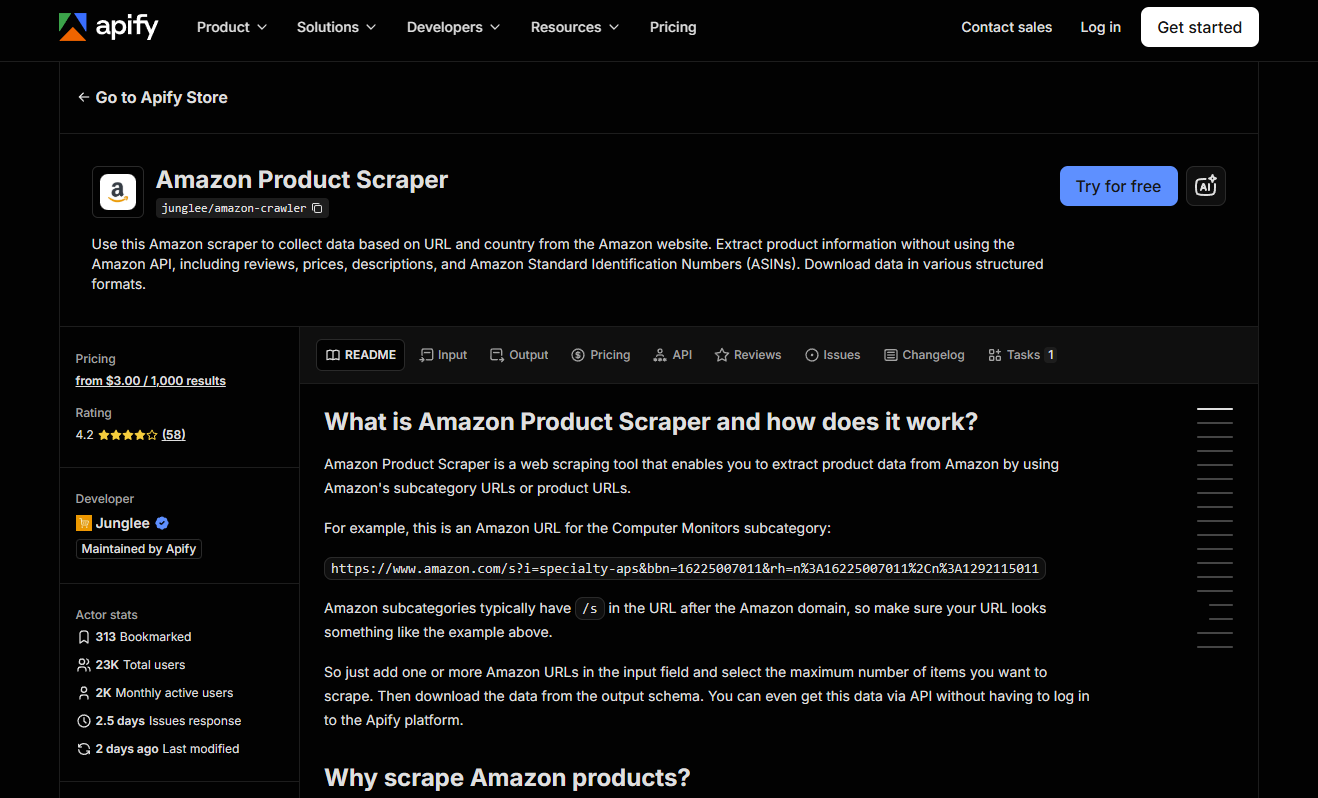
Apify cung cấp nhiều Actor dành cho Amazon, cho phép bạn sử dụng scraper có sẵn thay vì tự phát triển từ đầu. Công cụ hỗ trợ cả giao diện trực tiếp trên nền tảng và API, nên có thể đáp ứng nhiều mức độ kỹ thuật khác nhau.
Tính năng chính:
- Amazon Product Scraper: Thu thập thông tin từ trang sản phẩm như tên, giá, đánh giá và các dữ liệu liên quan.
- Amazon Search Scraper: Lấy dữ liệu từ kết quả tìm kiếm Amazon theo từ khóa.
- Amazon Reviews Scraper: Thu thập thông tin đánh giá sản phẩm.
- API: Cho phép kết nối Actor với ứng dụng hoặc hệ thống bên ngoài.
Điểm mạnh của Apify nằm ở việc bạn có thể bắt đầu bằng scraper có sẵn trước khi chuyển sang cách triển khai tùy chỉnh:
Ưu điểm:
- Có scraper sẵn: Tiết kiệm thời gian phát triển ban đầu.
- Dễ bắt đầu: Có thể chạy scraper trực tiếp trên giao diện mà không cần viết nhiều code.
- Có API: Thuận tiện khi muốn đưa dữ liệu vào quy trình riêng.
- Nhiều lựa chọn: Có nhiều Actor phục vụ các loại dữ liệu Amazon khác nhau.
Tuy nhiên, việc phụ thuộc vào Actor cũng tạo ra một số điểm cần cân nhắc:
Nhược điểm:
- Độ ổn định không đồng đều: Chất lượng có thể khác nhau giữa các Actor.
- Phụ thuộc vào Actor: Những thay đổi từ Amazon có thể khiến scraper cần được cập nhật.
- Chi phí: Mức sử dụng và tài nguyên của Actor có thể ảnh hưởng đến tổng chi phí.
Apify phù hợp với người mới, nhóm nhỏ và lập trình viên muốn triển khai Amazon scraper nhanh, đồng thời vẫn có lựa chọn kết nối API khi nhu cầu tăng lên.
5.5 Zyte
Zyte cung cấp Zyte API và Scrapy Cloud, hướng đến những dự án cần xây dựng quy trình scraping có khả năng tùy chỉnh cao. Thay vì chỉ sử dụng scraper Amazon có sẵn, bạn có thể kết hợp Zyte với Scrapy để kiểm soát cách thu thập và xử lý dữ liệu.
Tính năng chính:
- Zyte API: Gửi yêu cầu thu thập dữ liệu thông qua API và hỗ trợ xử lý các vấn đề liên quan đến truy cập.
- Scrapy Cloud: Chạy và quản lý dự án Scrapy trên môi trường đám mây.
- Hỗ trợ JavaScript: Có khả năng xử lý các trang cần JavaScript tùy theo phương thức triển khai.
- Tùy chỉnh scraper: Cho phép xây dựng logic thu thập dữ liệu riêng thay vì phụ thuộc hoàn toàn vào scraper có sẵn.
Zyte có lợi thế rõ hơn khi bạn cần một hệ thống scraping được xây dựng theo yêu cầu riêng:
Ưu điểm:
- Khả năng tùy chỉnh cao: Phù hợp với các scraper có logic thu thập dữ liệu riêng.
- Kết hợp với Scrapy: Thuận tiện cho đội ngũ đã sử dụng framework này.
- Hỗ trợ triển khai trên nền tảng đám mây: Giảm công việc tự quản lý máy chủ.
- Phù hợp với dự án dài hạn: Có thể phát triển scraper từ quy mô nhỏ lên hệ thống lớn hơn.
Ngược lại, Zyte không phải lựa chọn đơn giản nhất nếu bạn chỉ muốn lấy nhanh một lượng nhỏ dữ liệu Amazon:
Nhược điểm:
- Yêu cầu kỹ thuật: Cần có kiến thức về Scrapy và cách xây dựng scraper.
- Thời gian triển khai: Xây dựng scraper riêng mất nhiều thời gian hơn dùng API có sẵn.
- Không phù hợp với nhu cầu quá đơn giản: Một số dự án nhỏ có thể không cần đến mức độ tùy chỉnh này.
Zyte phù hợp với lập trình viên và đội ngũ kỹ thuật cần xây dựng Amazon scraper riêng, đặc biệt khi scraper là một phần của hệ thống thu thập dữ liệu lớn hơn.
5.6 ScrapingBee
ScrapingBee là scraping API hỗ trợ nhiều loại website, trong đó có thể sử dụng cho các tác vụ thu thập dữ liệu Amazon. Công cụ tập trung vào việc xử lý request, proxy và JavaScript thông qua API để bạn không phải tự quản lý trình duyệt tự động hóa.
Tính năng chính:
- JavaScript rendering: Hỗ trợ tải những trang cần JavaScript để hiển thị nội dung.
- Proxy tích hợp: Xử lý proxy trong quá trình gửi request.
- Scraping API: Gửi URL và các thông số cần thiết thông qua API để nhận nội dung trang.
- Thu thập dữ liệu nhiều website: Có thể sử dụng cùng một API cho Amazon và các website khác.
Với cách triển khai qua API, ScrapingBee có lợi thế ở sự đơn giản và khả năng sử dụng cho nhiều loại website:
Ưu điểm:
- Dễ tích hợp: Không cần tự xây dựng hệ thống trình duyệt và proxy.
- Hỗ trợ JavaScript: Phù hợp với các trang có nội dung được tải động.
- Sử dụng linh hoạt: Có thể áp dụng cho Amazon và nhiều website khác trong cùng dự án.
- Tiết kiệm công sức vận hành: Một phần hạ tầng scraping được xử lý bởi dịch vụ.
Tuy nhiên, ScrapingBee không tập trung riêng vào Amazon nên bạn cần cân nhắc một số điểm khi sử dụng cho dữ liệu Amazon:
Nhược điểm:
- Không chuyên Amazon: Không có hệ thống endpoint Amazon chuyên biệt như một số đối thủ.
- Có thể cần tự xử lý dữ liệu: Bạn có thể phải tự phân tích nội dung trả về để lấy đúng trường dữ liệu cần thiết.
- Chi phí theo mức sử dụng: Chi phí tăng khi số lượng request và nhu cầu xử lý tăng.
ScrapingBee phù hợp với các dự án vừa và nhỏ cần một scraping API đơn giản, đặc biệt khi Amazon chỉ là một trong nhiều website cần thu thập dữ liệu.
5.7 So sánh nhanh các Amazon scraper tools
Sau khi xem từng lựa chọn, bảng dưới đây giúp bạn dễ so sánh hơn dựa trên khả năng cung cấp scraper Amazon, API, proxy và mức độ dễ triển khai.
| Tool | Amazon scraper có sẵn | API | Proxy | Dễ triển khai | Phù hợp |
|---|---|---|---|---|---|
| Bright Data | ✓ | ✓ | ✓ | Trung bình | Scale lớn |
| Oxylabs | ✓ | ✓ | ✓ | Trung bình | E-commerce |
| ScraperAPI | ✓ (structured endpoint riêng) | ✓ | ✓ | Dễ | Developer |
| Apify | ✓ (qua actor cộng đồng) | ✓ | Có | Dễ | No-code + API |
| Zyte | Tùy workflow (API + Scrapy Cloud) | ✓ | ✓ | Trung bình | Team kỹ thuật |
| ScrapingBee | Không chuyên Amazon | ✓ | ✓ | Dễ | Dự án vừa/nhỏ |
Nếu mục tiêu của bạn là xử lý Amazon ở quy mô lớn, Bright Data và Oxylabs có lợi thế về hạ tầng. ScraperAPI phù hợp hơn khi bạn muốn lấy dữ liệu theo cấu trúc có sẵn và tích hợp nhanh. Apify thuận tiện cho việc thử nghiệm với các công cụ có sẵn, còn Zyte sẽ phù hợp với nhóm đã quen làm việc với Scrapy. Với dự án cần một API thu thập dữ liệu cho nhiều website, ScrapingBee là lựa chọn đáng xem xét.
6. So sánh nhanh 4 phương pháp Amazon scraper
Bốn hướng tiếp cận chính có sự khác biệt khá rõ về chi phí, mức độ triển khai, khả năng xử lý giới hạn truy cập và quy mô phù hợp. Bạn có thể dựa vào bảng dưới đây để có lựa chọn ban đầu:
| Phương pháp | Chi phí | Độ khó triển khai | Khả năng vượt chặn | Độ ổn định lâu dài | Phù hợp quy mô nào |
|---|---|---|---|---|---|
| Tự viết script | Thấp | Cao | Thấp/Trung bình | Thấp (dễ hỏng khi HTML đổi) | Cá nhân, quy mô nhỏ |
| Headless browser | Thấp–Trung bình | Cao | Trung bình | Trung bình | Cần xử lý JS động |
| Kênh chính thức (Creators API) | Trung bình (điều kiện tham gia) | Thấp | Không cần vượt chặn (hợp lệ) | Cao (nếu đủ điều kiện duy trì) | Affiliate, dữ liệu hợp lệ dài hạn |
| Scraping API trả phí | Trung bình–Cao | Thấp | Cao | Cao | Doanh nghiệp, quy mô lớn |
Tự viết script có lợi thế về chi phí và khả năng tùy chỉnh, nhưng bạn phải tự xử lý phần lớn vấn đề liên quan đến request, thay đổi cấu trúc trang và bảo trì. Headless browser giải quyết tốt hơn các trang cần JavaScript, nhưng tiêu tốn nhiều tài nguyên hơn.
Creators API phù hợp với những trường hợp có thể sử dụng kênh dữ liệu chính thức của Amazon và cần một quy trình ổn định. Trong khi đó, scraping API trả phí phù hợp với dự án cần mở rộng nhanh mà không muốn tự xây dựng toàn bộ hệ thống thu thập dữ liệu.
7. Vì sao việc scrape dữ liệu Amazon lại khó hơn nhiều trang khác?
Amazon có lượng dữ liệu sản phẩm rất lớn nhưng cũng áp dụng nhiều cơ chế để kiểm soát các truy cập tự động. Vì vậy, việc gửi request liên tục đến Amazon không đơn giản như lấy dữ liệu từ một trang web có cấu trúc tĩnh. Khi số lượng request tăng, hệ thống có thể nhận diện những dấu hiệu bất thường và yêu cầu xác minh thêm.
Một số vấn đề thường gặp khi triển khai Amazon scraper gồm:
- Giới hạn tần suất truy cập: Gửi quá nhiều request trong thời gian ngắn có thể khiến request bị giới hạn hoặc tạm thời không nhận được nội dung như mong muốn.
- CAPTCHA và các bước kiểm tra truy cập: Khi phát hiện hành vi đáng ngờ, Amazon có thể yêu cầu CAPTCHA hoặc hiển thị bước kiểm tra trước khi cho phép tiếp tục truy cập.
- Cấu trúc trang thay đổi: HTML và cách tổ chức dữ liệu trên trang có thể thay đổi. Với scraper tự viết, những thay đổi này có thể khiến bộ chọn phần tử không còn hoạt động và cần được cập nhật.
- Nội dung được tải bằng JavaScript: Một số dữ liệu không xuất hiện đầy đủ trong HTML ban đầu mà được tải trong quá trình trình duyệt hoạt động. Đây là lý do headless browser thường được dùng khi Requests không lấy đủ dữ liệu.
- Phiên truy cập và cookie: Quy trình thu thập dữ liệu có thể cần duy trì phiên truy cập, cookie và các thông tin liên quan. Với những workflow sử dụng trình duyệt tự động, còn phải quan tâm đến các dấu hiệu tự động hóa và dấu vân tay trình duyệt.
- Khó mở rộng khi lượng dữ liệu tăng: Thu thập vài chục sản phẩm khác với việc xử lý hàng nghìn hoặc hàng triệu trang. Khi quy mô tăng, bạn phải tính thêm về proxy, tốc độ request, xử lý lỗi, lưu trữ và khả năng phân phối tác vụ.
Những yếu tố này cũng giải thích vì sao mỗi phương pháp ở phần trên có giới hạn riêng. Script Requests phù hợp với nhu cầu đơn giản nhưng cần tự xử lý nhiều vấn đề kỹ thuật. Headless browser linh hoạt hơn với nội dung động nhưng tốn tài nguyên. Trong khi đó, API chính thức hoặc scraping API trả phí có thể giảm bớt một phần công việc vận hành, tùy vào phạm vi dữ liệu và điều kiện sử dụng.
8. Mẹo thực hành an toàn khi scrape Amazon
Một Amazon scraper hoạt động ổn định không chỉ phụ thuộc vào cách lấy dữ liệu. Cách gửi request, quản lý phiên truy cập và xử lý lỗi cũng ảnh hưởng trực tiếp đến độ bền của quy trình. Một số lưu ý dưới đây có thể giúp bạn giảm các vấn đề phát sinh trong quá trình vận hành:
- Kiểm soát tần suất request: Tránh gửi quá nhiều request trong thời gian ngắn. Bạn có thể điều chỉnh tốc độ thu thập theo khối lượng dữ liệu và khả năng xử lý của hệ thống.
- Chọn proxy phù hợp: Proxy nên được lựa chọn dựa trên quy mô và cách triển khai. Với workflow cần nhiều request hoặc nhiều khu vực truy cập, chất lượng và khả năng quản lý proxy sẽ ảnh hưởng đáng kể đến độ ổn định.
- Quản lý session và cookie: Các thông tin như session, cookie và trạng thái trình duyệt cần được quản lý nhất quán. Khi sử dụng nhiều workflow, việc tách riêng các phiên truy cập cũng giúp hạn chế tình trạng dữ liệu hoặc trạng thái bị dùng nhầm giữa các tác vụ.
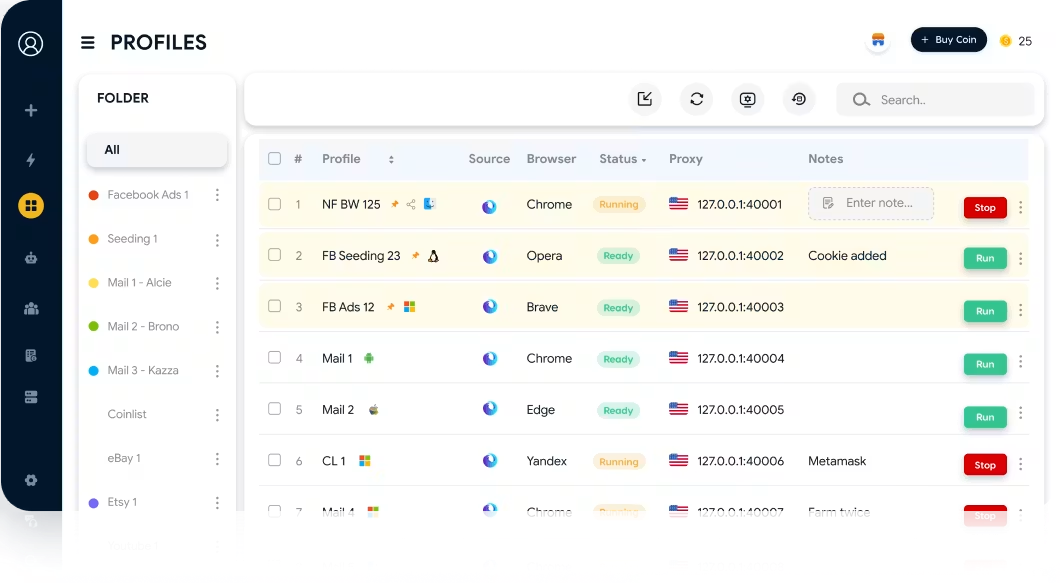
- Tách biệt browser profile khi cần: Với workflow sử dụng nhiều môi trường trình duyệt, bạn có thể dùng antidetect browser Hidemyacc để tạo và quản lý các profile riêng biệt. Cách này đặc biệt hữu ích khi mỗi tác vụ cần một môi trường trình duyệt, session hoặc cấu hình proxy riêng.
- Chuẩn bị cơ chế retry và xử lý lỗi: Request có thể thất bại do timeout, lỗi kết nối hoặc phản hồi không đầy đủ. Scraper nên có cơ chế thử lại hợp lý và ghi nhận lỗi để tránh làm gián đoạn toàn bộ quá trình.
- Kiểm tra điều khoản và chính sách liên quan: Trước khi thu thập dữ liệu, hãy xem điều khoản sử dụng của Amazon, chính sách API và các quy định pháp luật có liên quan đến loại dữ liệu cũng như mục đích sử dụng của bạn.
Những bước này giúp quy trình thu thập dữ liệu dễ kiểm soát hơn, đặc biệt khi scraper phải xử lý nhiều sản phẩm hoặc nhiều môi trường trình duyệt cùng lúc.
Tìm hiểu thêm về proxy:
- Nhà cung cấp proxy tốt nhất cho Amazon: Tăng doanh số với nhiều tài khoản
- Mobile Proxy - Khám phá tính năng, lợi ích và cách sử dụng
- Proxy dân cư- Cách thức hoạt động và lý do bạn nên sử dụng nó
- Proxy Datacenter là gì? Tất tần tật về Proxy Datacenter
- Proxy dân cư và Proxy datacenter: Phân biệt và cách chọn loại proxy phù hợp
9. Sai lầm thường gặp khi triển khai Amazon scraper
Không ít scraper gặp vấn đề không phải vì cách lấy dữ liệu sai, mà do quy trình được xây dựng thiếu tính ổn định ngay từ đầu. Một số sai lầm dưới đây khá phổ biến khi thu thập dữ liệu Amazon:
- Chọn scraper chỉ vì dễ triển khai: Một đoạn script ngắn hoặc công cụ có sẵn có thể đáp ứng nhu cầu thử nghiệm, nhưng chưa chắc phù hợp khi lượng dữ liệu tăng. Bạn nên xác định trước quy mô và loại dữ liệu cần thu thập để chọn cách triển khai tương ứng.
- Dùng một phương pháp cho mọi loại dữ liệu: Dữ liệu sản phẩm, kết quả tìm kiếm, đánh giá hay thông tin người bán có thể yêu cầu cách xử lý khác nhau. Một scraper hoạt động tốt với trang sản phẩm chưa chắc lấy được đầy đủ dữ liệu từ các trang khác.
- Phụ thuộc vào cấu trúc HTML cố định: Việc xây scraper dựa quá nhiều vào một số bộ chọn HTML cụ thể khiến hệ thống dễ gặp lỗi khi giao diện hoặc cấu trúc trang thay đổi. Đây là vấn đề đặc biệt đáng chú ý với scraper tự viết.
- Không tính đến khả năng mở rộng: Một quy trình chạy tốt với vài chục sản phẩm có thể trở nên chậm và khó quản lý khi phải xử lý hàng nghìn trang. Quy mô dữ liệu nên được tính đến từ đầu để tránh phải xây dựng lại hệ thống sau này.
- Đánh giá thấp chi phí bảo trì: Scraper không phải hệ thống xây xong là có thể sử dụng lâu dài mà không cần cập nhật. Thay đổi từ Amazon, lỗi phát sinh và nhu cầu dữ liệu mới đều có thể kéo theo công việc bảo trì.
- Chọn scraping API chỉ dựa trên mức giá: Giá mỗi request hoặc gói dịch vụ chỉ là một phần của bài toán. Bạn cũng cần xem API hỗ trợ loại dữ liệu nào, định dạng đầu ra, giới hạn sử dụng và khả năng đáp ứng khi khối lượng thu thập tăng.
Một lựa chọn phù hợp ngay từ đầu sẽ giúp bạn tránh nhiều công việc sửa đổi và chi phí phát sinh khi scraper mở rộng. Từ đây, bạn có thể cân nhắc phương pháp dựa trên quy mô, dữ liệu cần lấy và nguồn lực kỹ thuật của mình.
10. Kết luận
Không có một phương pháp Amazon scraper nào phù hợp cho mọi nhu cầu. Với dự án nhỏ và có khả năng lập trình, tự viết script có thể giúp bạn chủ động về dữ liệu và chi phí. Headless browser phù hợp hơn khi cần xử lý nội dung động hoặc thao tác trực tiếp với trình duyệt. Trong khi đó, Creators API và các scraping API trả phí đáng cân nhắc khi ưu tiên tính ổn định hoặc cần mở rộng quy mô.
Với những workflow cần quản lý nhiều môi trường trình duyệt riêng, việc kết hợp scraper với browser profile cũng có thể giúp quy trình dễ tổ chức hơn. Chẳng hạn, antidetect browser Hidemyacc có thể được sử dụng để tạo và quản lý các profile độc lập, kết hợp với proxy và công cụ automation khi cần.
Trước khi triển khai, bạn cũng nên xác định rõ loại dữ liệu cần thu thập, quy mô dự án và cách sử dụng dữ liệu. Đồng thời, hãy kiểm tra điều khoản của Amazon, chính sách API và các quy định liên quan để lựa chọn phương án phù hợp.
Bài viết liên quan:
- Làm sao để mở rộng tài khoản Seller Amazon hiệu quả ?
- Tại sao tài khoản Amazon của bạn bị khóa? 3 mẹo để mở khóa tài khoản Amazon
- Địa chỉ mua tài khoản Amazon uy tín và giao dịch an toàn
11. FAQ
1. Amazon scraper có hợp pháp không?
Việc scrape Amazon có hợp pháp hay không còn phụ thuộc vào mục đích, cách thu thập và cách sử dụng dữ liệu. Bạn nên kiểm tra điều khoản dịch vụ của Amazon, chính sách API và các quy định pháp luật liên quan trước khi triển khai.
2. Scrape Amazon bằng Python có khó không?
Nếu chỉ lấy một số dữ liệu cơ bản, bạn có thể bắt đầu với Requests và BeautifulSoup mà không cần quá nhiều code. Tuy nhiên, khi tăng quy mô, việc xử lý CAPTCHA, giới hạn truy cập, proxy và thay đổi cấu trúc trang sẽ khiến scraper phức tạp hơn.
3. Làm sao biết mình đang bị Amazon chặn scraping?
Một số dấu hiệu thường gặp là xuất hiện CAPTCHA, lỗi truy cập, phản hồi 403 hoặc nội dung trang không trả về như bình thường. Nếu các request liên tục thất bại dù URL vẫn hoạt động trên trình duyệt, scraper có thể đang bị hạn chế truy cập.
4. Có nên dùng proxy miễn phí để scrape Amazon không?
Không nên dùng proxy miễn phí cho các workflow scraping cần độ ổn định. Các proxy này thường có tốc độ, độ tin cậy và chất lượng IP không ổn định, dễ khiến request thất bại hoặc bị giới hạn.
5. Scrape dữ liệu Amazon có cần dùng anti-detect browser không?
Không phải trường hợp nào cũng cần anti-detect browser. Với nhu cầu nhỏ hoặc workflow dùng API, proxy hoặc request trực tiếp có thể phù hợp hơn; anti-detect browser chỉ nên cân nhắc khi cần quản lý nhiều browser profile hoặc workflow có yêu cầu riêng về fingerprint.