Bạn muốn lấy giá, tag, review hay số lượng đã bán của hàng nghìn listing Etsy để nghiên cứu sản phẩm, nhưng copy thủ công thì quá chậm? Cào dữ liệu Etsy giúp bạn tự động hóa việc này, tuy nhiên mỗi cách làm lại đi kèm giới hạn riêng về kỹ thuật và nguy cơ bị chặn. Bài viết so sánh 5 phương pháp phổ biến, từ API chính thức, công cụ không cần code, Python, trình duyệt tự động cho đến dịch vụ scraping API, để bạn chọn cách phù hợp với quy mô của mình.
1. Cào dữ liệu Etsy là gì và có thể thu thập những dữ liệu nào?
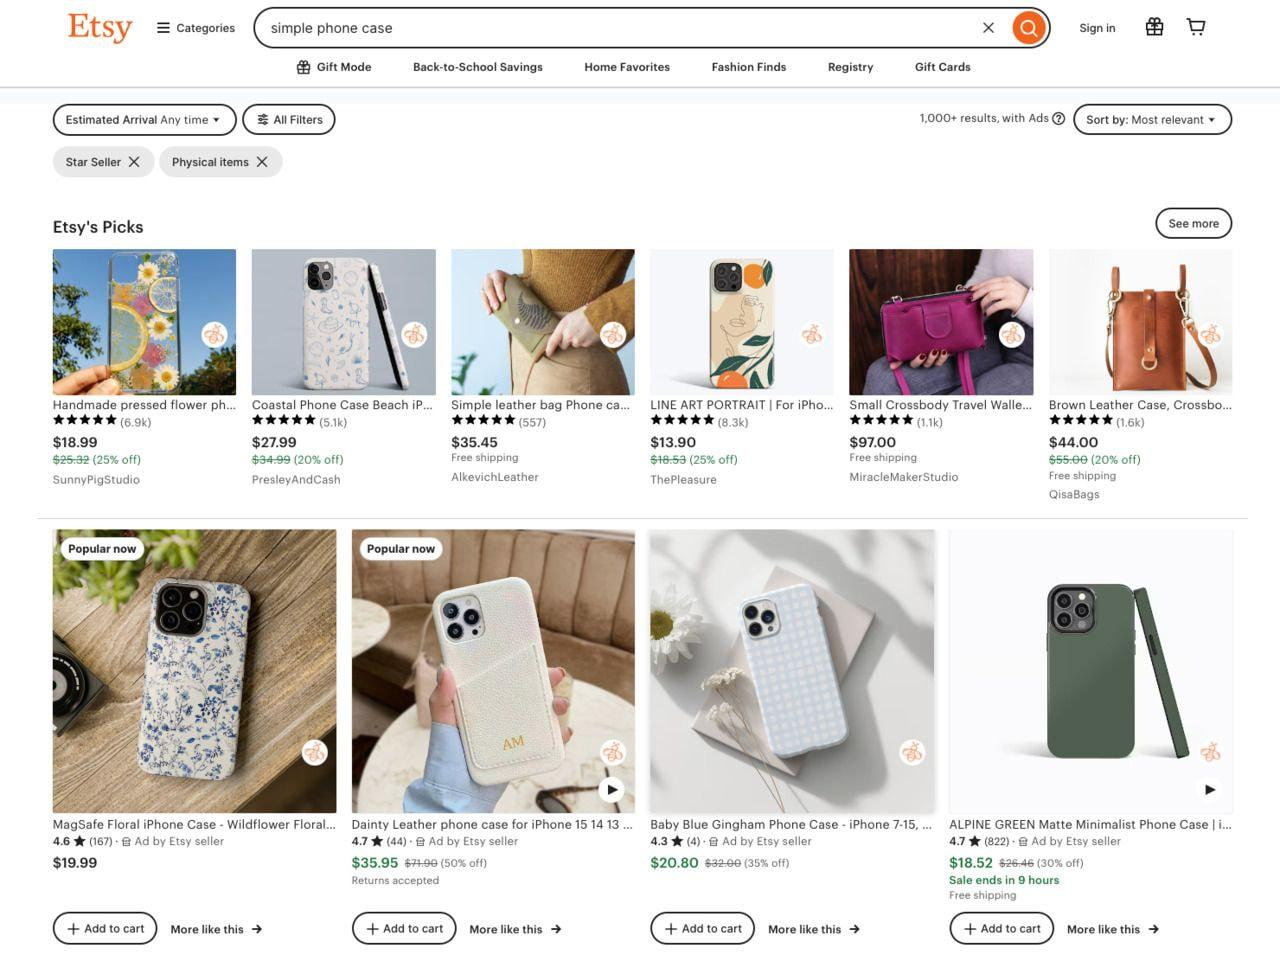
Cào dữ liệu Etsy là quá trình thu thập dữ liệu công khai từ các trang trên Etsy bằng công cụ hoặc script thay vì sao chép thủ công. Với cách này, bạn có thể lấy nhiều thông tin từ listing, shop hoặc trang tìm kiếm và đưa về một file để tiếp tục phân tích.
Những dữ liệu có thể thu thập từ Etsy
Tùy công cụ và phương pháp, dữ liệu lấy được sẽ khác nhau. Các nhóm thông tin phổ biến gồm:
- Dữ liệu sản phẩm: Tên sản phẩm, URL, hình ảnh, mô tả, danh mục và tag.
- Dữ liệu giá: Giá bán, giá khuyến mãi và đơn vị tiền tệ.
- Dữ liệu đánh giá: Số lượng review, điểm đánh giá và nội dung review công khai. Một số review có thể hiển thị tên người mua hoặc thông tin liên quan đến tài khoản. Đây là dữ liệu cần lưu ý về quyền riêng tư và sẽ được đề cập ở phần pháp lý.
- Dữ liệu cửa hàng: Tên shop, số lượng sản phẩm và những thông tin được hiển thị trên trang shop.
- Dữ liệu tìm kiếm và thứ hạng: Kết quả theo từ khóa, danh mục, bộ lọc và vị trí sản phẩm trong kết quả.
Cào dữ liệu Etsy dùng để làm gì?
Dữ liệu Etsy thường được dùng để:
- Nghiên cứu ngách và sản phẩm: tìm sản phẩm, tag và xu hướng trong một ngách.
- Theo dõi giá và phân tích đối thủ: so sánh giá, sản phẩm và hoạt động của các shop.
- Tối ưu listing: phân tích tiêu đề, tag và các yếu tố thường xuất hiện ở sản phẩm có hiệu suất tốt.
- Theo dõi xu hướng và review: thu thập dữ liệu định kỳ để so sánh thay đổi theo thời gian.
Những nhu cầu khác nhau sẽ đòi hỏi cách thu thập dữ liệu khác nhau. Tùy vào lượng dữ liệu cần lấy và mức độ kiểm soát mong muốn, bạn có thể lựa chọn phương pháp phù hợp ở các phần tiếp theo.
Tìm hiểu thêm: Web Scraping 101: Cách thức hoạt động và Ứng dụng thực tế
2. Cào dữ liệu Etsy bằng API chính thức
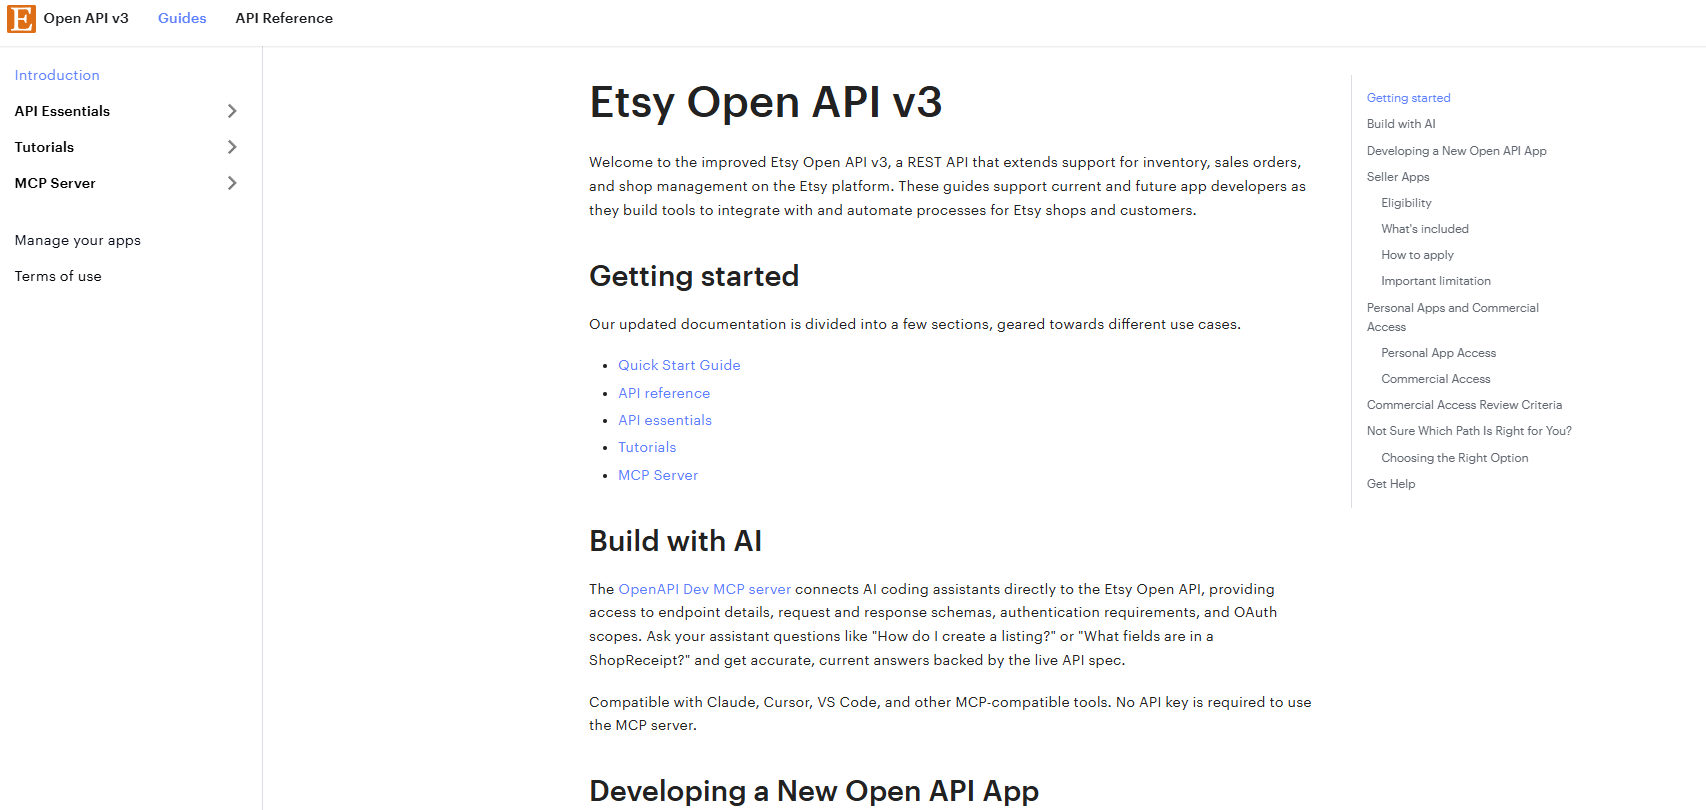
Etsy Open API v3 là kênh chính thức để ứng dụng kết nối với Etsy và lấy dữ liệu theo các endpoint được cung cấp. Thay vì tự truy cập từng trang Etsy, bạn gửi yêu cầu đến API và nhận dữ liệu trong phạm vi quyền truy cập của ứng dụng.
Có thể hình dung API như một kênh trung gian giữa ứng dụng của bạn và Etsy. Bạn gửi yêu cầu về loại dữ liệu cần lấy, còn API trả về dữ liệu trong phạm vi endpoint và quyền truy cập được phép.
Dữ liệu có thể lấy
Etsy API có thể cung cấp dữ liệu listing, shop và các thông tin liên quan tùy theo endpoint và quyền truy cập của ứng dụng. Phạm vi dữ liệu thực tế phụ thuộc vào API hiện hành, loại ứng dụng và điều kiện sử dụng của Etsy.
Ưu điểm
- Dữ liệu có cấu trúc, thuận tiện cho việc xử lý.
- Ít rủi ro bị chặn hơn so với việc gửi request trực tiếp đến website.
- Là kênh chính thức do Etsy cung cấp.
Nhược điểm
- Cần đăng ký ứng dụng và thiết lập quyền truy cập phù hợp.
- API có giới hạn số truy vấn theo ứng dụng, gồm giới hạn theo ngày và theo giây ở cấp API key.
- Nếu cần hạn mức cao hơn, bạn phải gửi yêu cầu nâng quota cho Etsy.
- Không phải dữ liệu nào hiển thị trên website cũng có thể lấy theo cùng một cách qua API.
Phù hợp với ai?
API Etsy phù hợp với seller quản lý shop của mình hoặc đội ngũ cần thu thập dữ liệu ổn định và theo hướng tuân thủ. Nếu nhu cầu chỉ là lấy một lượng nhỏ dữ liệu để nghiên cứu sản phẩm, các công cụ không cần code có thể đơn giản hơn.
Với những dự án cần kiểm soát dữ liệu nhưng không muốn tự xây dựng hệ thống API, công cụ cào dữ liệu không cần code là một lựa chọn khác đáng cân nhắc.
3. Công cụ cào dữ liệu Etsy không cần code
Không phải ai cũng cần tự viết Python để lấy dữ liệu Etsy. Với nhu cầu nghiên cứu sản phẩm, theo dõi đối thủ hoặc lấy review của một số listing, các công cụ có sẵn sẽ giúp bạn bắt đầu nhanh hơn. Thông thường, bạn chỉ cần nhập từ khóa hoặc URL Etsy, chọn dữ liệu cần lấy và xuất kết quả.
3.1 Apify
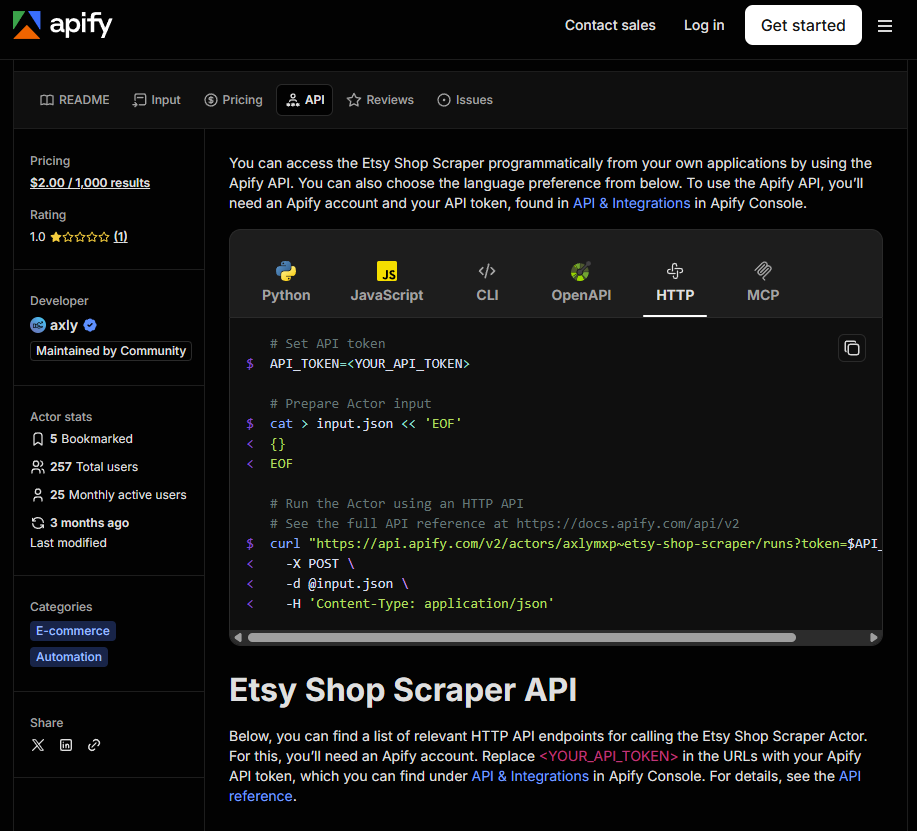
Apify có nhiều công cụ cào dữ liệu Etsy được xây dựng cho những nhu cầu khác nhau. Bạn có thể tìm công cụ lấy dữ liệu theo từ khóa, shop, listing hoặc review thay vì phải tự xây scraper từ đầu.
Một số công cụ hỗ trợ phân trang, lọc và sắp xếp kết quả. Có công cụ dùng Etsy Open API v3, trong khi những công cụ khác thu thập dữ liệu trực tiếp từ trang Etsy và có thêm tùy chọn proxy.
Ưu điểm
- Không cần tự viết scraper.
- Có nhiều công cụ để lựa chọn tùy loại dữ liệu.
- Một số công cụ hỗ trợ proxy, lọc dữ liệu và phân trang.
- Có thể xuất dữ liệu sang JSON, CSV hoặc Excel.
Hạn chế
- Các công cụ trên nền tảng được xây dựng bởi nhiều nhà phát triển khác nhau nên chất lượng và dữ liệu trả về không giống nhau.
- Thay đổi trên Etsy có thể ảnh hưởng đến cách scraper hoạt động.
- Một số công cụ chỉ lấy được dữ liệu tìm kiếm hoặc một loại dữ liệu nhất định.
- Dữ liệu review có thể chứa thông tin liên quan đến người dùng nên cần kiểm tra trước khi sử dụng.
Phù hợp với ai?
Apify phù hợp khi bạn muốn thử nghiệm cào dữ liệu Etsy mà không muốn tự xây dựng hệ thống. Seller hoặc người nghiên cứu sản phẩm có thể chọn scraper theo đúng loại dữ liệu mình cần, sau đó mở rộng quy mô khi quy trình đã ổn định.
3.2 Web Scraper
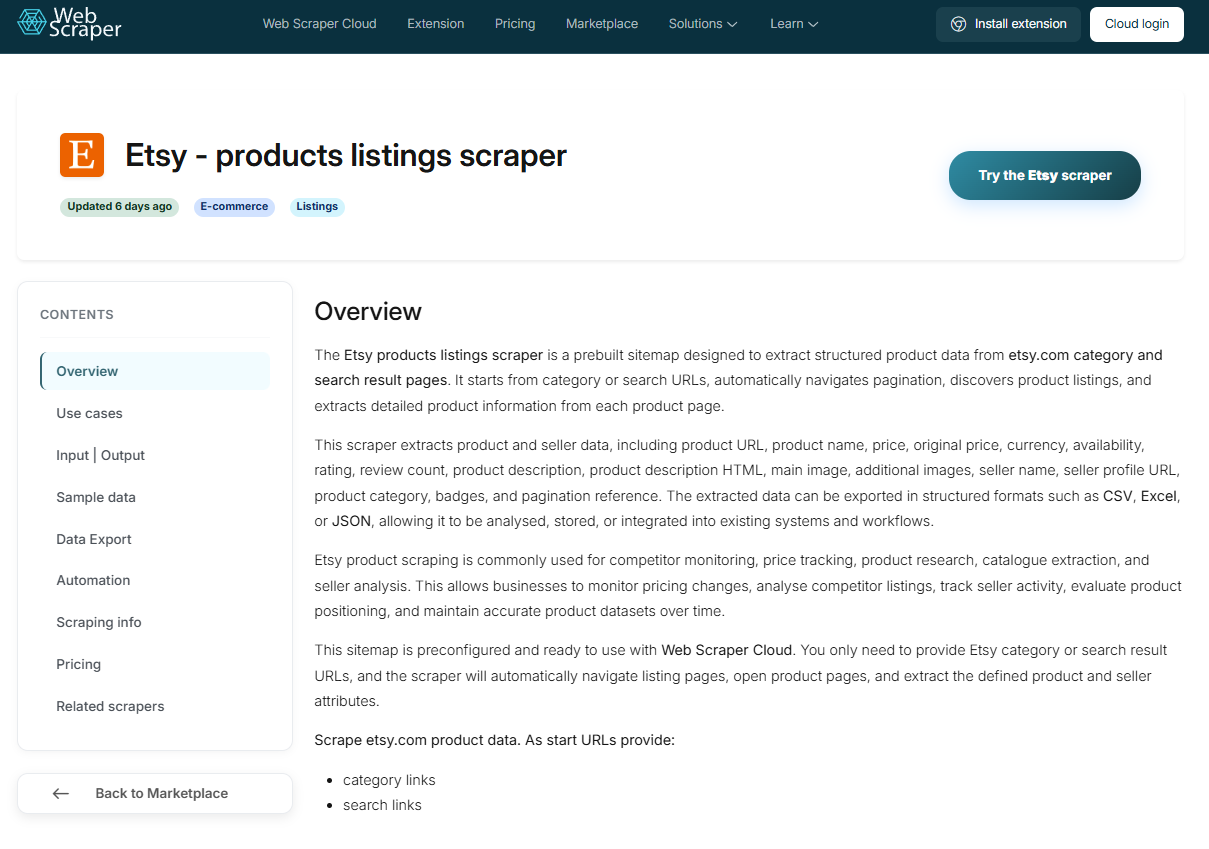
Web Scraper có mẫu scraper dành cho Etsy Marketplace, cho phép thu thập dữ liệu sản phẩm thông qua giao diện thay vì viết code. Bạn thiết lập sitemap, nhập trang danh mục hoặc trang tìm kiếm rồi xác định cách công cụ di chuyển qua các trang.
Dữ liệu có thể gồm tên sản phẩm, URL, giá, giá gốc, tiền tệ, tình trạng hàng, điểm đánh giá, số review, mô tả, hình ảnh, seller, shop và danh mục.
Ưu điểm
- Giao diện trực quan, không cần lập trình.
- Có sẵn các trường dữ liệu phổ biến của sản phẩm.
- Hỗ trợ xuất dữ liệu sang CSV, Excel và JSON.
- Có thể lấy thêm thông tin liên quan đến seller và shop.
Hạn chế
- Khả năng tùy chỉnh không linh hoạt bằng scraper tự viết.
- Bạn cần thiết lập sitemap theo cấu trúc trang muốn thu thập.
- Một số trang Etsy sử dụng JavaScript và cơ chế chống bot nên cần kiểm tra khả năng hoạt động trước khi chạy số lượng lớn.
Phù hợp với ai?
Đây là lựa chọn phù hợp nếu bạn cần thu thập các trường dữ liệu sản phẩm phổ biến và muốn thao tác bằng giao diện thay vì code. Với những dự án cần xử lý logic riêng hoặc thay đổi cách lấy dữ liệu thường xuyên, Python sẽ linh hoạt hơn.
3.3 Etsy Reviews Extractor (tiện ích Chrome)
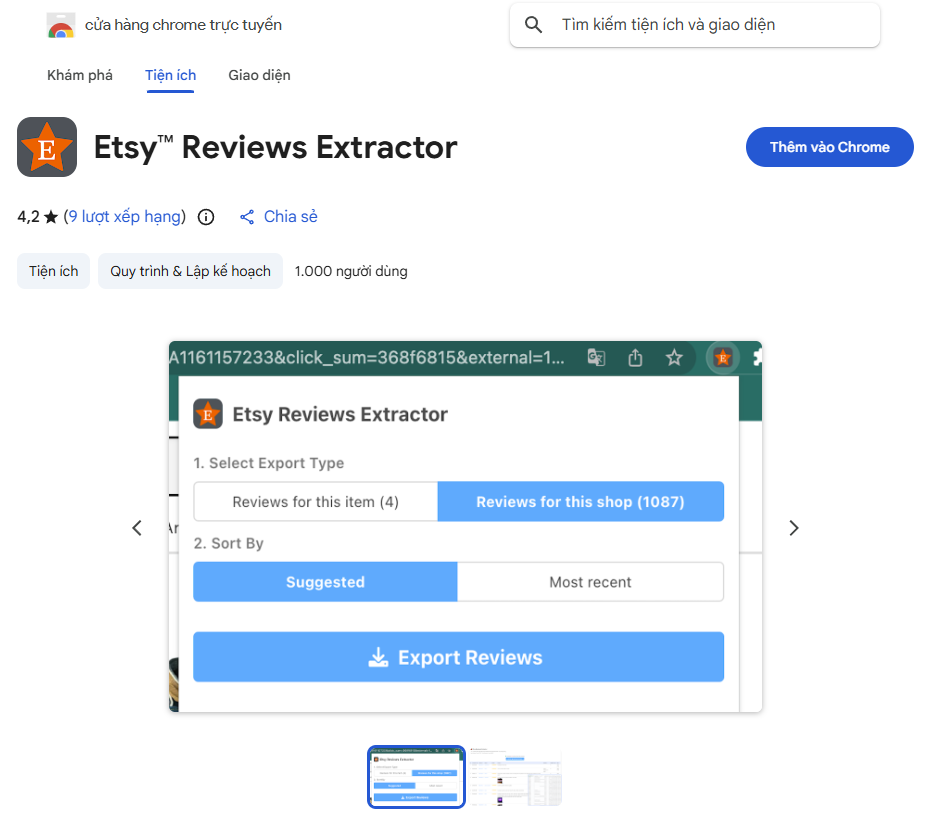
Etsy Reviews Extractor là tiện ích Chrome tập trung vào việc thu thập review từ từng listing. Thay vì xây scraper cho toàn bộ Etsy, bạn có thể dùng công cụ này khi mục tiêu chính là đọc và tổng hợp đánh giá của khách hàng.
Dữ liệu có thể gồm tên người dùng, điểm đánh giá, nội dung review, hình ảnh, ngày đánh giá và một số thông tin liên quan. Kết quả có thể được xuất thành CSV, JSON hoặc XLSX.
Ưu điểm
- Cách sử dụng đơn giản.
- Tập trung vào dữ liệu review.
- Có tính năng tóm tắt review bằng AI.
- Hỗ trợ nhiều định dạng xuất dữ liệu.
Hạn chế
- Phù hợp với từng sản phẩm hơn là thu thập hàng loạt listing.
- Không thích hợp cho nhu cầu quét nhiều danh mục hoặc kết quả tìm kiếm.
- Review có thể chứa thông tin cá nhân nên cần cân nhắc cách sử dụng dữ liệu.
Phù hợp với ai?
Công cụ này phù hợp khi bạn muốn đọc và tổng hợp review của một số sản phẩm để tìm hiểu nhu cầu khách hàng. Nếu cần thu thập hàng trăm hoặc hàng nghìn listing cùng lúc, bạn nên cân nhắc phương pháp khác.
3.4 EtsyHunt và EtsyRank (công cụ nghiên cứu, không phải scraper)
Không phải lúc nào nghiên cứu Etsy cũng cần đến scraper. EtsyHunt và EtsyRank tập trung vào nghiên cứu sản phẩm, từ khóa và xu hướng, nên có thể đáp ứng một phần nhu cầu mà không cần bạn tự thu thập dữ liệu.
EtsyHunt phù hợp hơn với việc theo dõi sản phẩm và hiệu suất sản phẩm. EtsyRank tập trung vào từ khóa và xu hướng tìm kiếm để hỗ trợ tối ưu listing.
Nếu mục tiêu chỉ là tìm sản phẩm tiềm năng hoặc nghiên cứu từ khóa, các công cụ này có thể giúp bạn tiết kiệm bước thu thập dữ liệu thủ công. Khi cần dữ liệu thô để tự phân tích hoặc xây dựng hệ thống riêng, scraper sẽ phù hợp hơn.
Đọc thêm: Tự động hóa trên Etsy: 15 công cụ tốt nhất bạn nên thử
4. Cào dữ liệu Etsy bằng Python (Requests và BeautifulSoup)
Khi cần tự kiểm soát cách lấy và xử lý dữ liệu, Python là lựa chọn linh hoạt hơn các công cụ có sẵn. Với Requests và BeautifulSoup, bạn có thể bắt đầu từ một vài listing, lấy những trường cần thiết rồi lưu kết quả để phân tích.
Quy trình thực hiện
Trước tiên, bạn xác định URL và những trường dữ liệu cần thu thập như tên sản phẩm, giá, mô tả hoặc thông tin đánh giá. Sau đó, Requests gửi yêu cầu đến trang Etsy, còn BeautifulSoup giúp đọc HTML và tìm phần dữ liệu cần lấy.
Một số thông tin sản phẩm có thể được nhúng sẵn trong HTML dưới dạng JSON. Khi đó, bạn có thể đọc phần dữ liệu này thay vì phải xử lý toàn bộ giao diện trang.
Đoạn code dưới đây minh họa cách gửi request đến một listing và đọc dữ liệu sản phẩm từ phần JSON được nhúng trong trang:
import json

import requests

from bs4 import BeautifulSoup

url = "https://www.etsy.com/listing/LISTING_ID"

headers = {"User-Agent": "Mozilla/5.0"}

response = requests.get(url, headers=headers, timeout=10)

soup = BeautifulSoup(response.text, "html.parser")

# Tìm thẻ script chứa dữ liệu sản phẩm dạng JSON
tag = soup.find("script", string=lambda s: s and '"offers"' in s)

data = json.loads(tag.string) if tag else {}

print("Tên:", data.get("name", "N/A"))

print("Giá:", data.get("offers", {}).get("price", "N/A"))
Lưu ý khi sử dụng request thuần: Etsy có thể trả lỗi 403 hoặc CAPTCHA khi nhận request tự động. Nên thử với trang listing trước, vì một số trang có sẵn dữ liệu JSON trong HTML, còn trang tìm kiếm có thể cần JavaScript. Khi mở rộng, cần xử lý thêm phân trang và các trường dữ liệu có thể bị trống.
Ưu điểm
- Chủ động chọn dữ liệu và cách xử lý.
- Có thể tùy chỉnh quy trình theo từng dự án.
- Dễ kết hợp với các thư viện Python khác để làm sạch và phân tích dữ liệu.
Hạn chế
- Cần biết Python và cách xử lý HTML.
- Etsy có thể trả về 403 hoặc CAPTCHA khi phát hiện hoạt động tự động.
- Cấu trúc trang thay đổi có thể khiến bộ chọn dữ liệu không còn hoạt động.
- Việc xử lý phân trang và các trường dữ liệu bị thiếu cần được tính đến khi viết script.
Phù hợp với ai?
Python phù hợp với người có kiến thức lập trình và cần kiểm soát nhiều hơn đối với quá trình cào dữ liệu Etsy. Với một dự án nhỏ, bạn có thể bắt đầu từ vài listing, kiểm tra dữ liệu rồi mới bổ sung phân trang và các bước xử lý khác.
5. Cào dữ liệu Etsy bằng trình duyệt tự động
Khi request thuần không lấy được dữ liệu hoặc trang cần JavaScript để hiển thị nội dung, bạn có thể chuyển sang trình duyệt tự động. Ba lựa chọn thường gặp là Playwright, Selenium và Puppeteer. Các công cụ này mô phỏng quá trình mở và tương tác với trình duyệt nên phù hợp hơn với những trang có nội dung tải động.
Playwright, Selenium và Puppeteer
Ba công cụ này có cách triển khai khác nhau nhưng đều hoạt động dựa trên trình duyệt. Bạn có thể tự động mở trang Etsy, chờ các thành phần cần thiết xuất hiện rồi lấy dữ liệu thay vì chỉ gửi request đến máy chủ.
- Playwright: hỗ trợ nhiều trình duyệt và có cơ chế chờ nội dung tải, phù hợp với các trang có nhiều thành phần động.
- Selenium: đã được sử dụng lâu trong tự động hóa trình duyệt và hỗ trợ nhiều ngôn ngữ lập trình.
- Puppeteer: tập trung vào Chrome và phù hợp với các dự án sử dụng Node.js.
Ưu điểm
- Có thể xử lý nội dung được tải bằng JavaScript.
- Thao tác gần với cách người dùng mở và sử dụng trình duyệt hơn request thuần.
- Có thể kết hợp với proxy, cookie và nhiều phiên trình duyệt để phục vụ các quy trình thu thập dữ liệu khác nhau.
Hạn chế
- Tốn RAM và CPU hơn so với request thuần.
- Tốc độ thu thập thường chậm hơn.
- Việc tự động hóa trình duyệt vẫn có thể bị hệ thống chống bot phát hiện.
- Khi chạy nhiều phiên cùng lúc, bạn cần quản lý tài nguyên và môi trường trình duyệt cẩn thận.
Khi cần chạy nhiều phiên song song, việc tách riêng môi trường cho từng phiên cũng đáng được quan tâm. IP, cookie và browser fingerprint nên được quản lý nhất quán để tránh việc nhiều phiên dùng chung một môi trường nhưng lại có hành vi khác nhau.
Kết hợp với antidetect browser Hidemyacc
Khi cào dữ liệu Etsy ở quy mô lớn, vấn đề không chỉ nằm ở việc lấy HTML hay xử lý JavaScript. Nếu chạy nhiều phiên trên cùng một môi trường trình duyệt, cookie, fingerprint và IP cũng cần được quản lý riêng. Đây là phần mà antidetect browser Hidemyacc có thể hỗ trợ.
Hidemyacc cho phép bạn tạo nhiều profile trình duyệt độc lập, mỗi profile có thể gắn với fingerprint, cookie và proxy riêng. Nhờ vậy, bạn có thể tách các phiên thu thập dữ liệu thay vì chạy tất cả trong cùng một môi trường.
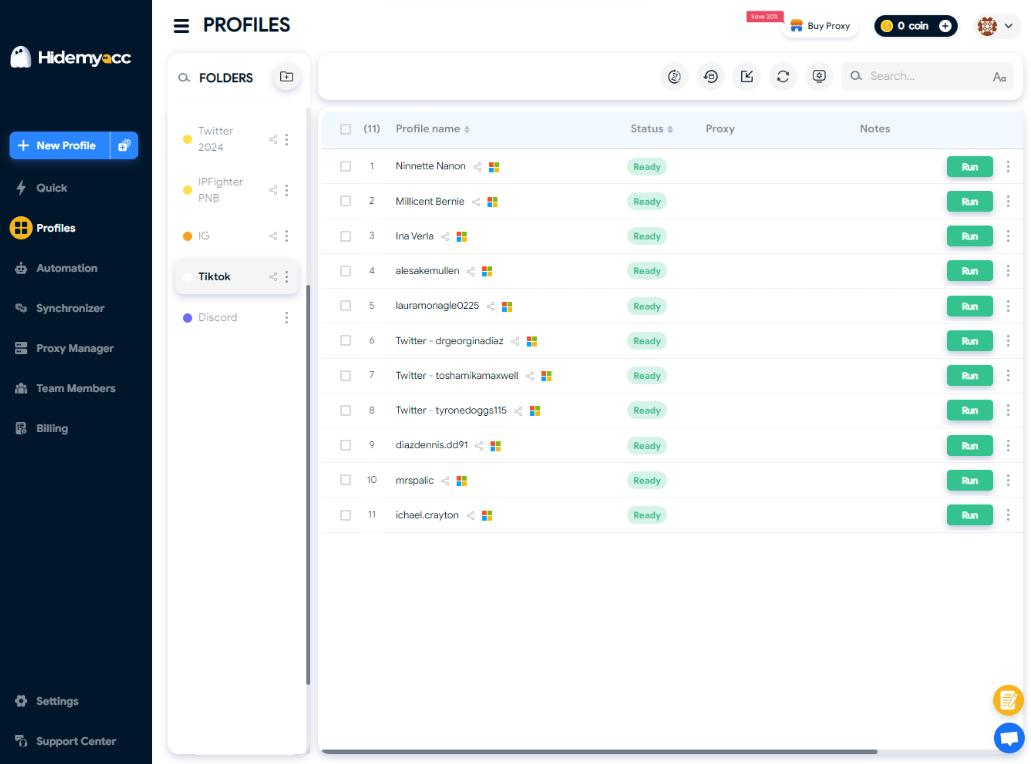
Giao diện quản lý các profile trình duyệt trên Hidemyacc.
Một quy trình cào dữ liệu Etsy có thể triển khai như sau:
- Tạo profile: Tạo các profile riêng cho từng phiên thu thập dữ liệu.
- Thiết lập proxy: Gắn proxy phù hợp cho từng profile nếu cần phân tách IP.
- Kết nối công cụ tự động hóa: Sử dụng Playwright hoặc Puppeteer để điều khiển profile và truy cập các trang Etsy.
- Thu thập dữ liệu: Chạy script để lấy listing, giá, tag hoặc các trường dữ liệu cần thiết.
- Kiểm tra trước khi mở rộng: Chạy thử với số lượng nhỏ, theo dõi phản hồi từ Etsy rồi mới tăng quy mô.
Điểm đáng chú ý là Hidemyacc không thay thế scraper. Playwright hoặc Puppeteer vẫn đảm nhiệm việc mở trang và lấy dữ liệu, còn Hidemyacc cung cấp môi trường trình duyệt riêng để quản lý các phiên thu thập. Cách kết hợp này phù hợp hơn khi bạn cần chạy nhiều profile hoặc nhiều quy trình cào dữ liệu song song.
Tuy nhiên, antidetect browser không đồng nghĩa với việc mọi request đều tránh được cơ chế chống bot. Bạn vẫn cần kiểm soát proxy, tần suất truy cập, hành vi tự động và quy mô thu thập dữ liệu trong quá trình chạy.
Có thể bạn quan tâm:
- Antidetect browser là gì? Tại sao mạnh hơn VPN & proxy
- Antidetect browser cho web scraping: Top công cụ 2026
6. Dịch vụ scraping API trả phí
Khi dữ liệu cần lấy nhiều và việc tự xử lý proxy, JavaScript hoặc CAPTCHA bắt đầu trở nên phức tạp, bạn có thể dùng scraping API. Thay vì tự xây toàn bộ hệ thống từ đầu, bạn gửi URL hoặc từ khóa cho dịch vụ, còn phần thu thập dữ liệu được xử lý ở phía máy chủ.
6.1 Bright Data
Bright Data có ba scraper API riêng cho Etsy: lấy dữ liệu theo URL sản phẩm, theo từ khóa và theo URL shop. Dữ liệu trả về gồm tên sản phẩm, giá, shop, thông số, biến thể, chính sách vận chuyển và đổi trả, rating cùng một số review nổi bật. Ngoài API còn có dataset Etsy dựng sẵn.
Ưu điểm
- Ba chế độ phủ cả sản phẩm, từ khóa và shop.
- Dữ liệu có cấu trúc, ít phải tự viết bộ tách.
- Có dataset dựng sẵn cho ai không muốn tự chạy scraper.
Hạn chế
- Cần có kiến thức cơ bản về API và xử lý dữ liệu.
- Phụ thuộc vào dịch vụ bên ngoài.
- Có thể không cần thiết nếu bạn chỉ thu thập một lượng nhỏ dữ liệu.
Phù hợp với ai?
Bright Data phù hợp với các dự án cần dữ liệu Etsy ở quy mô lớn hoặc cần thu thập định kỳ. Nếu bạn đang xây hệ thống phân tích sản phẩm hoặc theo dõi dữ liệu từ nhiều nguồn, API và dataset có thể giúp giảm đáng kể phần hạ tầng phải tự xây.
6.2 Oxylabs
Oxylabs có Etsy Scraper trong E Commerce Scraper API, kết hợp khả năng thu thập dữ liệu với hệ thống proxy. Bạn có thể gửi yêu cầu qua API và nhận dữ liệu đã được xử lý dưới dạng JSON để tiếp tục đưa vào hệ thống của mình.
Dữ liệu có thể bao gồm tên sản phẩm, giá, tiền tệ, hình ảnh, danh mục, thông tin seller, đánh giá, vị trí giao hàng và tình trạng hàng. Dịch vụ cũng có các tùy chọn liên quan đến quốc gia, user agent và thiết bị.
Ưu điểm
- Có hướng dẫn và ví dụ code riêng cho Etsy.
- JSON được tách sẵn.
- API và proxy nằm chung một nhà cung cấp.
Hạn chế
- Cần kiểm tra trường dữ liệu cụ thể trước khi triển khai.
- Phụ thuộc vào hệ thống và giới hạn của nhà cung cấp.
- Có thể dư thừa nếu nhu cầu chỉ là một vài listing.
Phù hợp với ai?
Nếu bạn muốn tập trung vào phần xử lý dữ liệu thay vì tự quản lý proxy và request, Oxylabs có thể giúp rút bớt phần việc kỹ thuật này. Cách tiếp cận này đặc biệt phù hợp với những quy trình đã có sẵn hệ thống xử lý dữ liệu ở phía sau.
6.3 ScraperAPI
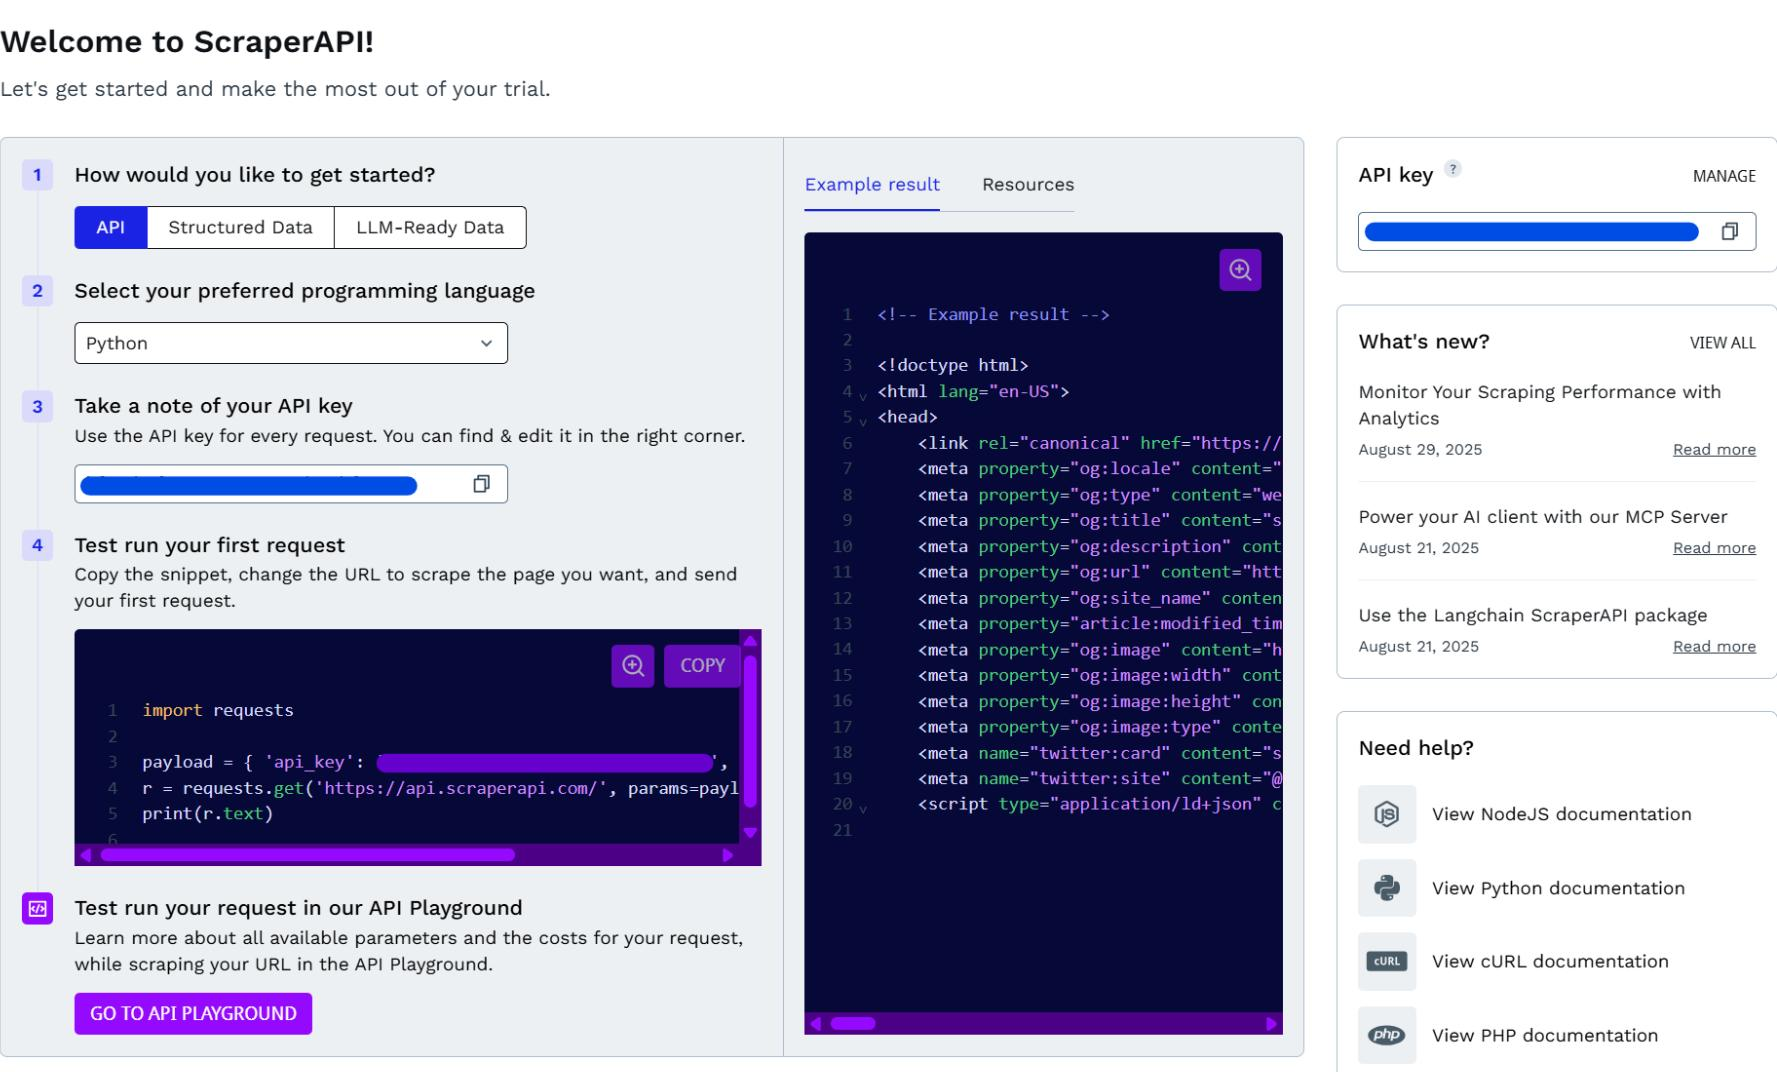
ScraperAPI hoạt động theo cách khá đơn giản. Bạn gửi URL Etsy cần thu thập, dịch vụ xử lý request và trả về HTML để bạn tiếp tục phân tích bằng code.
Dịch vụ có hướng dẫn sử dụng với Etsy và hỗ trợ lựa chọn IP, header hoặc quốc gia trong quá trình gửi request. Một số trường hợp cũng có thể xử lý CAPTCHA ở phía dịch vụ.
Ưu điểm
- Tích hợp đơn giản, chỉ cần đổi URL gọi.
- Có hướng dẫn Etsy bằng Python để làm theo.
- Dùng được cho nhiều website khác.
Hạn chế
- Kết quả là HTML thô, bạn phải tự viết bộ tách dữ liệu. Class CSS trong ví dụ mẫu có thể đổi khi Etsy sửa giao diện.
- Không hợp với tác vụ cần đăng nhập hoặc điền form.
- Phạm vi chọn quốc gia có thể phụ thuộc gói, cần kiểm tra.
Phù hợp với ai?
ScraperAPI phù hợp khi bạn đã quen với Python và muốn giữ phần xử lý dữ liệu ở phía mình. Dịch vụ đảm nhiệm phần gửi request, còn bạn có thể dùng BeautifulSoup hoặc công cụ tương tự để lấy đúng những trường cần thiết.
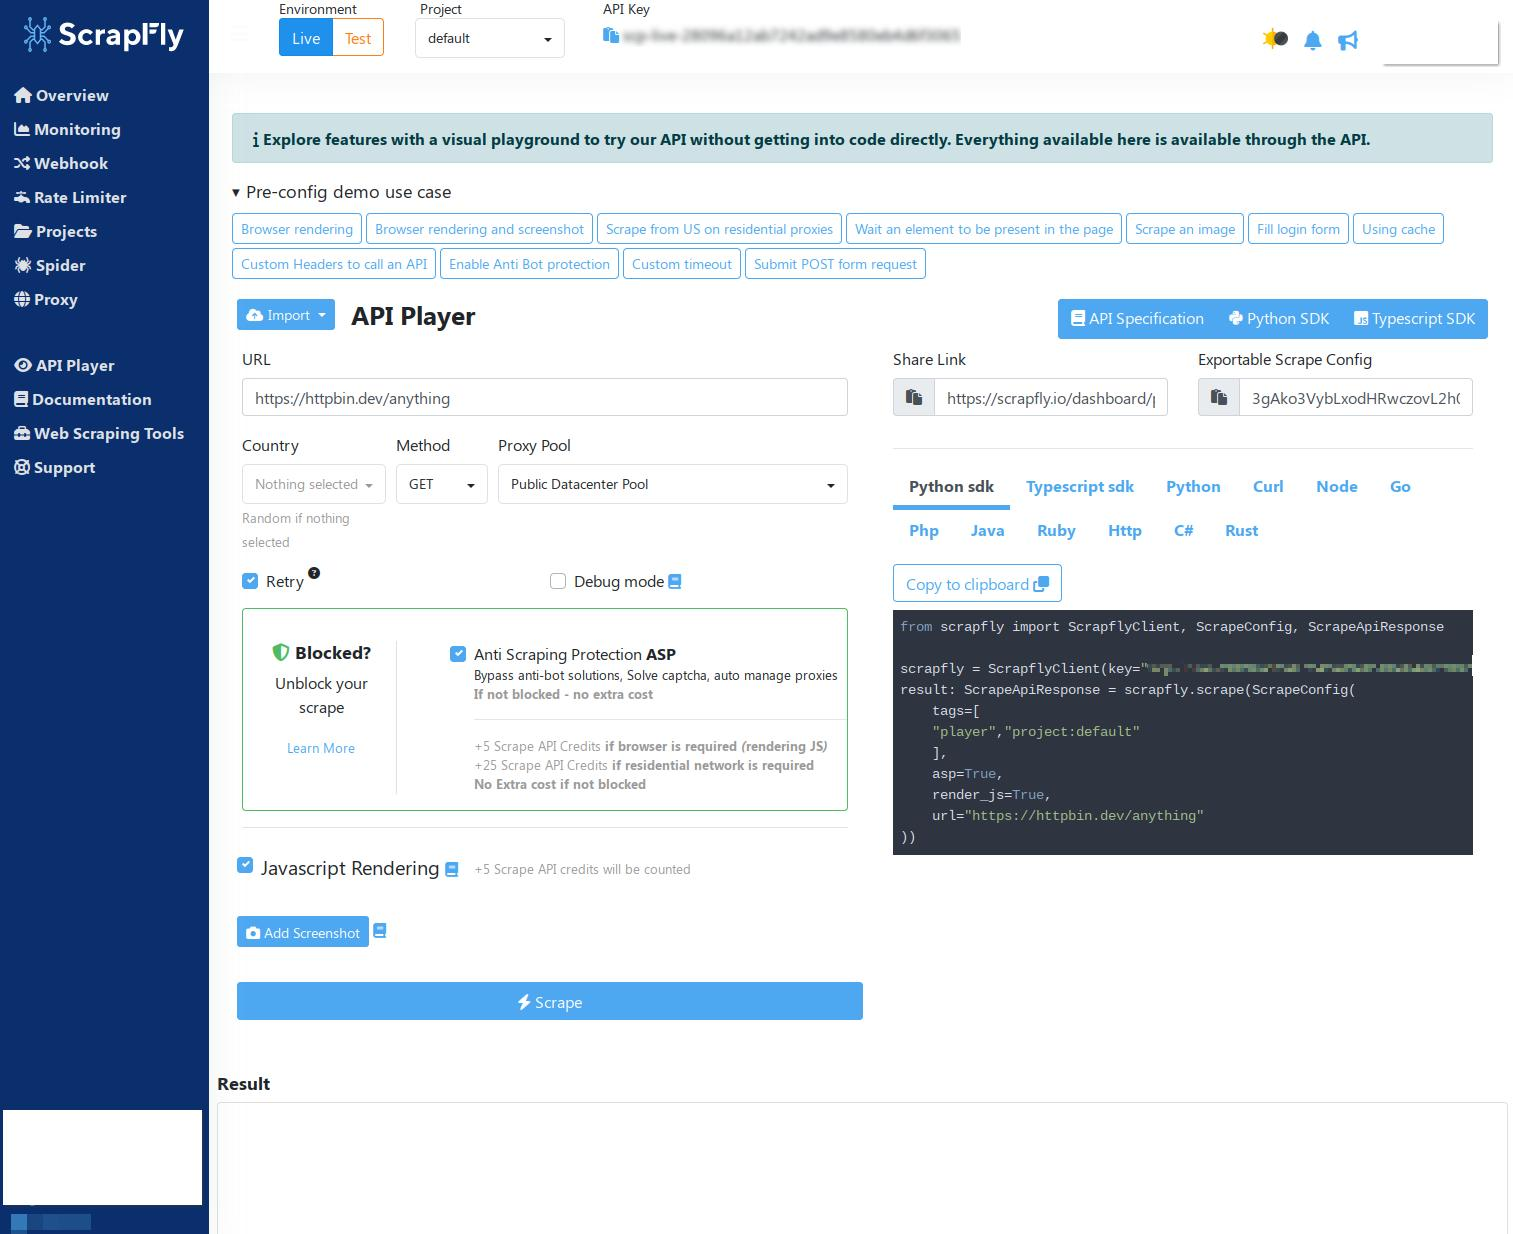
6.4 Scrapfly
Scrapfly cung cấp API với các tính năng như proxy, xử lý chống bot và render JavaScript. Dịch vụ cũng có hướng dẫn cào dữ liệu Etsy bằng Python, nên bạn có thể đưa nó vào scraper đang xây dựng thay vì phải tự xử lý toàn bộ phần hạ tầng.
Bạn gửi URL Etsy qua API, chọn các tùy chọn cần thiết rồi nhận về HTML hoặc dữ liệu để tiếp tục xử lý. Scrapfly cũng cung cấp SDK cho nhiều môi trường lập trình.
Ưu điểm
- Có sẵn xử lý chống bot và JavaScript.
- SDK nhiều ngôn ngữ và ví dụ code Etsy.
- Chọn được quốc gia truy cập.
Hạn chế
- Chi phí mỗi request tăng khi bật chống bot, render JavaScript và proxy dân cư.
- Gói khởi điểm giới hạn số request chạy song song.
- Vẫn phải tự làm sạch dữ liệu sau khi nhận kết quả.
Phù hợp với ai?
Scrapfly sẽ hợp lý hơn khi bạn đã có scraper riêng nhưng không muốn tự xây toàn bộ phần hạ tầng phía sau. API xử lý những phần như proxy, JavaScript và chống bot, còn bạn vẫn chủ động với code và cách xử lý dữ liệu Etsy.
6.5 So sánh dịch vụ scraping API cho Etsy
Bốn dịch vụ trên có cách tiếp cận khá khác nhau. Bảng dưới đây giúp bạn hình dung nhanh điểm khác biệt trước khi chọn phương án phù hợp:
| Tool | Etsy scraper có sẵn | API | Proxy | Dễ triển khai | Phù hợp |
|---|---|---|---|---|---|
| Bright Data | ✓ (3 scraper riêng) | ✓ | Writer xác nhận | Trung bình | Scale lớn, cần nhiều trường dữ liệu |
| Oxylabs | ✓ (Etsy Scraper) | ✓ | ✓ (Residential Proxies) | Trung bình | Team cần API và proxy cùng một nơi |
| ScraperAPI | ✓ (trang Etsy riêng, trả HTML thô) | ✓ | ✓ (dịch vụ tự chọn IP) | Dễ | Developer tích hợp nhanh, có sẵn code phân tích HTML |
| Scrapfly | Chưa xác nhận (có hướng dẫn Etsy) | ✓ | ✓ (proxy dân cư đi kèm) | Trung bình | Developer chạy crawl ổn định |
Nếu bạn chỉ cần lấy một lượng nhỏ dữ liệu, Python hoặc công cụ không cần code thường đã đủ dùng. Khi cần thu thập dữ liệu với số lượng lớn, scraping API sẽ giúp bạn xử lý proxy, JavaScript và các vấn đề khi truy cập trang dễ hơn.
7. So sánh nhanh 5 cách cào dữ liệu Etsy
Mỗi cách cào dữ liệu Etsy có điểm mạnh khác nhau. API chính thức thiên về dữ liệu có cấu trúc và quy trình ổn định, trong khi Python và trình duyệt tự động cho phép bạn chủ động hơn về cách thu thập. Công cụ không cần code phù hợp với nhu cầu đơn giản, còn scraping API giúp giảm phần việc kỹ thuật khi cần mở rộng.
| Phương pháp | Độ khó triển khai | Khả năng vượt chặn | Độ ổn định lâu dài | Phù hợp quy mô nào | Mức độ tuân thủ |
|---|---|---|---|---|---|
| API chính thức (Etsy Open API v3) | Thấp | Không cần vượt chặn (đi đường chính thức) | Cao nếu duy trì đủ điều kiện | Seller quản lý shop của mình, đội cần dữ liệu ổn định | Cao theo điều khoản API |
| Công cụ không cần code | Thấp | Tùy từng công cụ | Trung bình, phụ thuộc người bảo trì | Nhỏ đến vừa | Cần đọc điều khoản Etsy |
| Python (Requests và BeautifulSoup) | Cao | Thấp, dễ bị DataDome chặn | Thấp, dễ hỏng khi HTML đổi | Dự án nhỏ | Cần đọc điều khoản Etsy |
| Trình duyệt tự động | Cao | Trung bình, cần xử lý môi trường | Trung bình | Trang cần JavaScript, nhiều phiên song song | Cần đọc điều khoản Etsy |
| Dịch vụ scraping API | Thấp đến trung bình | Trung bình đến cao, tùy nhà cung cấp | Trung bình đến cao | Quy mô lớn | Cần đọc điều khoản Etsy |
Gợi ý chọn theo quy mô
- Vài chục listing: Công cụ không cần code hoặc một script Python đơn giản thường đã đủ cho nhu cầu nghiên cứu sản phẩm, kiểm tra giá hoặc phân tích listing.
- Vài nghìn listing: Python hoặc trình duyệt tự động cho phép bạn chủ động hơn về cách thu thập và xử lý dữ liệu. Nếu cần chạy thường xuyên, scraping API cũng là một lựa chọn đáng cân nhắc.
- Hàng chục nghìn listing: Scraping API hoặc trình duyệt tự động sẽ phù hợp hơn khi cần mở rộng quy trình và chạy nhiều phiên.
- Dữ liệu nằm trong Etsy Open API: Nếu API đã cung cấp đúng loại dữ liệu bạn cần và bạn đáp ứng điều kiện sử dụng, nên ưu tiên cách này thay vì tự xây scraper cho website.
Quy mô chỉ là một phần khi lựa chọn. Bạn cũng nên cân nhắc dữ liệu cần lấy, tần suất thu thập, khả năng lập trình và mức độ kiểm soát muốn có đối với toàn bộ quy trình.
8. Mẹo cào dữ liệu Etsy an toàn, hạn chế bị chặn
Etsy có các cơ chế kiểm soát truy cập để phát hiện lưu lượng truy cập bất thường. Vì vậy, việc gửi quá nhiều yêu cầu trong thời gian ngắn hoặc chạy nhiều phiên cùng lúc có thể khiến tài khoản Etsy bị đình chỉ, ảnh hưởng đến quá trình thu thập dữ liệu. Bốn việc dưới đây giúp giảm gián đoạn.
Etsy có cơ chế kiểm soát truy cập tự động. Khi gửi quá nhiều yêu cầu trong thời gian ngắn, bạn có thể gặp CAPTCHA, lỗi 403 hoặc bị chặn IP. Bốn việc dưới đây giúp giảm gián đoạn.
- Hiểu Etsy nhận diện truy cập tự động thế nào: IP, fingerprint, tần suất và hành vi đều có thể là tín hiệu, cùng với cookie và phiên truy cập. Một số nguồn ghi trang tìm kiếm được bảo vệ chặt hơn trang listing, và có công cụ dùng URL danh mục thay cho URL tìm kiếm. Vì vậy nên bắt đầu từ trang listing hoặc danh mục, giữ tần suất vừa phải và thử với số ít trước.
- Chọn proxy phù hợp, tránh proxy miễn phí: Proxy chất lượng thấp hoặc dùng chung một IP cho mọi request dễ bị chặn sớm.
- Giữ fingerprint và phiên làm việc nhất quán: Khi dùng trình duyệt tự động, user agent, hệ điều hành và múi giờ nên khớp với nhau và với IP. Nếu chạy nhiều phiên song song, mỗi phiên nên có môi trường riêng như đã nói ở phần 5.
- Đọc điều khoản và cân nhắc pháp lý: Các nguồn hiện có nói khác nhau, có nơi ghi điều khoản của Etsy hạn chế hoặc không cho phép rõ ràng truy cập tự động, có nơi cho rằng thu thập dữ liệu công khai nhìn chung ít rủi ro hơn. Hãy đọc điều khoản và robots.txt của Etsy trước khi triển khai. Tránh thu thập hoặc dùng dữ liệu cá nhân như tên người mua trong review, và không dùng dữ liệu cào được để sao chép sản phẩm của người bán. Bài viết này không phải tư vấn pháp lý, nếu dùng cho mục đích thương mại bạn nên hỏi ý kiến chuyên gia.
Thực hiện từng bước và kiểm tra kết quả trước khi mở rộng sẽ giúp bạn kiểm soát tốt hơn cả chất lượng dữ liệu lẫn quá trình thu thập. Đây cũng là cách hạn chế những lỗi có thể khiến dữ liệu bị thiếu hoặc sai ở bước xử lý sau.
Xem thêm: Top nhà cung cấp proxy Etsy nên dùng để nuôi tài khoản năm 2026
9. Sai lầm thường gặp khi cào dữ liệu Etsy
Một số lỗi trong cách thiết lập và vận hành scraper có thể khiến dữ liệu thiếu, sai hoặc ảnh hưởng đến tài khoản. Ba trường hợp bạn nên tránh gồm:
- Dùng tài khoản shop chính để cào: Nếu cào khi đang đăng nhập, tài khoản bán hàng của bạn có thể bị ảnh hưởng.
- Chạy quy mô lớn ngay và phụ thuộc vào class CSS dễ đổi: Hãy thử với vài listing trước. Ưu tiên dữ liệu có cấu trúc nhúng trong trang, lưu kết quả trung gian, kiểm tra dữ liệu trùng và các trường bị trống trước khi phân tích.
- Dùng một phương pháp cho mọi quy mô và mọi loại trang: Trang listing, tìm kiếm, shop và review khác nhau về mức bảo vệ và cách lấy dữ liệu. Chọn phương pháp theo bảng ở phần 7 thay vì dùng chung một cách cho tất cả.
Tránh những lỗi này ngay từ đầu sẽ giúp quy trình cào dữ liệu Etsy dễ kiểm soát hơn, đồng thời hạn chế việc phải xử lý lại dữ liệu hoặc điều chỉnh scraper khi mở rộng.
10. Kết luận
Cào dữ liệu Etsy không nhất thiết phải bắt đầu bằng một hệ thống phức tạp. Điều quan trọng là xác định bạn cần lấy dữ liệu gì, số lượng bao nhiêu và muốn tự kiểm soát đến mức nào. Từ đó, bạn có thể chọn API chính thức, công cụ không cần code, Python, trình duyệt tự động hoặc scraping API.
Với vài chục listing, một công cụ có sẵn hoặc script Python đơn giản có thể đáp ứng nhu cầu. Khi dữ liệu tăng lên hàng nghìn hoặc hàng chục nghìn listing, việc lựa chọn phương pháp phù hợp sẽ giúp quá trình thu thập dễ quản lý hơn và hạn chế các vấn đề phát sinh.
Dù chọn cách nào, hãy bắt đầu với quy mô nhỏ, kiểm tra chất lượng dữ liệu và xác định rõ mục đích sử dụng trước khi mở rộng. Khi quy trình đã ổn định, bạn có thể tăng dần quy mô để phục vụ nghiên cứu sản phẩm, theo dõi giá hoặc phân tích thị trường Etsy.
Có thể bạn quan tâm:
- 30+ sản phẩm kỹ thuật số nổi bật nhất để bán trên Etsy
- Có được mở nhiều cửa hàng trên Etsy không? Hướng dẫn cụ thể
- Làm thế nào để scrape eBay như một chuyên gia?
- Hướng dẫn lấy dữ liệu từ trang Khám phá Instagram: Những công cụ và mẹo bạn cần biết
- Amazon scraper: So sánh các phương pháp cào dữ liệu Amazon
11. FAQ
1. Cào dữ liệu Etsy có hợp pháp không?
Điều này phụ thuộc vào loại dữ liệu, cách thu thập và mục đích sử dụng. Bạn nên kiểm tra điều khoản của Etsy và các quy định về quyền riêng tư trước khi triển khai. Đặc biệt, dữ liệu review có thể chứa tên người mua hoặc thông tin liên quan đến tài khoản, nên cần thận trọng khi thu thập và sử dụng.
2. Nên dùng Etsy API hay cào trực tiếp?
Nếu dữ liệu cần lấy có trong Etsy Open API và bạn đáp ứng điều kiện sử dụng, API là lựa chọn phù hợp khi cần dữ liệu có cấu trúc và quy trình ổn định. Cào trực tiếp có thể lấy thêm dữ liệu hiển thị trên website nhưng cần tự xử lý nhiều vấn đề kỹ thuật hơn.
3. Cào dữ liệu Etsy bằng Python có khó không?
Với một lượng nhỏ dữ liệu, bạn có thể bắt đầu bằng Requests và BeautifulSoup. Khi cần thu thập nhiều listing hoặc xử lý các trang có nội dung động, script sẽ cần thêm nhiều bước và trở nên phức tạp hơn.
4. Cào dữ liệu Etsy có bị chặn không?
Có thể. Việc truy cập với tần suất cao hoặc chạy nhiều phiên cùng lúc có thể khiến quá trình thu thập bị giới hạn. Bạn nên kiểm soát tốc độ truy cập và tăng quy mô từng bước.
5. Có cần antidetect browser để cào dữ liệu Etsy không?
Không phải lúc nào cũng cần. Antidetect browser hữu ích hơn khi bạn cần chạy nhiều phiên trình duyệt và muốn tách riêng fingerprint, cookie hoặc proxy cho từng phiên.